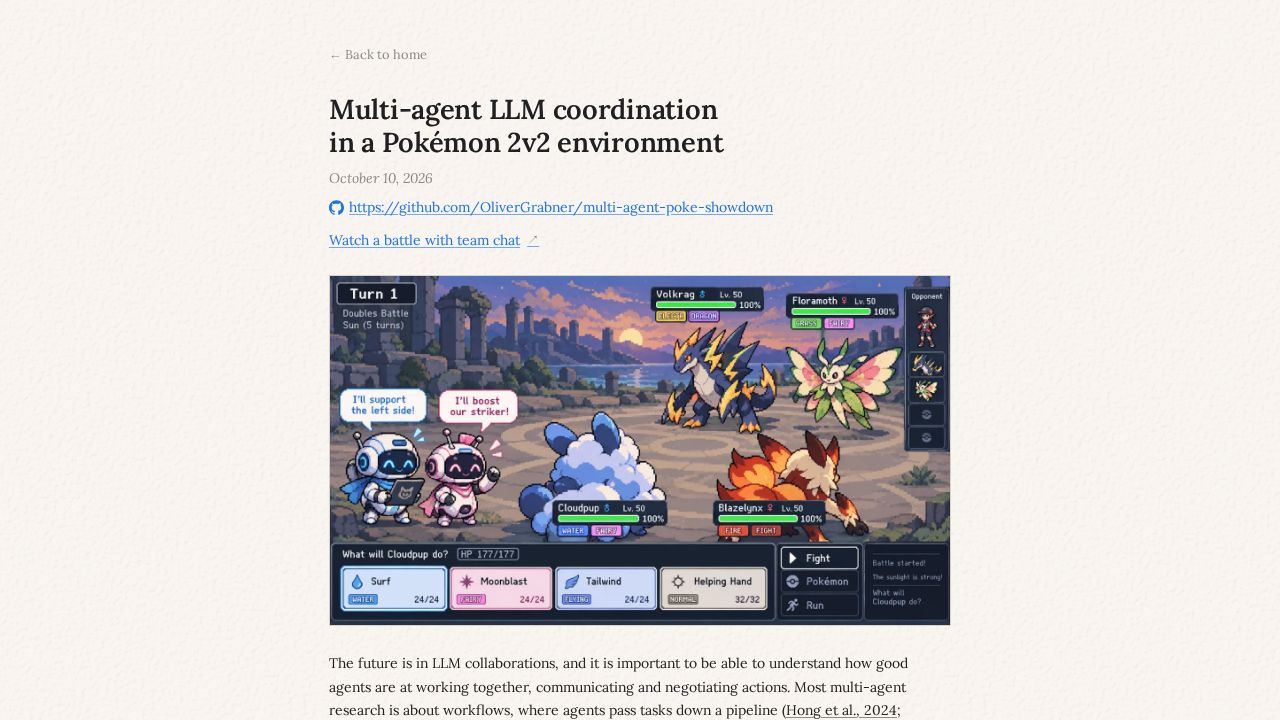
研究者たちは、人工知能にとって独自の課題を提示するバトルシミュレーター、Pokémon Showdownにおける大規模言語モデル(LLM)エージェントの有用性をテストしています。チェスのような完全情報ゲームとは異なり、Pokémonのバトルには、相手の特定の技セットや持ち物など、隠された変数が含まれます。この実験では、戦術的な計画と隠された情報を解釈する能力の両方を必要とするゲームのメカニズムを、これらの汎用言語モデルがいかにナビゲートできるかを探求しています。
現在の実装では、テスト中の一貫性を確保するために、固定されたランダムシードのチームプールを使用しています。エージェントのパフォーマンスはアマチュアのプレイヤーよりも優れていますが、人間の対戦相手に敗北することもあります。このプロジェクトは、多段階のプロセスを推論し、動的な環境で意思決定を行うことができるシステムである「エージェント」として、汎用LLMの能力が高まっていることを強調しています。これは、高いパフォーマンスを達成するために専用のエンジンや大規模な自己対戦の反復を必要とすることが多い、従来の強化学習のアプローチとは対照的です。
このプロジェクトに関する議論からは、いくつかの技術的なニュアンスと限界が明らかになっています。興味深い点の一つは、モデル内における「推論」の役割です。エージェントの内部メッセージがより深い推論の代理として機能しているのか、あるいは単にゲームの現在の状態を処理しているだけなのかは不明です。さらに、ゲームのメカニズムにはダメージ判定などの半ランダムな要素が含まれており、エージェントが結果を完璧に予測する能力を複雑にすることがあります。現在、エージェントは制御された環境で動作していますが、最終的な目標は、これらのモデルが、専用の強化学習技術を用いてすでにリーダーボードのトップに到達している専門的なボットと比較して、どの程度の性能を示すかを確認することです。