「意思決定の階層」という概念は、異なるモデルをメモリのような階層のレイヤーとして扱うことで、人工知能を活用するための構造的なアプローチを提案するものです。このフレームワークでは、最下層(L-cache)は手書きのルールと過去の回答の正確な意味的一致で構成されます。中間層(RAM)は、スコアや確率のような明確に定義された出力を提供するJevなどの専門的な意思決定モデルによって占められます。最上層(disk)は大規模言語モデル(LLM)であり、最終的なフォールバックは人間の介入です。各レベルは、自身が最も自信を持って処理できる内容を扱い、処理できない「ミス」を、より計算コストの高い、あるいは複雑な下のレイヤーへと渡すように設計されています。
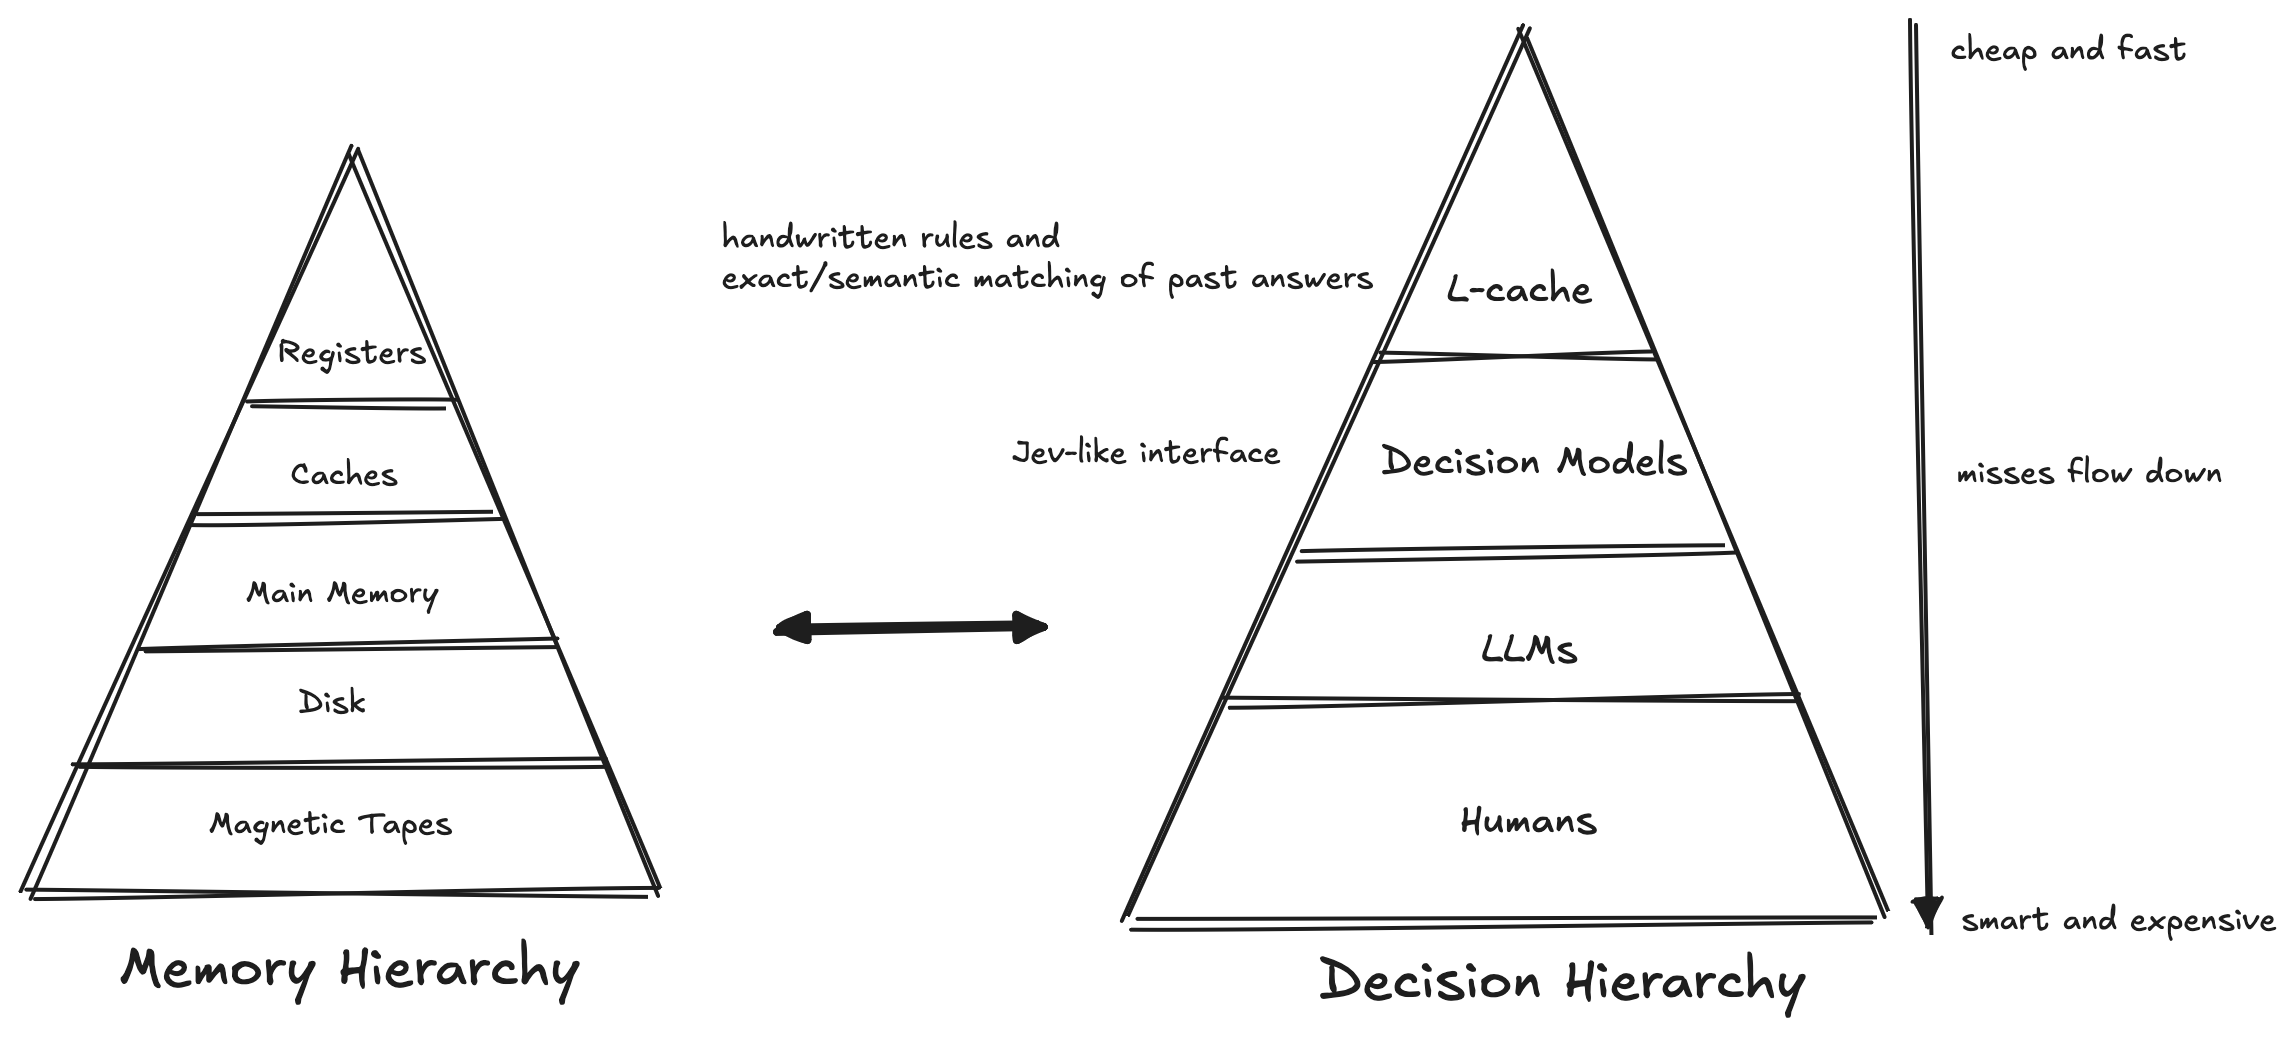
この図は、異なるモデルが特定の自信レベルを処理する多層的なアプローチを視覚化したものである。
より安価な意思決定モデルからより高価なLLMへいつ移行すべきかを判断するために、著者は「Chowのルール」に基づく数学的フレームワークを導入しています。このルールは、エラーのコストと次のレベルの処理費用の比率を比較することで、損益分岐点を算出します。例えば、意思決定モデルの自信度がわずか60%である場合、システムは、誤った回答のリスク(そのエラーのコストで重み付けされたもの)が、LLMの料金および予想されるエラー率よりも高いかどうかを判断しなければなりません。エラーのコストが非常に高い場合、システムは正確性を優先するため、LLMの料金はそれほど重要ではなくなります。逆に、エラーのコストが低い場合は、クエリをエスカレートさせるかどうかの主な要因として処理料金が重要になります。
このフレームワークはさらに、異なるカテゴリ間で変動するエラーコストを考慮することで洗練されています。法的なルーティングにおける間違いは、技術的なルーティングにおける間違いよりも大幅にコストが高くなる可能性があるため、このルールはカテゴリ固有のオーバーヘッドを組み込むように調整されます。結果として得られるモデルは、任意のクエリに対する最適な経路が、正解の確率と、それを生成するために必要な知能の経済的コストとの間の、双曲線形状のトレードオフであることを示唆しています。このアプローチは単純な自信度の閾値を超え、AIの展開を、処理費用とミスの両方の総コストを最小限に抑ることを目的とした一連の経済的決定として扱うものです。