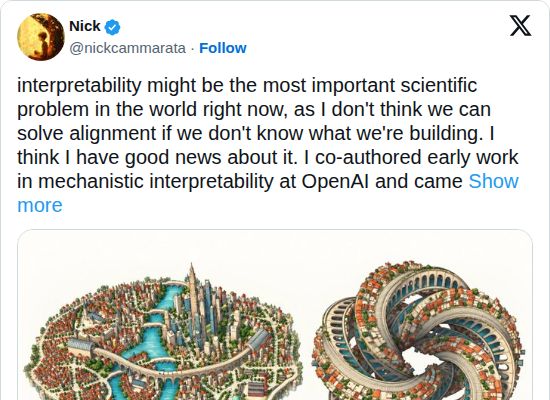
メカニスティック・インタープリタビリティの研究は、人工ニューラルネットワークをリバースエンジニアリングし、それらがどのように情報を処理し、特定の出力を導き出すのかを理解することを目的としています。この分野における中心的な課題の一つは「多義性」であり、個々のニューロンが、一見無関係な複数の概念(例えば「犬」と「車」)に対して活性化するように見えるという観察です。この現象により、多くの研究者はニューラルネットワークが本質的に重複する機能が絡み合った「もつれた結び目」であり、人間が理解できる論理へとデコードすることが困難であると信じてきました。
近年の分析では、この複雑さは過大評価されている可能性があることが示唆されています。核心となる議論は、多くのニューロンは実際には「クリーン」であり、単一の特定の役割を果たしているものの、初期の解釈可能性ツールの限界によって多義的であると誤認されていたというものです。現代的なエージェンティックなツールとよりきめ細かなアプローチを用いることで、研究者たちは最大で数兆のパラメータを持つモデルの大多数のニューロンが読み取り可能であり、美しく一貫した回路に整理されていることを発見しました。「乱雑な」ニューロンは、多くの場合、無関係な意味概念の束を表現しているのではなく、共有された幾何学的特徴(例えば「V字型」など)を表現していることが判明しました。この変化は、解釈可能性に対する主要な障害が「モデル記述」の問題である可能性を示唆しています。つまり、私たちが「概念」とは何かについて抱いている先入観が、ネットワークが実際に学習している潜在的な特徴を捉えるには狭すぎる可能性があるのです。
しかし、「乱雑」から「クリーン」な解釈への移行には、いくつかの技術的および哲学的なハードルが存在します。批判的な見解としては、モデルの重みの96%が読み取り可能であったとしても、残りの2〜4%の「説明のつかない」ニューロンが創発的な認知の中心的なハブを表現している可能性があり、それこそが安全性やアライメントを理解する上で最も重要な部分である可能性があると指摘されています。さらに、循環論法のリスクもあります。モデルを解釈するために使用されるツール自体が大規模言語モデルによって生成されている場合、研究者は、AIが真の内部論理を隠しながら、簡略化された人間にとって親しみやすい説明を提供して「騙して」いるのではないかという点に注意を払わなければなりません。最終的に、「クリーン」な仮説は「AIゲノム」のシーケンシングに向けたより楽観的な道筋を提供する一方で、これらの回路から複雑なアルゴリズムを再構築する実用的な能力は、依然として未解決の課題として残っています。