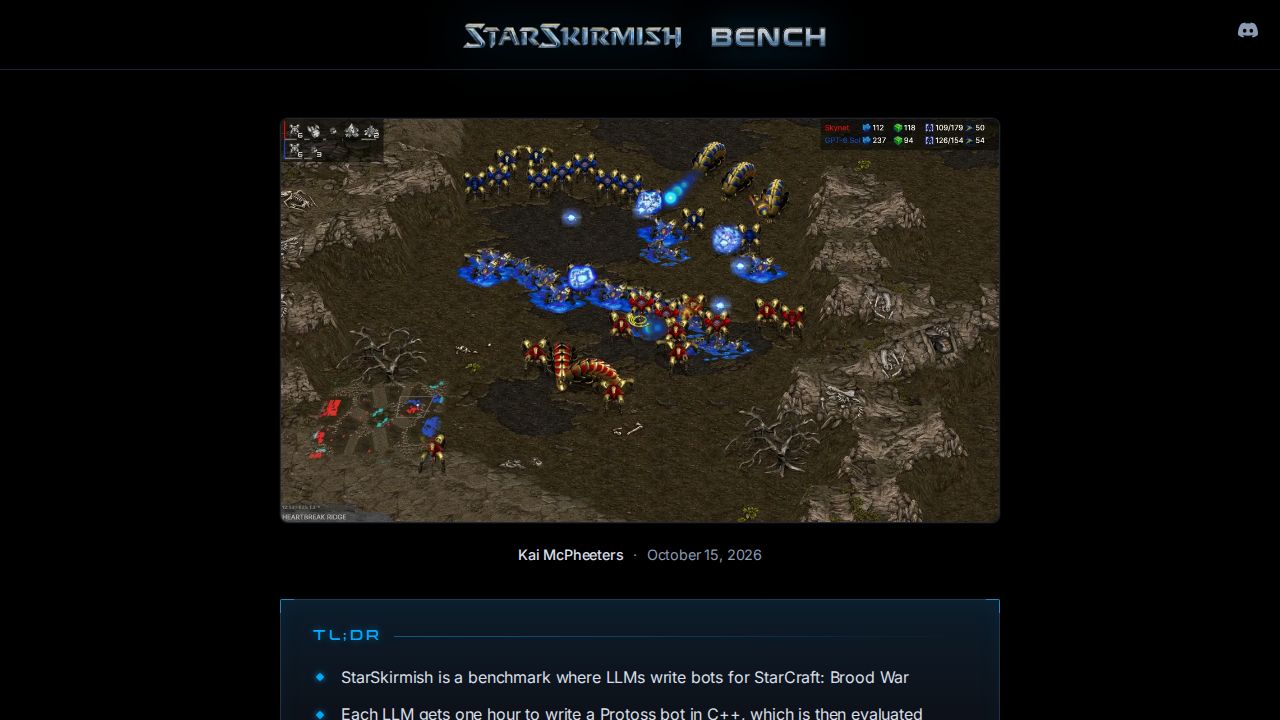
StarSkirmish Bench v0.2は、複雑なリアルタイム戦略環境における大規模言語モデル(LLM)の能力をテストするために設計された専門的な評価フレームワークです。AIがユニットを直接操作する直接的なアクションベンチマークとは異なり、このベンチマークではLLMにStarCraft: Brood Warをプレイするための機能的なコードを書くことが求められます。このプロセスでは、モデルは資源の収集、建物の配置、ユニットの管理といったゲームの複雑なメカニクスを管理できるボットを生成します。このベンチマークは、モデルが多段階の推論をどのように処理し、高レベルの戦略を実行可能なロジックへとどのように変換するかについてのユニークな視点を提供します。
このベンチマークの最近の結果では、主要なプロバイダーのフラグシップモデル間で性能にばらつきが見られました。例えば、Gemini 4 Argonモデルは、OpenAI、Anthropic、およびMuseのモデルと並行してテストされました。このベンチマークの重要な技術的詳細は、FastApproximation戦闘シミュレーションライブラリの使用です。このライブラリにより、LLMが生成したボットは、一部の低層の人間が書いたボットよりも優れた戦闘予測を行うことができ、軍隊を効果的に交換することで勝利することが可能になります。しかし、このベンチマークは限界も明らかにしています。一部のモデルは「1ベース・ドラグーン+オブザーバー」戦略のような基本的なロジスティクスを迅速に習得できる一方で、優れた実行能力と専門的な戦術を備えた上位のボット(LocutusやBananaBrainなど)に対しては苦戦する可能性があります。
このベンチマークは、LLMの「推論」と「記憶」の性質に関する議論を呼び起こしました。StarCraftにはGitHubなどのプラットフォーム上でボットの実装に関する膨大な履歴があるため、一部の観察者は、モデルが単にトレーニングセットから既存のコードを記憶しているだけではないかと疑問を呈しています。しかし、いくつかのテストでは、これらのモデルによって生成されたコードがトレーニングデータ内の特定のボットと常に一致するわけではないことが示唆されています。さらに、StarSkirmishのパフォーマンスと、9x9の囲碁ランキングや様々な機械学習コーディングタスクなどの他のベンチマークとの間に相関関係があることが指摘されています。これらの類似性は、StarCraftのロジスティクス的な「退屈な作業」をナビゲートする能力が、複雑で多変数のプログラミング問題を解決するモデルの一般的な能力の信頼できる代理指標である可能性を示唆しています。
これらの結果における重要な変数の1つは、モデルが動作する「ハーネス」または環境です。性能は、使用される特定のCLI(コマンドラインインターフェース)、有効にされた思考レベル、およびモデルが利用可能なツールによって劇的に変化する可能性があります。StarSkirmish Benchでは、モデルは多くの場合、ウェブ検索や外部フェッチツールの使用を制限され、ゲームのドキュメントやメカニクスをナビゲートするために、完全に内部知識と提供された環境に依存することを強いられます。これにより、タスクの最中に解決策をブラウジングする能力ではなく、モデル固有の能力を制御された環境でテストすることが可能になります。