推測的デコーディングは、大規模言語モデル(LLM)によるテキスト生成を高速化するために用いられる手法です。標準的なデコーディングプロセスでは、モデルは一度に1つのトークンを生成しますが、これは「メモリ帯域制限」の操作となります。つまり、GPUは数学的な計算(浮動小数点演算、またはFLOPs)を実行するよりも、モデルのパラメータをグローバルメモリからローカルメモリにロードするのを待つことに多くの時間を費やしていることを意味します。これらのステップではGPUが十分に活用されていないため、利用可能な「無駄な」計算能力が存在することになります。
推測的デコーディングは、小型で高速な「ドラフト」モデルを使用して、一度に数個のトークンのシーケンスを提案することでこの問題に対処します。次に、より大きく能力の高いモデルが、このシーケンス全体を単一のフォワードパスで検証します。大きなモデルがドラフトトークンを処理しなければならないため、実際には実行される総FLOPsは増加しますが、作業の性質が変化します。複数のトークンを同時に処理することで、操作はGPUの処理能力がフルに活用される「計算能力制限」へと変わります。低バッチサイズ(システムが複数の同時リクエストで飽和していない状態)において、この手法は、本来ならアイドル状態になるはずの「自由な」計算能力を利用することで、単一のシーケンスをより高速に完了させることを可能にします。
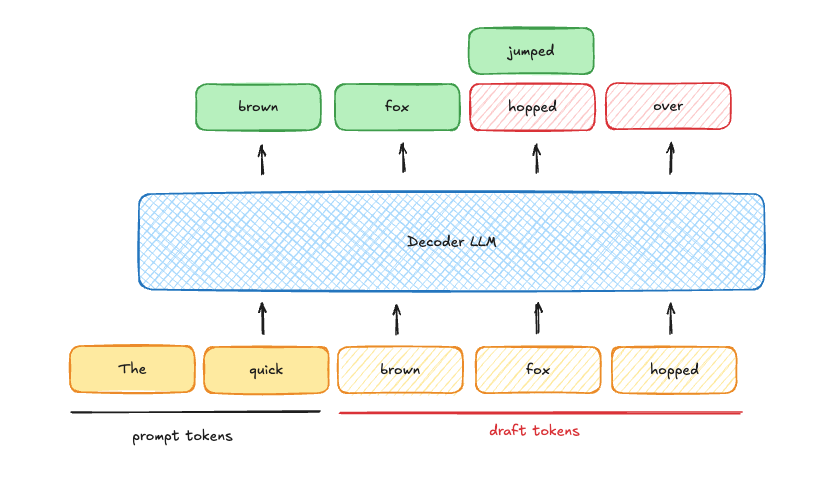
この図は、大きなモデルが複数のドラフトトークンを同時に検証する推測的デコーディングの核心的なメカニズムを示しています。
しかし、この効率は絶対的なものではなく、ドラフトトークンの「採択率」に大きく依存します。拒否されたトークンのすべては、大きなモデルが最終的に破棄された提案に対して計算サイクルを費やしたことを意味し、無駄な作業となります。これにより、「広さ」(一度に処理するシーケンスの多さ)と「深さ」(単一のシーケンスに対して推測するトークン数)の間のトレードオフが生じます。高スループット時において、バッチサイズがGPUの計算能力を飽和させるほど大きい場合、推測的デコーディングは逆効果になる可能性があります。これが、vLLMなどの一部のサービングフレームワークが、バッチサイズがある閾値に達したときに推測的デコーディングを自動的に無効にするオプションを提供している理由です。動的な推測に関する研究は、すべてのステップで固定のトークン数を使用するのではなく、現在の利用可能な計算能力に基づいてシーケンスごとの推測の「深さ」を調整することで、この問題を解決することを目指しています。
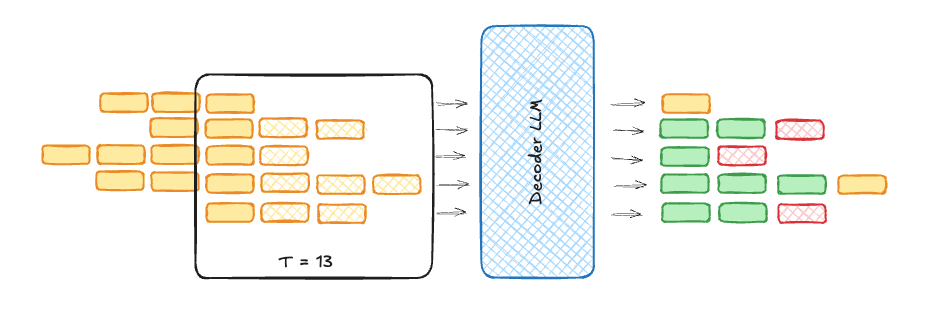
この画像は、スループットを最適化するためにシーケンスごとに推測の深さを調整する動的な推測を実演しています。
メモリ帯域制限のレイテンシを計算能力制限のスループットに置き換えるという基礎的な原理は、ロボット工学などの他の分野でも観察されます。Vision-Language-Action(VLA)モデルでは、複数の将来の動作を単一の推論ステップにグループ化する「アクションチャンキング」が使用されます。これは高次元モデルの遅いレイテンシを克服するのに役立ち、ロボットが単一の孤立した時点に反応するのではなく、一貫した一連の動きを実行できるようにします。
最終的に、推測的デコーディングの速度はハードウェアのオーケストレーションの問題です。データがすでにロードされている間に、より多くの計算を実行するというように、ワークロードをGPUの強みに合わせることで、最終的なテキストを生成するために必要な総数学的努力が増加したとしても、システムはより速い結果を達成します。