ある開発者が、大規模言語モデル(LLM)に特有のスタイル上の特徴を削ぎ落とすために特別に設計された「qwen3-4b-deslop」と名付けられたQwen3-4B-Instructモデルの修正版を公開しました。これらの「癖」には、エムダッシュの頻繁な使用、3つの項目からなる繰り返されるリスト構造、そして「delve」や「seamless」といった特定の移行フレーズが含まれます。開発者は、蒸留(distillation)とニューロン編集(neuron editing)を組み合わせることで、正確な事実情報を提供する能力を犠牲にすることなく、より人間の執筆スタイルに近いテキストを生成するモデルの構築を目指しました。
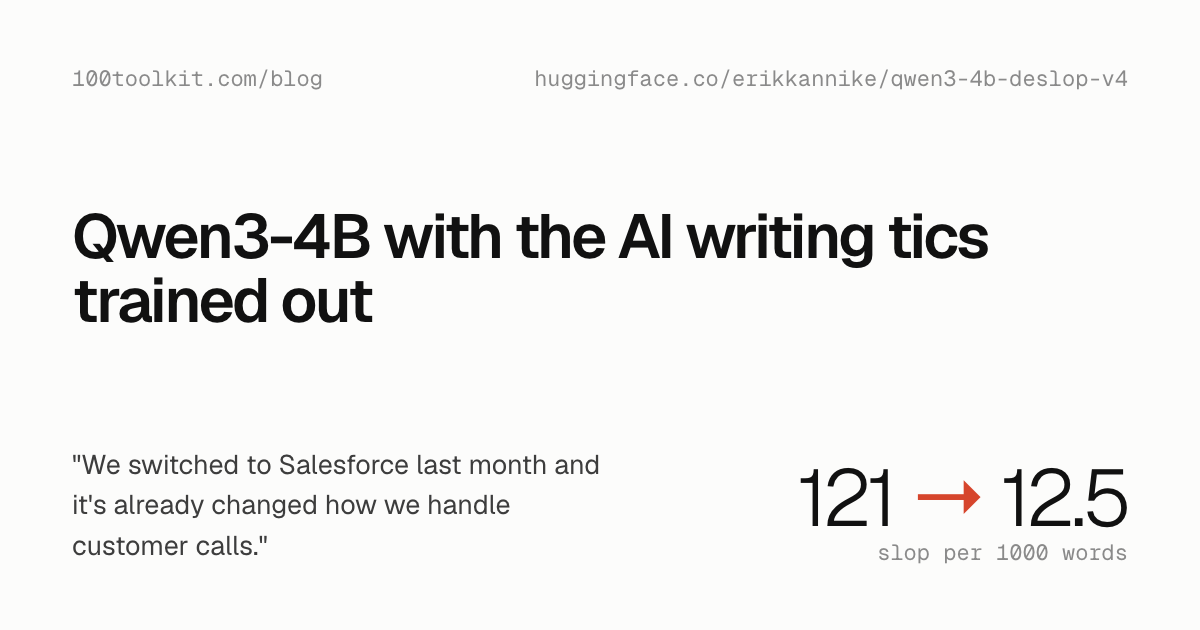
この画像は、Qwen3-4B-Instructモデルの出力から「slop」を取り除くというプロジェクトの目標を表しています。
訓練プロセスには、複数回の蒸留が含まれていました。開発者はまず、モデルの重みの中から特定の「アシスタント」としての振る舞いを特定し、「教師」モデルを使用して、一連のスタイルおよびタスク適合性のチェックを通過する高品質な回答を生成しました。注目すべき技術的ステップの一つとして「ニューロン編集」があり、そこでは「not X, but Y」という構文のような特定の言語的習慣を削除するために、4つの特定のMLP(多層パーセプトロン)ニューロンの符号を反転させました。最終的な反復では、開発者がこれらのスタイル上の癖を重み付けしてカウントするために作成した指標である「slop」を回避することに成功した161件の高品質な回答を用いてモデルを訓練しました。その結果、「slopスコア」は1000単語あたり121から12.5へと大幅に減少し、多くの出力が人間が書いた散文の範囲内のスコアを記録しました。
スタイル上のアーティファクト(不自然な痕跡)は減少したものの、このモデルにはいくつかの制限があります。開発者は、生成される散文が「平坦」または過度に宣言的なものになる可能性があり、モデルは依然として具体的な詳細を提供するために名前や場所を時折捏造(ハルシネーション)することに言及しました。さらに、このモデルは短い英語の散文では良好なパフォーマンスを発揮する一方で、コード、長文の会話、または他の言語における性能はまだ検証されていません。開発者は、この手法をより大きなモデルに拡張する計画を立てており、最終的には「アシスタント」訓練を受けていないベースモデルを使用することで、現在の反復の平坦なトーンを避けつつ、より微妙な「趣」を重みに注入できるかどうかを確認する予定です。
「deslop」モデルの技術的詳細には、LoRAアダプター(126 MB)と、ニューロン編集のための175バイトの重みカラムリストが含まれます。このモデルは、Ollamaやllama.cppなどのツールで使用できる量子化されたGGUF形式、およびHugging Face transformersライブラリで使用できるフル精度の重みの両方で利用可能です。開発者は、現在の結果は自身で作成したスタイルガイドに基づいたものであり、「de-slopped」されたテキストが元のテキストよりも真に好まれるかどうかを判断するためのブラインドテストはまだ実施されていないことを強調しています。