Bloom filterは、ある項目が集合内に存在するかどうかを判定するために使用される確率的データ構造です。これらは最小限のメモリを使用し、「確実に存在しない」または「おそらく存在する」という回答を提供するため、ディスクI/Oのような高コストな操作をスキップできることから、高性能システムにおいて非常に効率的です。例えば、Blueskyのバックエンドでは、Scyllaデータベースに対して毎秒数百万件のクエリをフィルタリングするためにこれを使用しており、リクエストの約99%においてデータベースへのヒットを正常にスキップすることに成功しています。
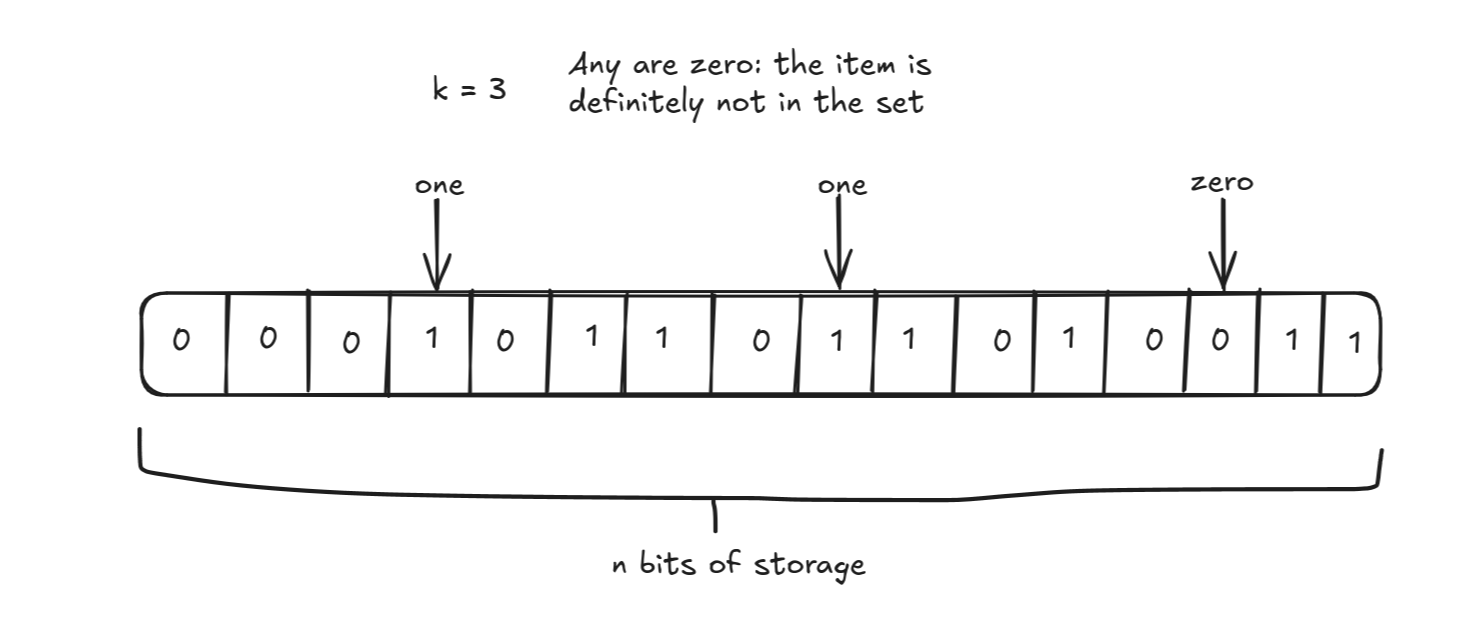
この図は、単一のゼロビットが決定的な「存在しない」という結果を提供するBloom filterの基本論理を説明しています。
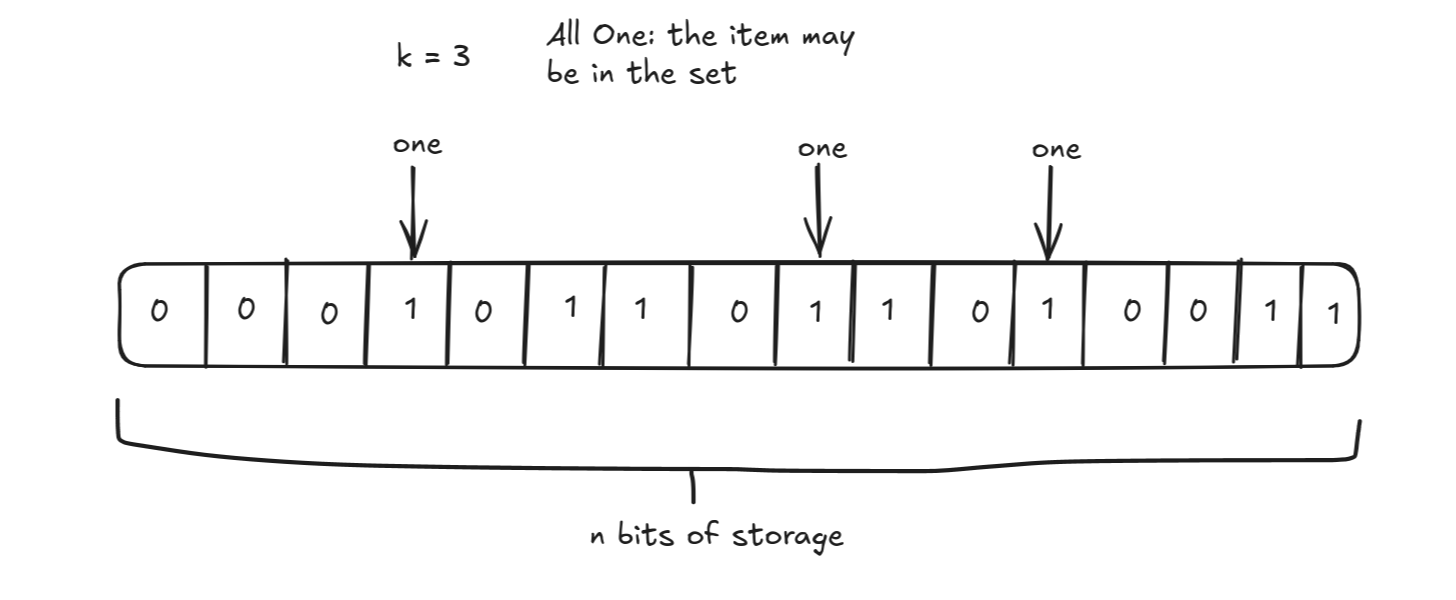
この図は、一連の「1」のビットがアイテムが存在する可能性を示唆するBloom filterの確率的な性質を実証しています。
従来のBloom filterは、ビットの配列と$k$個の異なるハッシュ関数に依存しています。キーの存在を確認するために、システムはキーを$k$回ハッシュ化し、対応するビットの位置を確認します。この手法は効果的ですが、複数の独立したハッシュを計算することは計算コストが高くなる可能性があります。これを緩和するために、開発者は多くの場合、2つのハッシュを使用して$k$個の位置を導き出す「ダブルハッシュ」を使用します。しかし、Calabro氏は、この手法でさえもマルチスレッド環境におけるミューテックスの競合など、パフォーマンスのボトルネックを引き起こす可能性があると指摘しています。Blueskyでは、ミューテックスをアトミックなCPU命令に置き換えるアトミックベースの実装に移行することでこれを解決し、デプロイ時間を90分から15分へと大幅に短縮しました。
さらなる最適化のため、Calabro氏はLu氏らによる研究に基づいた「One Hash Bloom Filter(OHBF)」を実装しました。この手法では、大きなビット配列を、互いに素のサイズの$k$個のパーティションに分割します。キーの単一のハッシュを使用して、各パーティション内のビット位置を決定します。このアプローチにより、複数のハッシュ計算の必要性がなくなります。また、この実装には、CPUキャッシュラインに合わせて64バイトのブロックを整列させるなどの低レベルの最適化も組み込まれており、ルックアップ時に発生するキャッシュミスを最大で1回に抑えることができます。この手法は大幅な高速化をもたらす一方で、空間効率のトレードオフを伴います。パーティショニングによりセグメント間で占有率が不均一になる可能性があり、低い偽陽性率を維持するためには、全体的なフィルターサイズを大きくする必要がある場合があります。
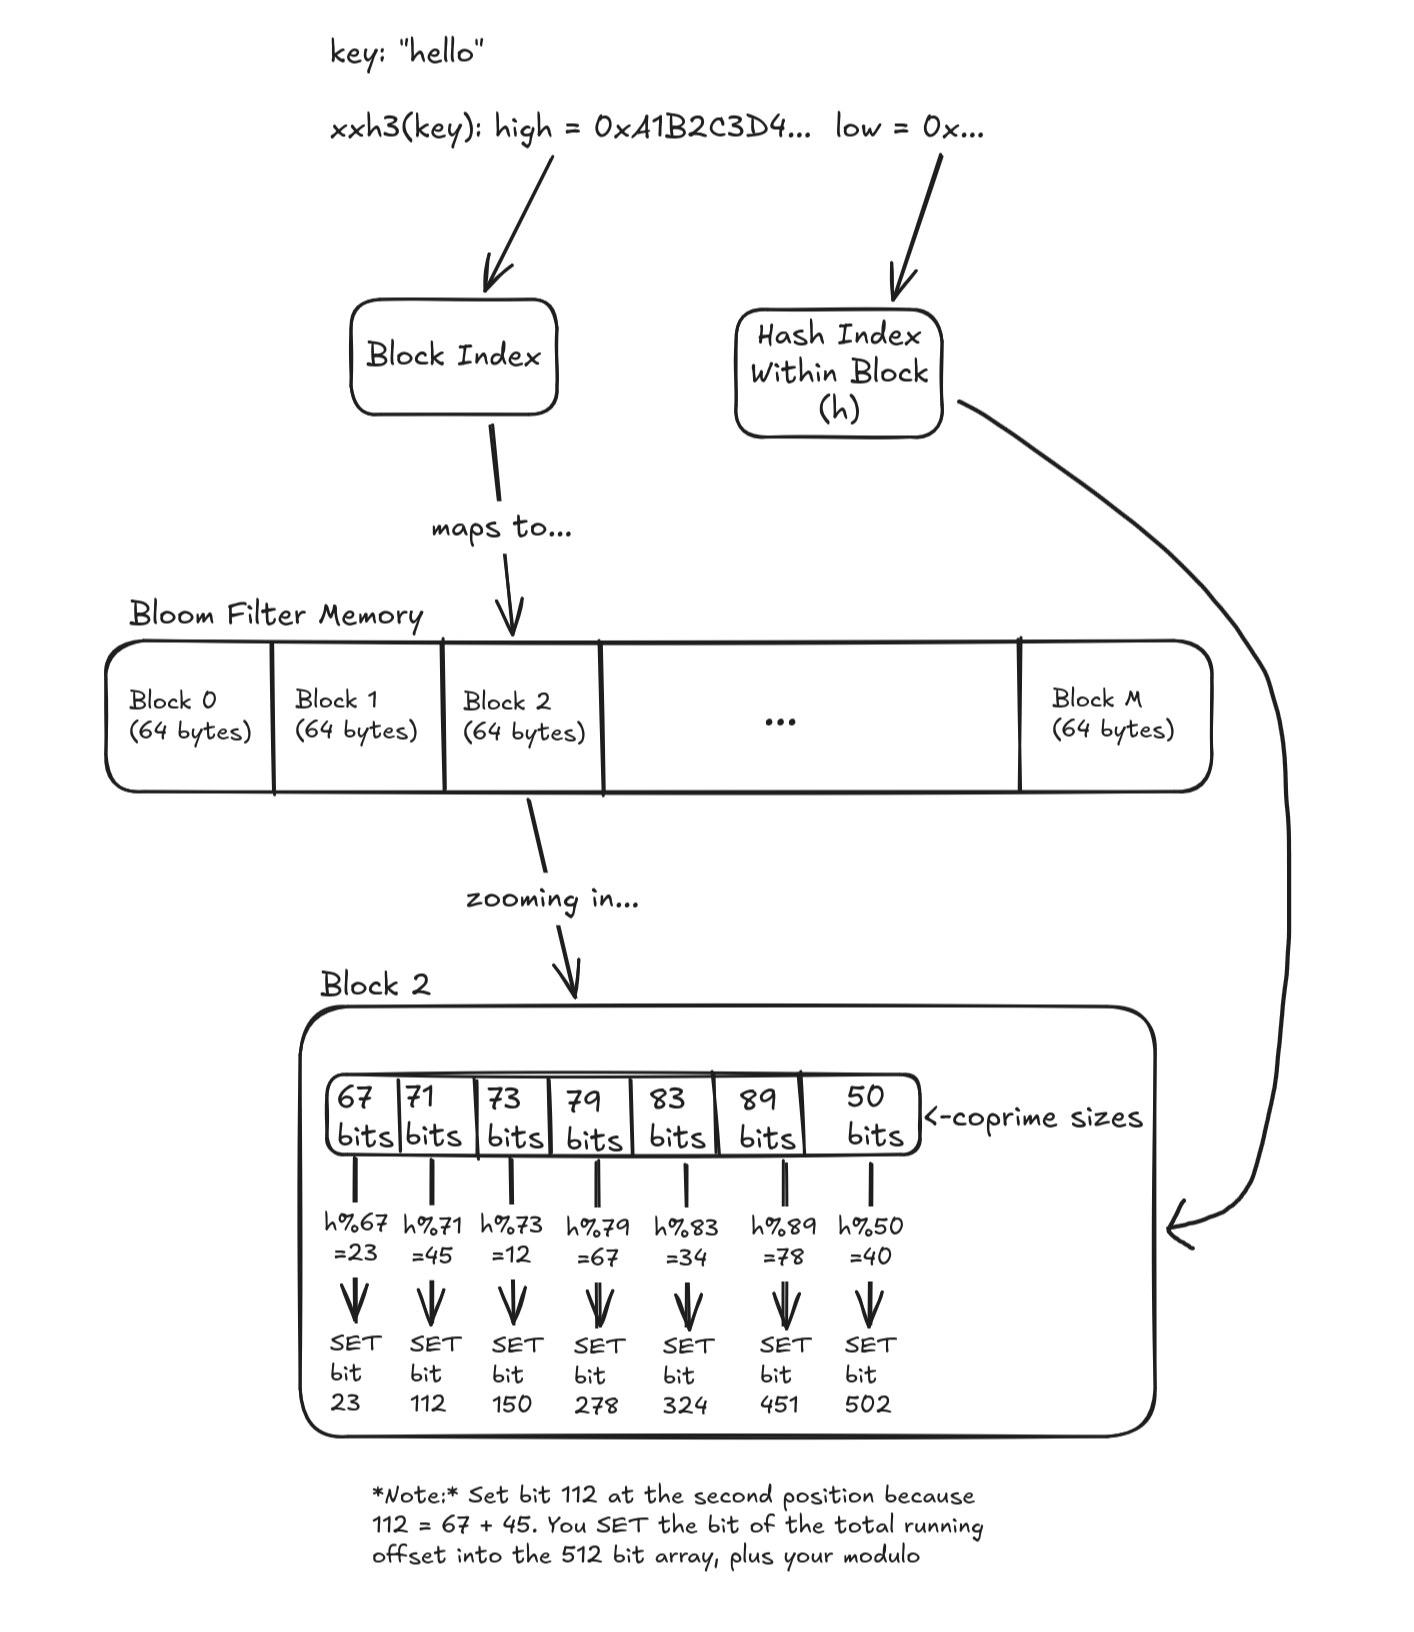
この図は、単一のハッシュを使用して互いに素のパーティション全体にわたるビット位置を決定するOne Hash Bloom Filter(OHBF)の手法を説明しています。
最後の最適化として、高コストな除算命令を必要とする剰余演算を、確認するブロックを選択するための単一の乗算(MUL)命令に置き換えています。これらの技術(ワンハッシュロジック、キャッシュ整列、および乗算ベースのインデックス)を組み合わせることで、システムはCPUサイクルとメモリレイテンシの両方を最小限に抑えつつ、高スループットなルックアップを実現します。OHBFの実装は、現在Blueskyのバックエンドおよびその高性能同期サービスであるJetstreamで稼働しています。