MiniMaxは、計算効率と「エージェント」タスクにおけるパフォーマンスのバランスを最適化するために設計された新しい大規模言語モデル(LLM)であるM3.1 Flashを正式にリリースしました。エージェントタスクとは、AIモデルが目標を達成するために、計画を立て、ツールを使用し、多段階のアクションを実行する必要があるワークフローを指します。このモデルは、標準的なMiniMax M3の高速な代替手段として位置付けられており、オンライン推論のコストを大幅に抑えつつ、ソフトウェア開発、コンピュータ操作、サイバーセキュリティにおける能力の世代的な飛躍を提供することを目指しています。
この画像は、M3.1 Flashモデルの発表と、速度とパフォーマンスのバランスという主要な価値提案を示すための主要なビジュアルとして機能します。
これらの成果を達成するために、MiniMaxは推論効率を最適化するために積極的なスパース性(sparsity)を活用しました。同社によると、このモデルは毎秒200トークン(TPS)以上の出力速度に達することができ、中央値の速度は一貫して170 TPS以上を記録しています。これらのパフォーマンス向上は、大幅な価格削減と組み合わされています。同社は、エージェントタスクにおいて、全体的な利用コストが前モデルよりも70%低くなると主張しています。価格は、入力トークン100万件あたり0.15ドル、出力トークン100万件あたり0.60ドルに設定されており、キャッシュされた入力については0.015ドルの料金が適用されます。
この画像は、第2段落で議論されているトークン速度と価格に関する技術的な最適化とパフォーマンスの向上を説明しています。
MiniMaxは、複雑な環境におけるモデルの能力を実証するために、いくつかの特定のベンチマークを強調しています。多段階の計画と財務コンプライアンスを評価するBankerToolBenchでは76.2を記録し、モデルが独立してコードを理解し、テストを通じて修正を検証する必要があるソフトウェアエンジニアリングタスクのベンチマークであるDeepSWE v1.1では73.7%を記録しました。モデルがオペレーティングシステムと相互作用し、アプリケーションを横断するタスクを行うコンピュータ操作の領域では、M3.1 FlashはOSWorld V2で61.7、Agents’ Last Exam (ALE)で29.6を記録しました。現在、このモデルはAPIおよびMiniMax M Planを通じて利用可能ですが、同社はモデルの重み(weights)は後日公開される予定であると述べています。
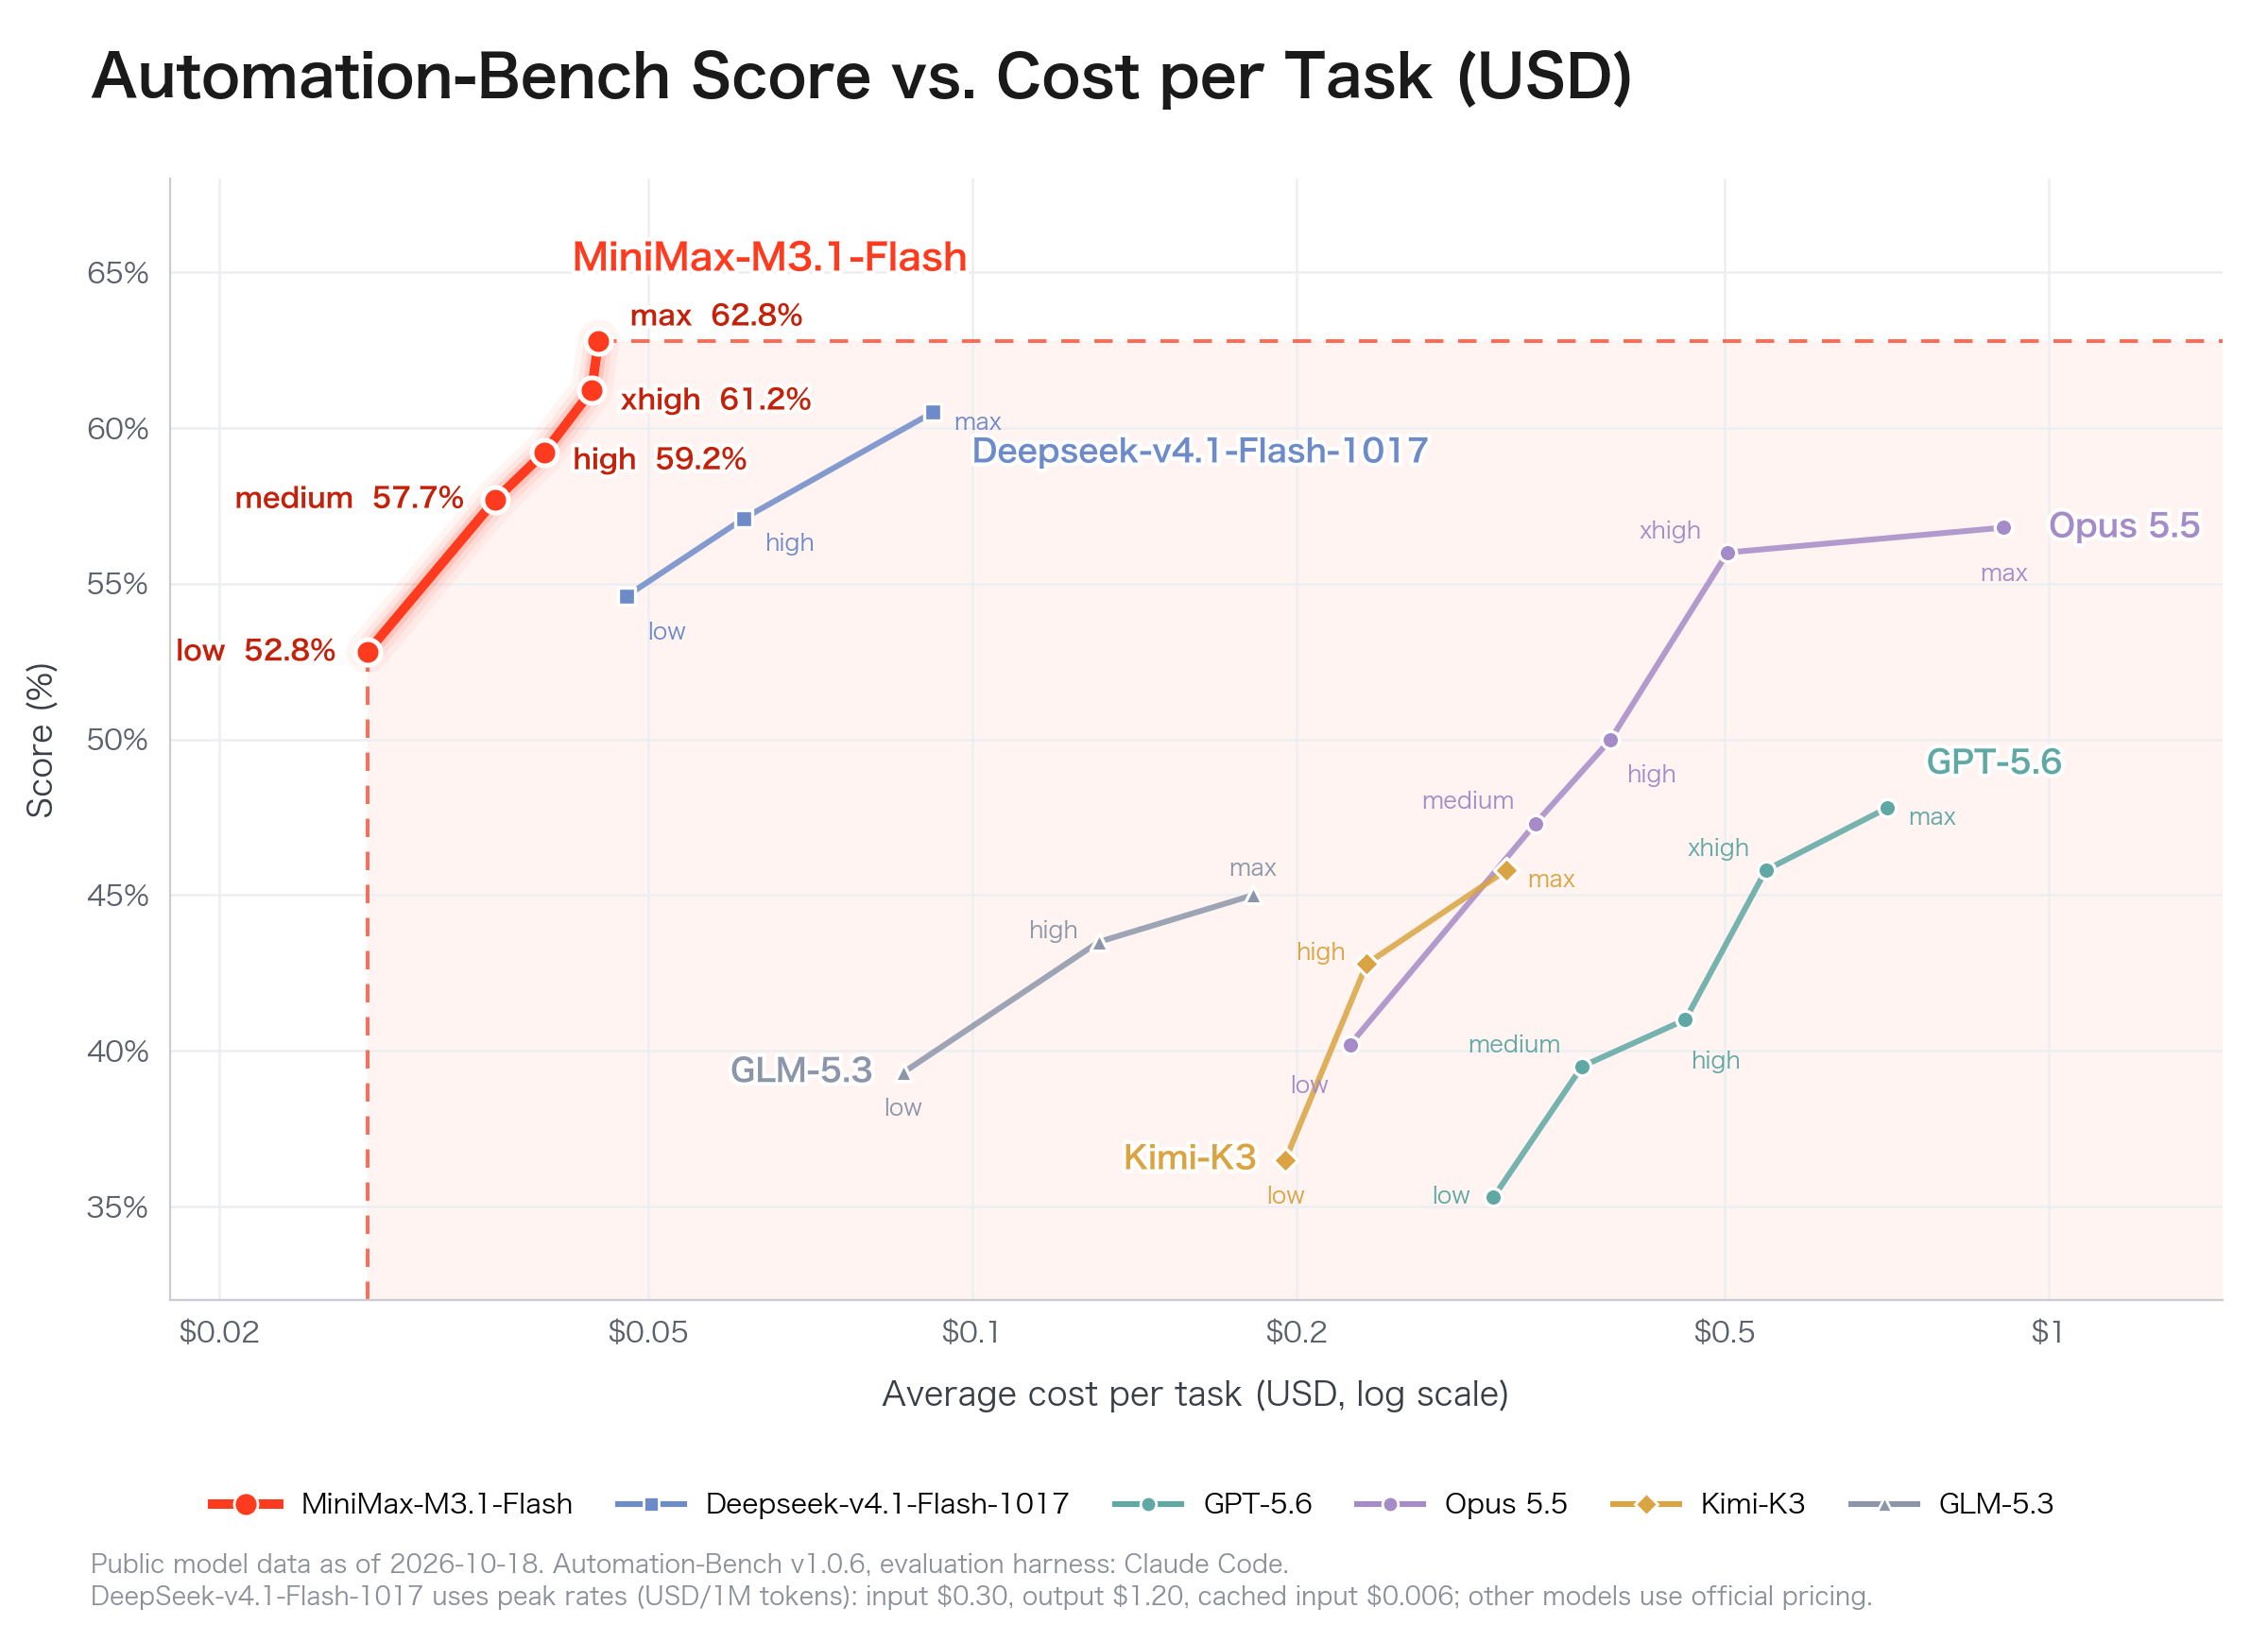
このビジュアルは、最終段落で提供されているソフトウェアエンジニアリングおよび財務コンプライアンスに関する特定のベンチマークデータを裏付けるものです。