KiviDBは、Rustプログラミング言語で開発された、RedisおよびValkeyに代わる高性能なマルチスレッド代替案です。ドロップインリプレースメントとして設計されており、Redisプロトコル(RESP2およびRESP3)をサポートしているため、既存のRedisクライアント、ライブラリ、および`redis-cli`ツールとシームレスに動作します。従来のRedisが単一スレッドのコマンド実行ループで動作するのに対し、KiviDBはシャード化されたインメモリキーバリュー設計を採用しており、すべてのコアでコマンドを実行することでハードウェアの利用効率を最大化することを目指しています。
この画像は、RustベースのRedis代替案としてのプロジェクトのアイデンティティとコア機能を示す主要なビジュアルとして機能します。
このデータベースは、高度な検索機能をコアに直接統合している点で差別化されています。Redis Stackスタイルの`FT.*`コマンドをサポートしており、フルテキスト(BM25を使用)、タグ、数値、およびベクトル検索(FLATまたはHNSWアルゴリズムを使用)が可能です。この統合により、ユーザーは個別のモジュールや外部クエリエンジンを必要とせずに、ハッシュフィールドに対してベクトル近似最近傍(ANN)検索を実行できます。永続化については、KiviDBはネイティブのスナップショットとオプションのAppend-Only File(AOF)を採用しています。スナップショットシステムの注目すべき特徴は、各ベクトルフィールドのHNSWグラフを保持することであり、これにより再起動直後でもフルインデックスの再構築を必要とせずに検索品質を維持できます。
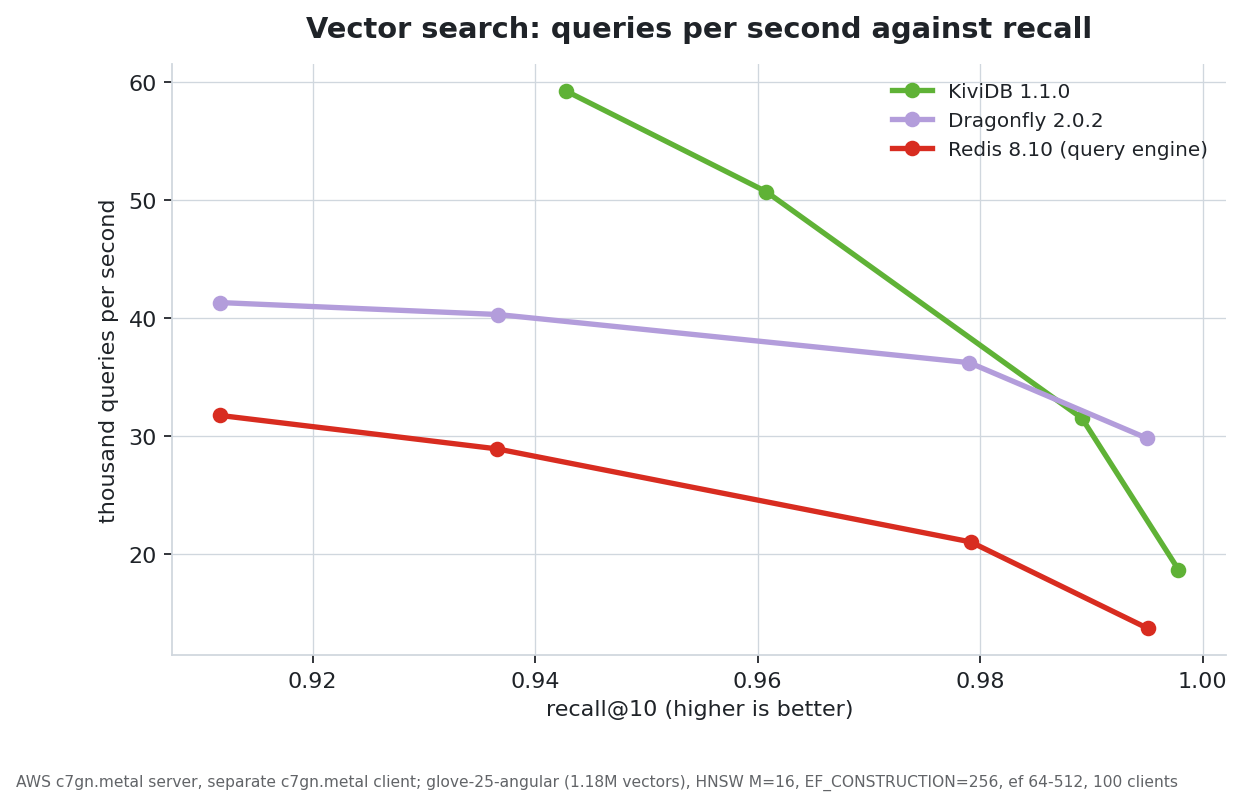
このグラフは、KiviDBの統合されたベクトル検索機能とANNアルゴリズムに関する議論をサポートします。
開発者によって提供されたパフォーマンスベンチマークは、確立された競合製品に対して大幅なスループットの優位性を示唆しています。AWS Graviton3ハードウェアで実施されたテストでは、KiviDBは32コアで毎秒2,100万件のパイプライン化されたGETを処理したと報告されており、開発者はこれがRedis 8よりも約9倍、Dragonflyよりも2.3倍高速であると主張しています。ただし、これらの数値は特定の制御された環境におけるものであり、ハードウェア、ワークロード、および構成によって異なる可能性があります。KiviDBはベクトル機能を内蔵した高性能な代替案を提供しますが、ユーザーはAGPL-3.0ライセンスのトレードオフや、Dragonflyのような他のマルチスレッド代替案で使用される共有なし(shared-nothing)モデルと比較した、そのシャード化アーキテクチャ固有のパフォーマンス特性を考慮する必要があります。
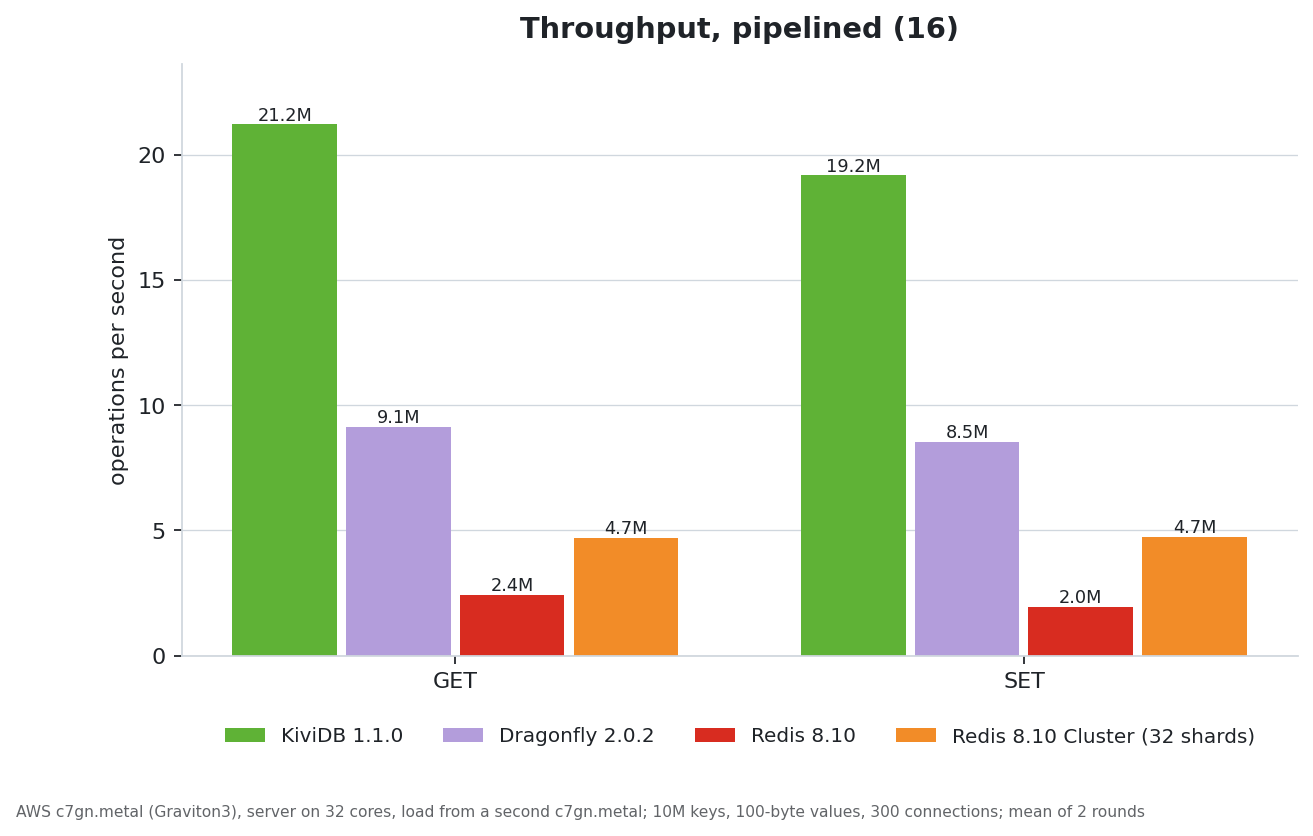
このチャートは、パフォーマンスベンチマークセクションで言及されている特定のスループットの優位性を図示しています。
KiviDBは、Cargoの機能を通じてLuaスクリプティングやTLSサポートの切り替えを含む、いくつかの構成オプションを提供します。また、さまざまなエビクションポリシーやメモリ制限もサポートしています。デプロイに関しては、`amd64`および`arm64`アーキテクチャの両方に対応したDockerイメージを提供しており、デフォルトでポート6380をリッスンすることで標準のRedisインスタンスと並行して実行できます。このプロジェクトはGNU Affero General Public License v3の下でオープンソース化されており、基礎となるLinuxカーネルの能力に応じて、I/Oモデルとして`io_uring`と`Tokio`の両方をサポートしています。
ユーザーにとっての技術的な考慮事項の一つは、インデックス再構築中のデータベースの挙動です。HNSWグラフはスナップショットに永続化されますが、スナップショットではなくAppend-Only File(AOF)から再起動が発生した場合、システムは生のハッシュから検索インデックスを再構築する必要がある場合があります。この期間中、ほとんどのコマンドは`LOADING`ステータスを返しますが、`PING`や`INFO`などの基本的なコマンドは引き続き機能します。この違いは、検索を多用するワークロードにおいて高い可用性を維持するために、定期的なスナップショットの重要性を強調しています。
さらに、このプロジェクトのパフォーマンスに関する主張は、ベンチマークの手法に関する議論を呼び起こしています。一部の観察者は、RedisがI/O操作にマルチスレッドを使用しているため、KiviDBのようなマルチスレッドアーキテクチャと比較する際には、スレッドプールの飢餓状態やコアのピンニングを慎重に考慮する必要があることを指摘しています。KiviDBのアーキテクチャは、きめ細かなロッキングを通じてロック競合を最小限に抑えるように設計されていますが、データの分布やアクセスパターンが異なる実世界のシナリオにおける実用的なパフォーマンス向上は、独立した検証のための重要な領域として残っています。