AIの文脈において「ハーネス」とは、大規模言語モデル(LLM)を自律的なエージェントとして動作させるためのインフラを指します。これには、システムプロンプト、ガードレール、メモリ、ツールガイダンス、サブエージェント、スキル、スクリプト、プラグインなどのコンポーネントが含まれます。Harness²は、Google Researchによって開発された、これらのコンポーネントの最適化を自動化するためのフレームワークであり、研究者はこのプロセスを「ハーネス(harnessing)」と呼んでいます。標準的なファインチューニングとは異なり、Harness²は基礎となるモデルの重みを固定したまま、モデルの振る舞いを導く外部システムを反復的に改善することに焦点を当てます。
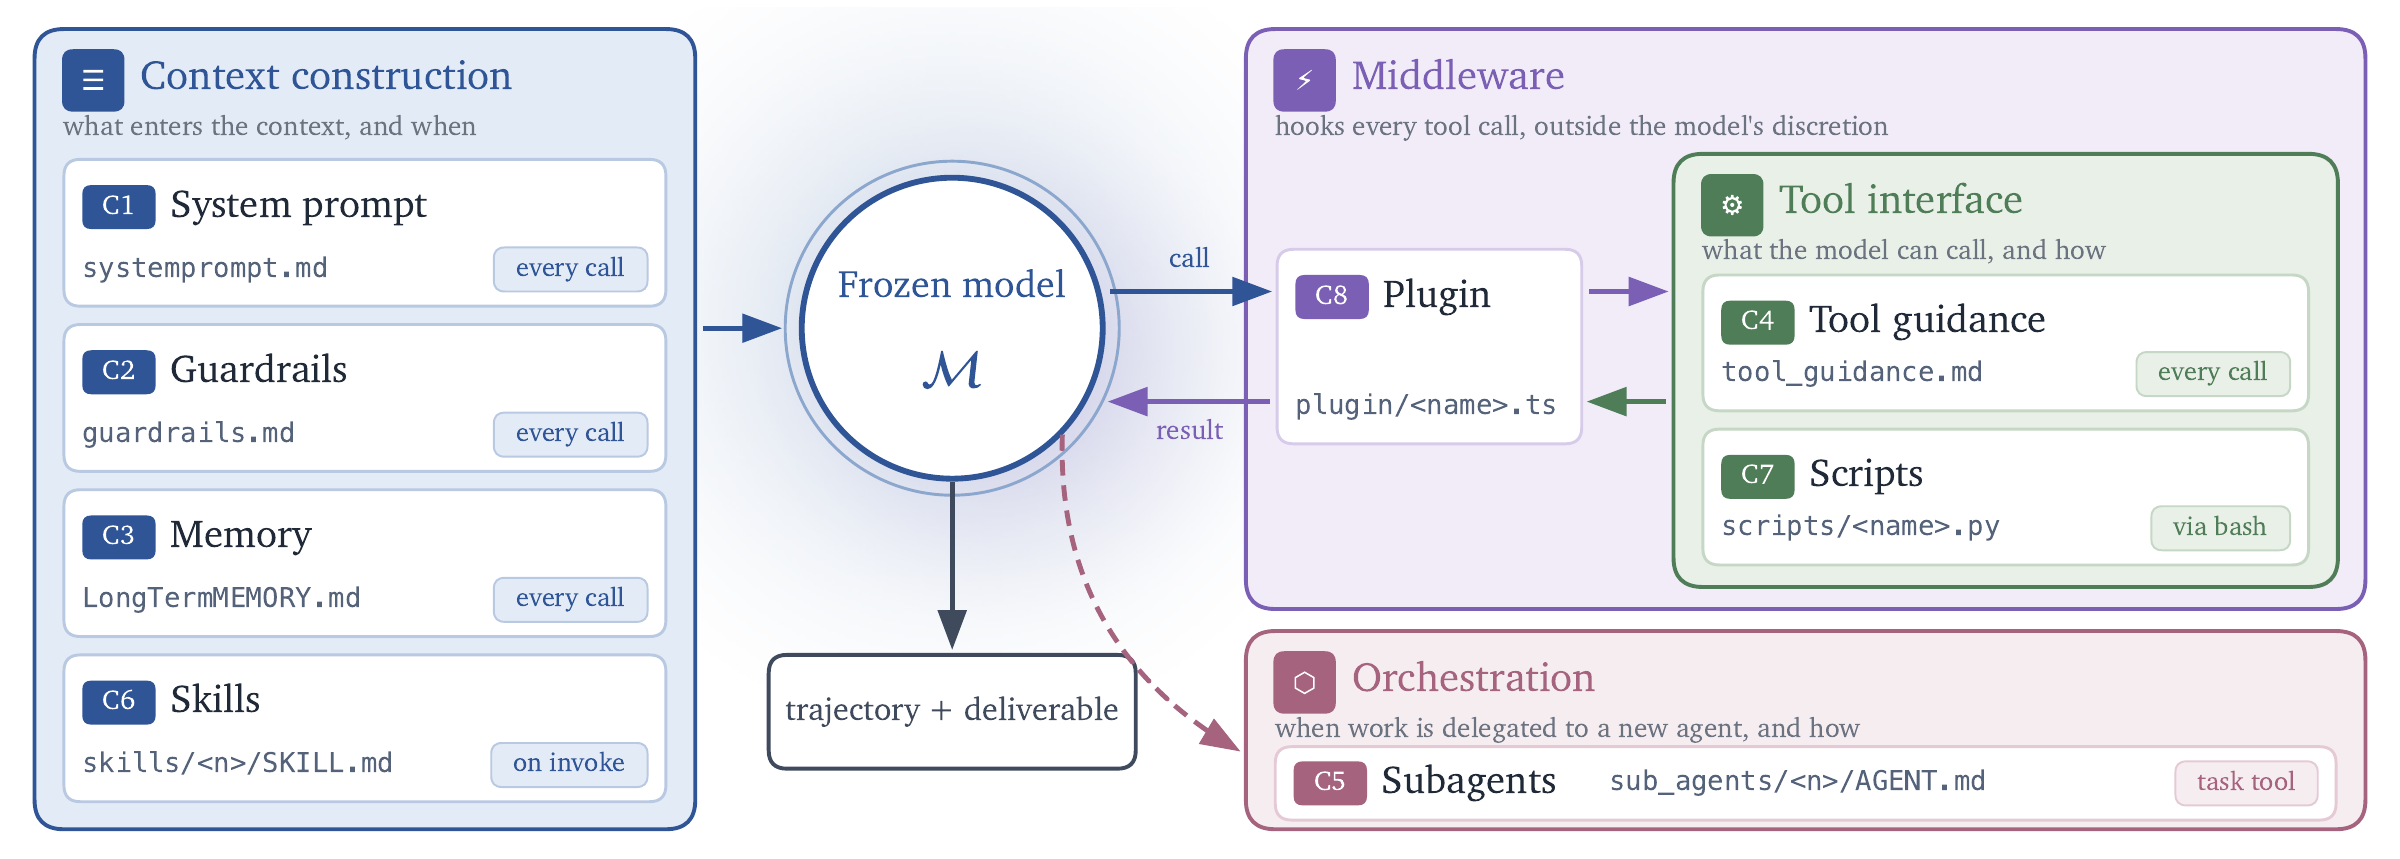
この画像は、Harness²フレームワークが最適化するように設計された「ハーネス」インフラの特定のコンポーネントを説明しています。
このフレームワークは、初期の設計段階では明示的に考慮されていなかったタスクにエージェントが直面する「オープンワールド」シナリオを処理するために、2つの異なる再帰レイヤーを通じて動作します。第1のレイヤーは「タスクレベルの再帰」であり、Propose(提案)–Probe(調査)–Compose(構成)サイクルを使用します。エージェントは自身のハーネスへの編集を提案し、それらの編集が現在のタスクに与える影響を調査し、振る舞いの対比に基づいて洗練されたバージョンを構成します。第2のレイヤーは「ハーネスレベルの再帰」であり、永続的な「改善ハーネス」を維持します。このレイヤーは、完了したタスクから得られた教訓と証拠に基づいた改善事項を捉えて将来のタスクの洗練を導き、システムが時間の経過とともに経験から学習することを可能にします。
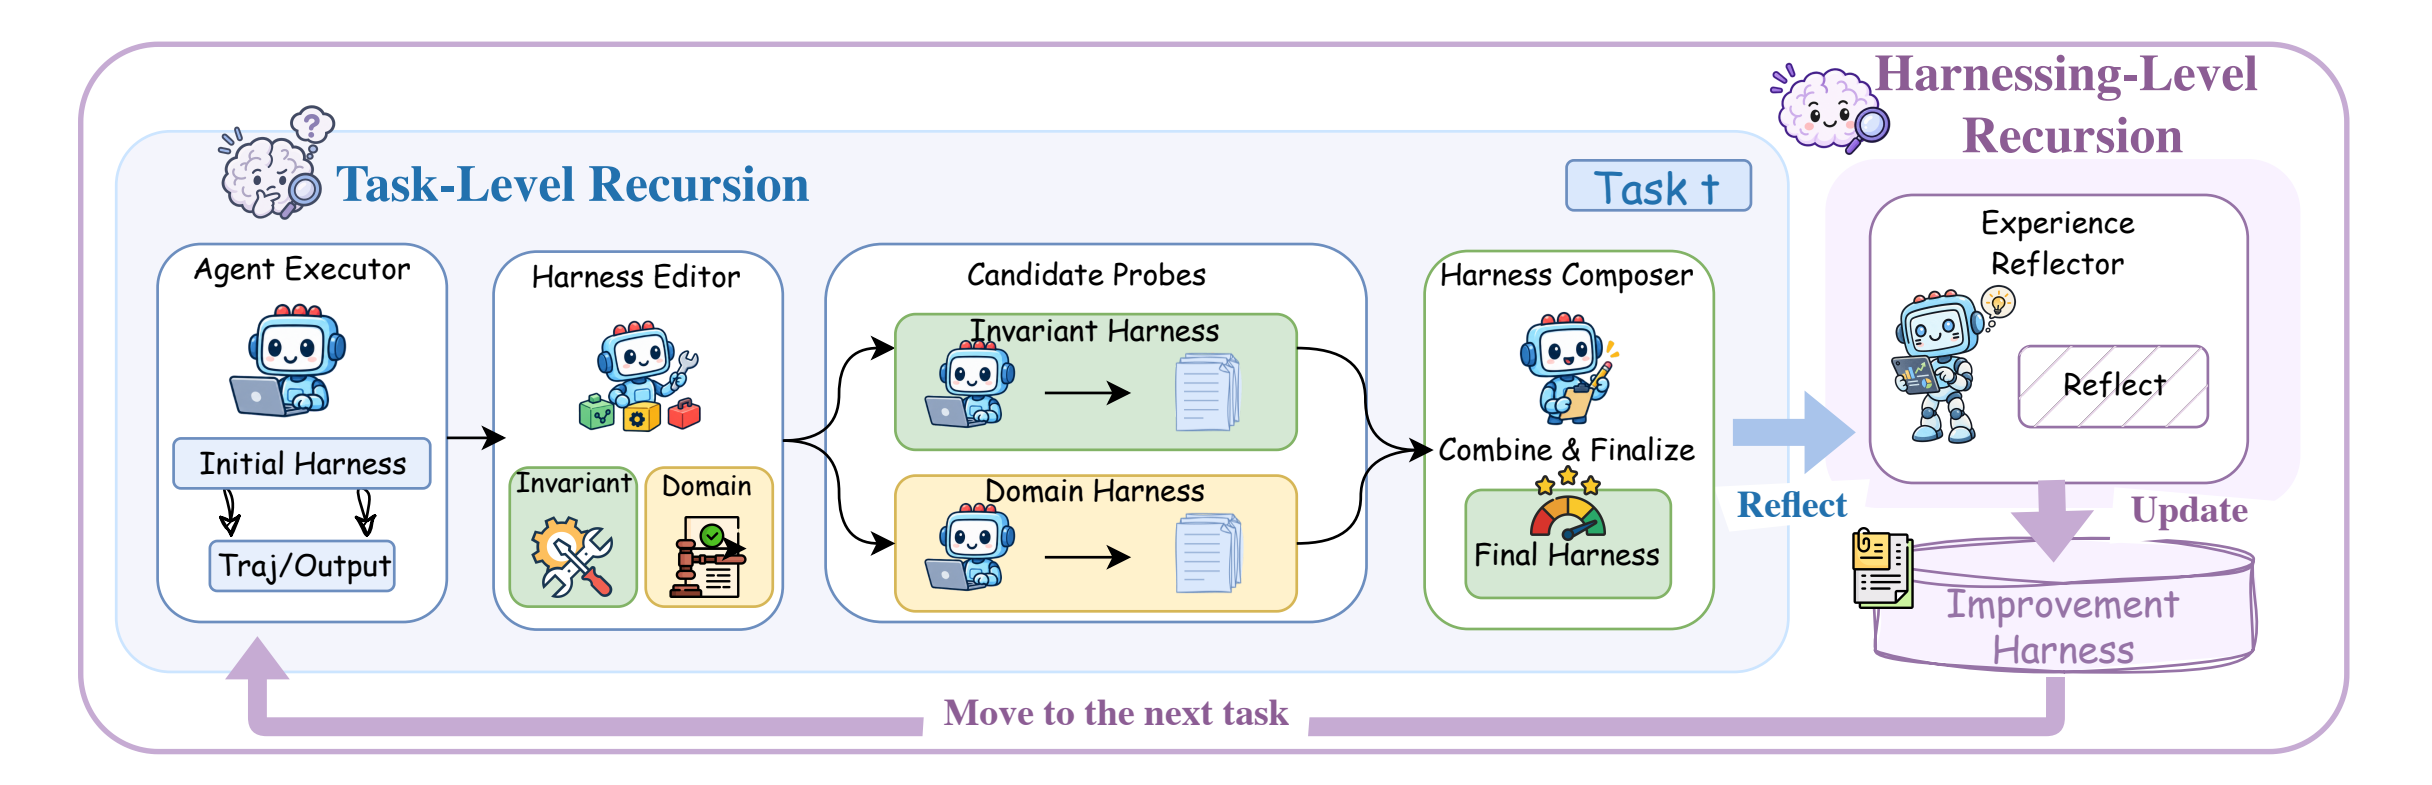
この図は、第2パラグラフで説明されている二重の再帰プロセス(タスクレベルおよびハーネスレベル)を説明しています。
研究者による実験結果は、Harness²が専門的なベンチマーク全体で大幅なパフォーマンス向上を提供できることを示しています。例えば、Harness²の単一ステップにより、GLM-5およびGemini 3.5 Flashモデルが改善され、WorkBuddy-Benchで最大11.5ポイント、LABの部分的合格率で11.8パーセンテージポイントの向上が得られました。このフレームワークは、最適な構成を見つけるために複数の候補ハーネスを同時に探索する「並列再帰」と、より深い最適化のために洗練されたハーネスを連続するステップを通じて引き継ぐ「逐次再帰」の両方をサポートしています。フレームワークはエージェントの進化のための構造化された手法を提供しますが、研究者はシステムの有効性が「再帰予算(recursion budget)」、つまりタスクごとに許可されるPropose–Probe–Composeステップの数に比例することを指摘しています。
このフレームワークの注目すべき技術的制約の一つは、その実行環境に関わるものです。フレームワークはOpenCodeやCodexなどのさまざまなエグゼキューターをサポートしていますが、研究者はCodexエグゼキューターはサンドボックスが無効な状態で実行され、エグゼキューターのネットワークアクセスは制限されないことを明示しています。評価中のリスクを軽減するために、ユーザーはベンチマークを実行する前にネットワーク制限を設定し、エージェントが結果の完全性を損なう可能性のある公開の評価基準や採点基準にアクセスするのを防ぐことが推奨されます。このプロジェクトはApache 2.0ライセンスの下でリリースされており、より適応性の高い自律型エージェントを構築しようとする開発者のためのプラグアンドプレイツールとして意図されています。
プロジェクトのロゴは、記事全体で議論されているフレームワークを識別します。
現在の実装における制限の一つは、ハーネス編集の成功を判断するためにエージェント自身の実行証拠に依存していることです。システムはグラウンドトゥルースのフィードバック(「正しい」または「正しくない」という外部ラベル)に依存しないため、異なるハーネス構成間の振る舞いの対比に頼る必要があります。これは、最適化の品質が、エージェントが自身の提案した変更の結果を正確に調査し解釈する能力に本質的に結びついていることを意味します。さらに、フレームワークは「オープンワールド」のタスク向けに設計されていますが、そのパフォーマンスは初期コンポーネントの品質と、ユーザーによって提供される再帰予算の深さに依存したままです。
ユーザーは、決定論的なエディターと実際のPython実行の両方の再帰モードを実行するローカルデモを介してフレームワークを操作できます。モデルをバックエンドとしたベンチマークでは、フレームワークはVertex AIと統合され、WorkBuddy-Bench用のDocker、またはLABベンチマーク用のPandocおよびPopplerなどの特定の依存関係を必要とします。これらの実行結果は構造化されたディレクトリに自動的に保存され、タスクの要約、成果物、およびハーネスコンポーネントの経時的な進化を記録するリフレクションノートが提供されます。