DeepSeekは、DeepSeekモデルの大規模なプロダクションサービスをサポートするために特別に設計された高性能推論フレームワーク「DeepInfer」をオープンソース化しました。現在のリリースはオフライン推論に焦点を当てていますが、スケーリングに必要なコア機能が含まれています。このフレームワークは、NVIDIA SM100 GPUやHuawei Ascend 950 NPUを含む特定のハードウェアで動作するように設計されています。開発にあたっては、vLLM、SGLang、TensorRT-LLMといった既存のフレームワークから着想を得ています。
この画像は、フレームワークがホストされている公式のDeepInferリポジトリを表しています。
このフレームワークは、スループットとレイテンシを向上させるためのいくつかの専門的な最適化を導入しています。これらには、FlashMLA、DeepGEMM、DeepEPといった最適化されたカーネルに加え、Attention DP(データ並列)、バランスの取れたCP(コンテキスト並列)、およびEPLBを伴うMoE(Mixture of Experts)EP(エキスパート並列)といった高度な並列化技術が含まれます。また、ドラフトトークンを使用してデコーディングを加速するDSparkやconfidence-scheduled verificationも特徴として備えています。その他の技術的機能には、CPUバッチ処理とデバイス実行をオーバーラップさせる非同期スケジューリング、バッチ不変推論(NVIDIAハードウェア用)、および同一の入力パラメータに対して一貫した出力を保証する決定論的サンプリングが含まれます。
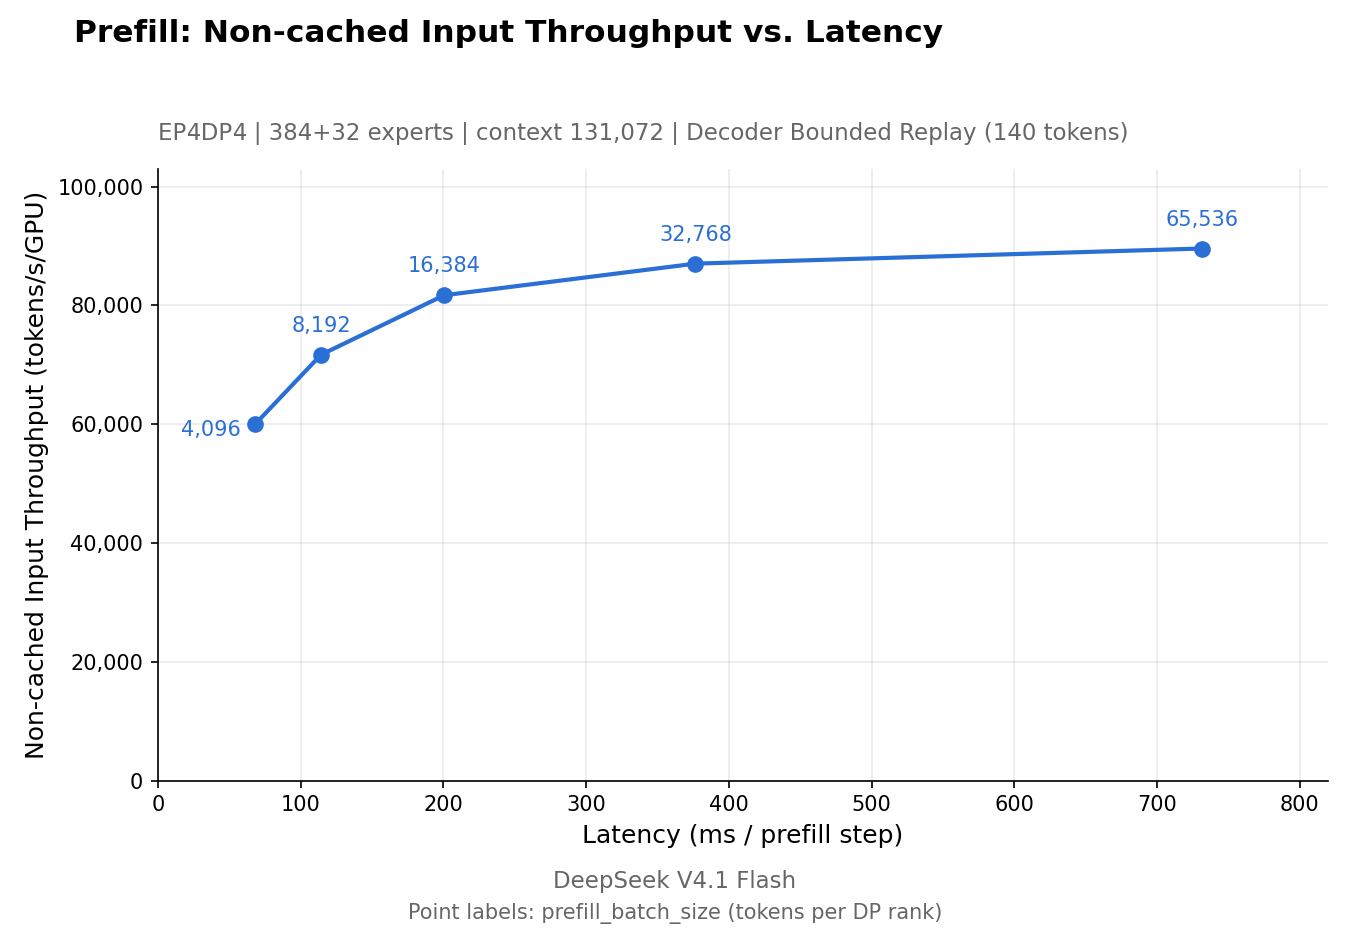
この図は、技術的な最適化で言及されているprefillプロセスの性能特性を視覚化したものです。
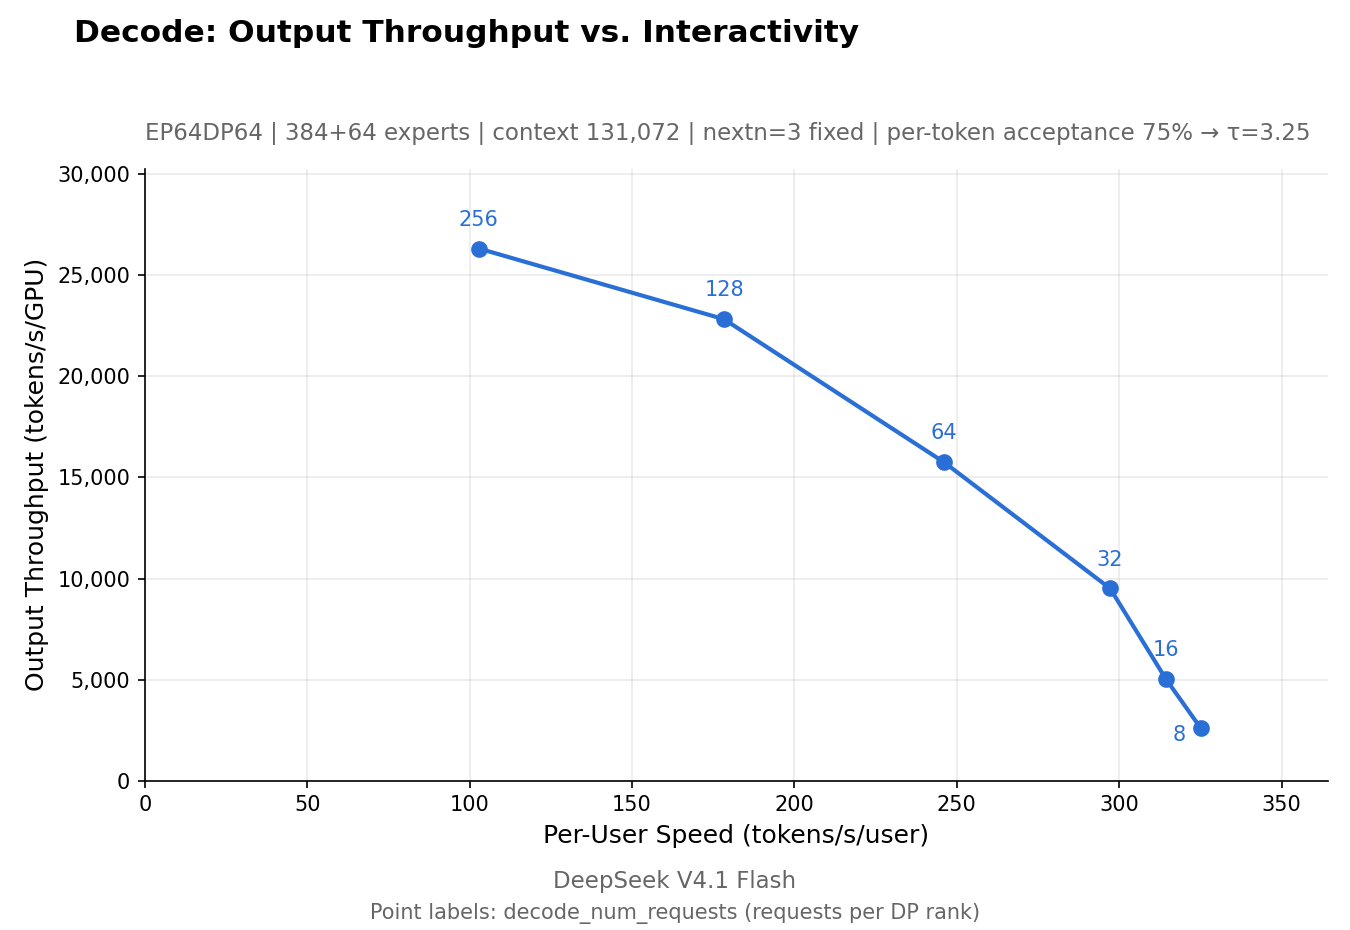
このチャートは、フレームワークの最適化によってサポートされるデコーディングの性能指標を示しています。
高いパフォーマンス能力を備えている一方で、現在のオープンソースリリースには、完全なプロダクション推論サービスに関してはいくつかの制限があります。現時点では、KV(Key-Value)キャッシュシステムやVE/Prefill/Decodeの分離(disaggregation)は含まれていません。さらに、コアエンジンの機能は提供されていますが、prefillおよびdecodeの両方のステージにおいて、データ並列レプリカ間での組み込みのロードバランシング機能は欠けています。このフレームワークをデプロイしようとするユーザーは、フルスケールのサービスを構築する際に、これらの欠落しているコンポーネントを考慮する必要があります。