現代の大規模言語モデル(LLM)エージェントは、通常、テキストを通じて推論を行い、世界と相互作用します。この手法は透明性が高く、外部ツールとの統合も容易ですが、計算コストが高く、思考プロセスのすべての単語を生成するのではなく、モデルが内部の隠れ状態で情報を処理する「潜在的推論」よりも効率が低い場合があります。研究者たちは、これら2つのアプローチを橋渡しするHybrid Reasoning Agents(HybridAgents)を導入しました。これにより、エージェントは単一の生成プロセス内で、潜在モードとテキストモードの間を移動できるようになります。
このアーキテクチャは、モデルの最終層の隠れ状態を入力埋め込み空間にマッピングするHybridLinkと呼ばれるコンポーネントに依存しています。これにより、エージェントは高速な内部思考のための「潜在モード」に入ることができ、その思考は人間が読み取れる擬似テキストとして検査することも可能です。エージェントがツールの呼び出し、最終的な回答の提供、または外部環境との相互作用を必要とする場合、エージェントは「テキストモード」へと移行します。これらの切り替えの間でエージェントがコンテキストを維持できるように、連続的なワーキングメモリがテキストの相互作用と潜在的な思考の両方の履歴を保存し、内部の推論が外部のアクションに関連し続けることを保証します。
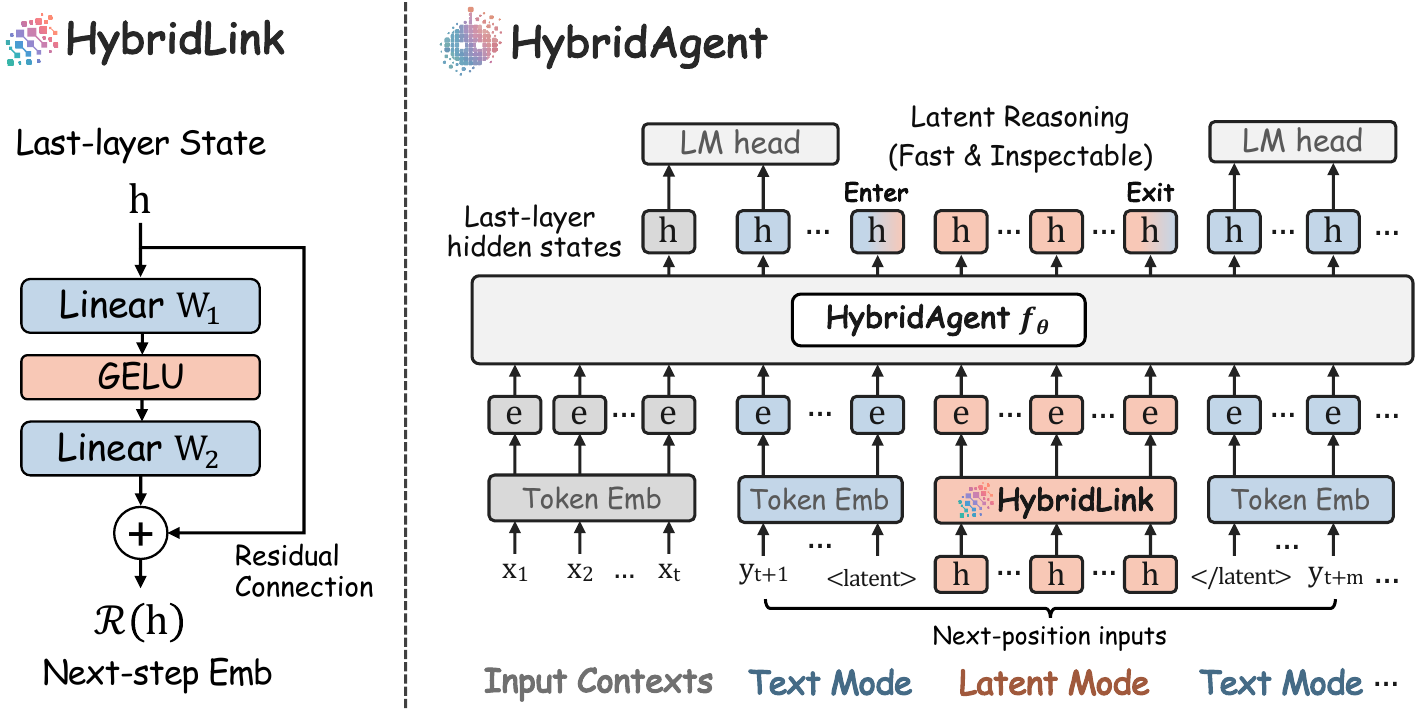
この図はHybridAgentsのコアアーキテクチャ、特に潜在モードとテキストモードの間をどのように遷移するかを説明しています。
これらのモデルをトレーニングするために、研究者たちは2つのポストトレーニングアルゴリズム、HybridSFTとHybridRLを開発しました。HybridSFTは、HybridLinkと連携するモデルの能力を安定させ、HybridRLは、潜在空間で思考するのが最も効率的な時と、テキストを通じて行動しなければならない時をエージェントに判断させます。数学、科学、医学を含む11のベンチマークにわたる評価において、HybridAgentは最先端のLLMエージェントを平均10.4%上回りました。研究者らはまた、トークン使用量の35.5%から54.7%の削減、最大2.6倍の推論速度の向上、および従来のテキストのみのエージェントフレームワークと比較して最大3.7倍のコスト削減を含む、大幅な効率性の向上も報告しました。