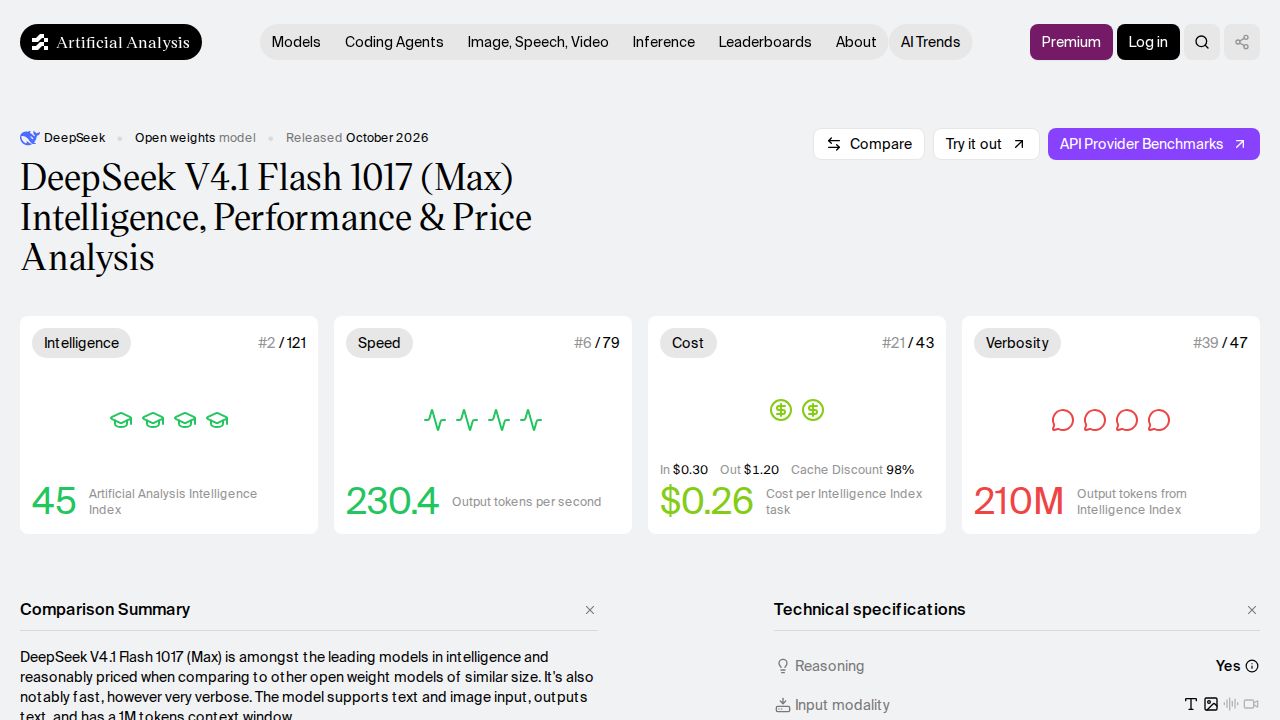
DeepSeek V4.1 Flash 1017 (Max) モデルは、パラメータ数、速度、および推論能力のバランスに関して大きな議論を巻き起こしています。注目すべき技術的詳細はそのアーキテクチャにあり、536+16B(パッシブ+アクティブ)のパラメータ構造を採用しています。この構成により、モデルのサイズが約半分であるにもかかわらず、Mimo v2.6 Pro といったより大きなモデルに匹敵する性能を実現しています。このモデルは高いスループット(秒あたりのトークン数)で高く評価されている一方で、一部のユーザーからは出力が冗長になることがあるとの指摘もあり、トークン効率を改善するためには将来的なファインチューニングが必要かもしれないことが示唆されています。
他のモデルとの比較からは、コストと速度における様々なトレードオフが明らかになっています。例えば、一部のユーザーは、GPT 6.1 Sol (medium) の方が、DeepSeek V4.1 Flash 1017 (max) の構成よりもタスクあたりのコストが安く、かつ高速である可能性があると指摘しています。これは、「max」推論負荷と標準的な構成との間の重要な違いを浮き彫りにしています。「max」負荷はより高い知能を目指すものですが、比較的わずかな性能向上に対して、必要な時間とトークン数を大幅に増加させる可能性があります。一部のテスターは、「max」設定が「high」設定のほぼ2倍のトークンを消費しながら、特定のユースケースにおいて目立った利点がほとんど見られなかったと報告しています。
コンシューマー向けハードウェアでの実用的な展開も引き続き重要な関心事です。一部のユーザーは、128GBのRAMを搭載したMac Studioのようなハイエンドのコンシューマー環境でDeepSeek V4 Flashモデルを正常に動作させることに成功していますが、これらのモデルが妥当な知能を維持しながら、より低スペックなハードウェア(例:128GBのRAMを搭載した2080tiなど)で効果的に動作するかについては継続的な議論があります。さらに、スループットは低下するもののアクセシビリティを高めるための手法として、SSDから重みをストリーミングするような技術的な可能性も、これらの大規模モデルを一般的なハードウェア構成でより使いやすくするための方法として模索されています。