PyTorchが機械学習モデルの計算グラフを構築する際、特定のRAM予算内に収まるように、どの操作をメモリに保持し、どの操作を再計算すべきかを決定する必要があります。これは0/1ナップサック問題として定式化されます。各操作はメモリコストと実行時間の「価値」を持つ「アイテム」として扱われます。目標は、利用可能なメモリ容量を超えずに、総時間の節約を最大化する保存操作のセットを選択することです。従来、PyTorchはこの問題を解決するために `dp_knapsack` と呼ばれる動的計画法(DP)のアプローチを使用していますが、標準的な実装では(アイテム数、最大重量)の形状を持つ完全な2次元テーブルの割り当てが必要であり、大規模なモデルではメモリ不足を引き起こす可能性があります。
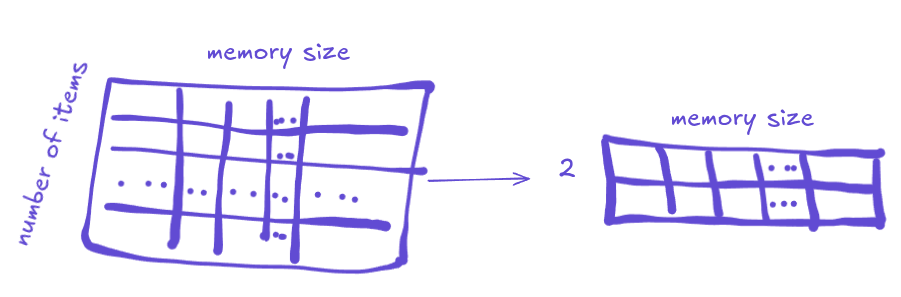
この画像は、第1段落で言及されているナップサック問題を説明しており、操作はメモリコストと実行時間の価値を持つアイテムとして扱われます。
この課題に対処するため、Jędrzej Maczanは計画フェーズ自体のメモリフットプリントを大幅に削減するソルバー `dp_knapsack_sliding_hirschberg` を導入しました。この実装では、主に2つの最適化が利用されています。第一に、「スライディングウィンドウ」のテクニックを採用しており、現在の行と前の行のみをメモリに保持することでDPテーブルの空間複雑度を削減します。第二に、コストのかかるバックトラッキングのステップを排除する分割統治法であるHirschbergアルゴリズムを組み込んでいます。巨大なテーブルを構築して最適なアイテムを遡って特定する代わりに、Hirschberg法は問題を再帰的に小さな部分問題に分割し、最終的な保存操作のセットが決定されるまで最適な分割点を特定します。
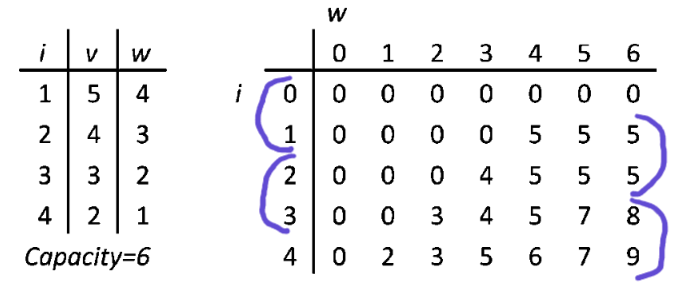
この図は、第2段落で言及されている最初の最適化、すなわちDPテーブルのメモリフットプリントを最小限に抑えるためのスライディングウィンドウの使用を説明しています。
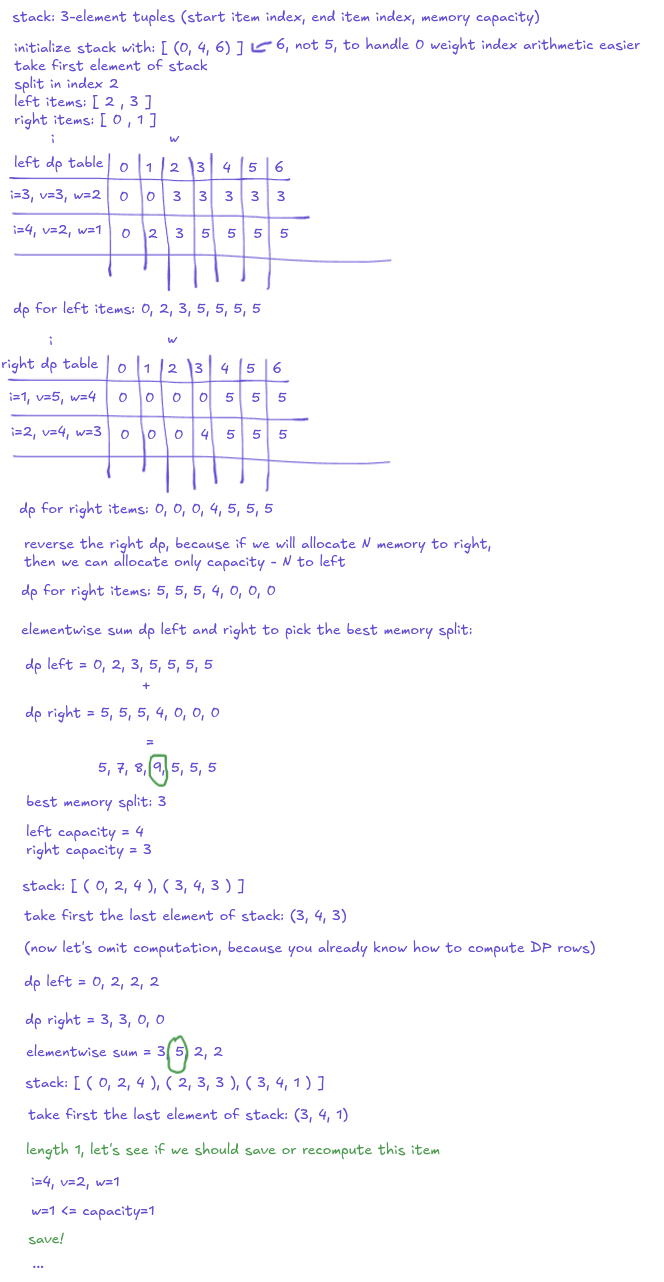
この視覚資料は、第2段落で説明されている2番目の最適化をサポートしており、Hirschberg法がどのように問題を再帰的に分割するかを示しています。
実用的なテストにおいて、この変更により、元の `dp_knapsack` ソルバーがわずか100個のアイテムでクラッシュするタスクにおいて、64GBのRAMを搭載したマシンで2,000個のアイテムを処理することが可能になりました。新しいソルバーは厳密な解を提供し、ベースラインよりも約37%高速ですが、利用可能な最も速い手法ではありません。外部依存関係を導入できるユーザーにとっては、SciPyを介した整数線形計画法(ILP)ソルバーの方が大幅に高速です。しかし、標準的なPyTorch配布に制限されるユーザーにとって、`dp_knapsack_sliding_hirschberg` は従来のDPテーブルのオーバーヘッドなしに、メモリを大量に消費するモデルを管理するための堅牢な方法を提供します。
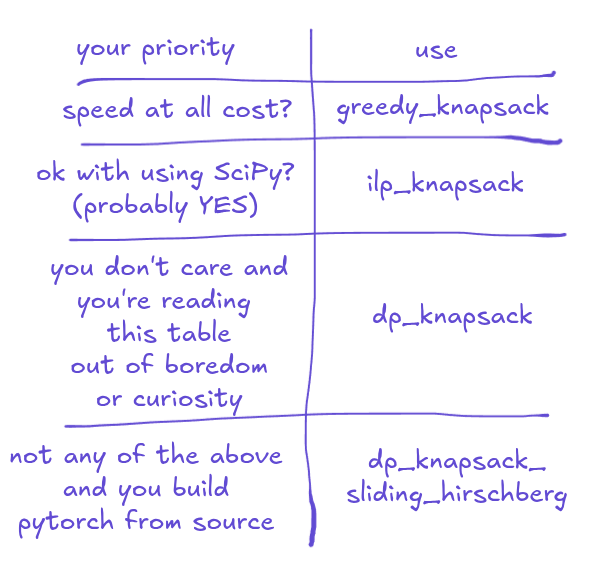
この画像は、最終段落で議論されている新しいソルバー、ベースライン、および外部ILPソルバーの間の実用的なテスト結果と比較を例示しています。