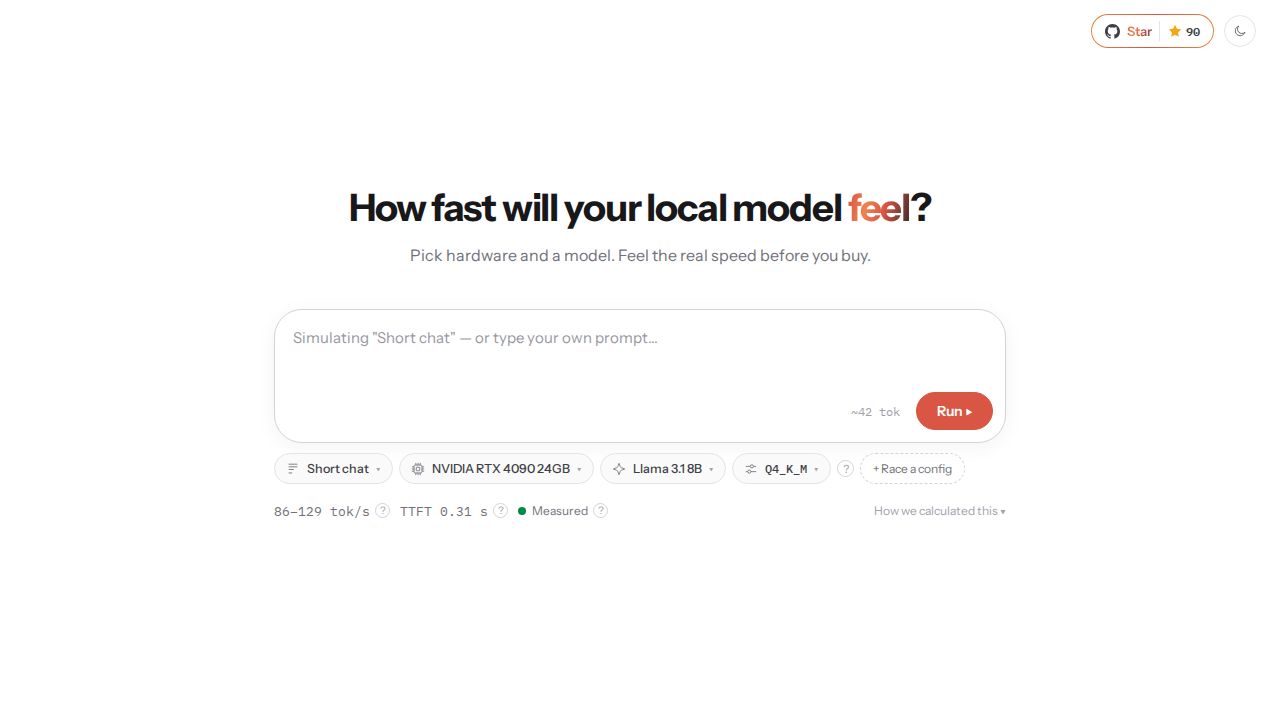
Llmspeedは、特定のハードウェア上でローカルの大規模言語モデル(LLM)がどの程度の速度で動作するかをユーザーが推定するのを支援するために設計されたWebベースのツールです。NVIDIA RTX 5090のようなコンシューマー向けGPUからMac Studio M5 Ultraのようなハイエンドワークステーションまでを含むハードウェア構成のカタログと、Qwen、Gemma 4、DeepSeekといった多様なモデルを提供することで、ユーザーはモデル自体をダウンロードして実行することなく、tokens per second (tk/s) や time to first token (TTFT) といったパフォーマンス指標を可視化することができます。
このツールは、コミュニティのベンチマーク(r/LocalLLaMAやlocalscore.aiなど)およびハードウェア仕様に基づく予測から推定値を導き出しています。これにより、ユーザーはモデルのサイズ、量子化レベル(例:4ビットまたは8ビット)、およびハードウェアのメモリ制限の間のトレードオフを評価する方法を提供します。例えば、特定のモデルがGPUのVRAMにどのように収まるか、あるいは特定の構成が特定のモデルのパラメータを実行する物理的な能力を備えているかを示すことができます。
しかし、ユーザーや技術的な観察者は、これらの推定値はパフォーマンスの特定のスナップショットを表しており、実際の使用における完全な複雑さを捉えていない可能性があると指摘しています。このツールに関する議論では、パフォーマンスは推論エンジンの実装、特定のソフトウェア最適化(投機的デコーディングなど)、およびコンテキストウィンドウのサイズによって大きく異なる可能性があることが強調されています。例えば、モデルは短いプロンプトでは良好に動作するかもしれませんが、コンテキストウィンドウが大きくなるにつれてパフォーマンスが低下する可能性があります。さらに、一部のユーザーは、大きなプロンプトや複雑なKVキャッシュ管理を伴うことが多い実際のエージェンティックなワークロードは、簡略化されたベンチマークに示されるピーク数値よりも低いスループットをもたらす可能性があると指摘しました。このツールはハイレベルな計画リソースとして機能しますが、実際のパフォーマンスはエンドユーザーが使用する特定のソフトウェアスタックやハードウェアのニュアンスに左右されます。