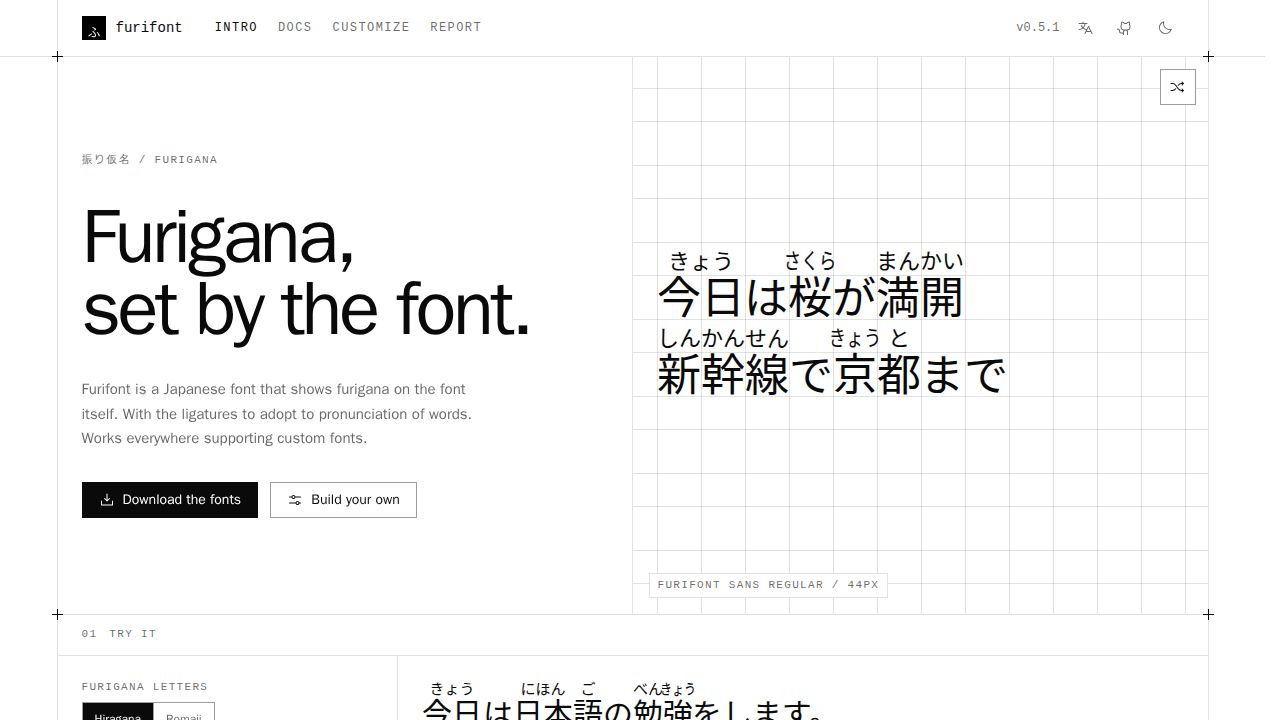
Furifontは、フォントのレンダリングエンジンを通じて、漢字の上または横に配置される小さな音標文字である「振り仮名」を自動的に表示するように設計された日本語フォントです。このプロジェクトは、フォントのリガチャ(合字)を活用することで、Webや印刷メディアでの標準的な手法であるルビタグの手動挿入を必要とせずに、複雑な漢字の読みをシームレスに表示することを目指しています。このアプローチは、特定の電子書籍リーダー、カスタムアプリケーション、あるいは特定のWeb環境など、従来のフォーマットを適用することが困難なコンテキストにおいて特に有用です。
この仕組みは、複雑なシェイピングやリガチャを可能にするTrueTypeおよびOpenTypeフォント仕様の柔軟性に依存しています。特定の文字シーケンスが入力されると、フォントはそれらを漢字と対応する振り仮名の両方を含む単一のグリフに置き換えます。しかし、この手法は重大な言語学的課題に直面しています。日本語の漢字の読みは、極めて文脈に依存する性質を持っているためです。多くの文字は周囲の単語に応じて複数の異なる読みを持ち、中には数十もの異なる発音を持つものもあります。フォントのシェイピングエンジンは通常、文章全体の文脈ではなく局所的な文字シーケンスに基づいて動作するため、曖昧な単語の正しい読みを判断するのに苦労することがあり、不正確な発音ガイドにつながる可能性があります。
ユーザーや観察者は、このアプローチの創造的な有用性と実用的な限界の両方に注目しています。言語学習者にとって、このフォントは複雑なテキストを読むための便利な架け橋となりますが、行の折り返しによって単語が分割された際に、フォントが正しいリガチャを選択するために必要な文脈を失い、機能しなくなる可能性があることが指摘されています。さらに、このフォントは現在、大規模言語モデルでさえ苦労する日本語の文法や語彙の膨大なニュアンスを考慮することができないため、学習者に誤った発音を教えてしまうリスクがあります。このプロジェクトはフォントエンジニアリングの革新的な活用例ではありますが、その信頼性は、日本語の音標規則に固有の複雑さによって制限されたままです。
プロジェクトに関する議論の中で、自動振り仮名の完全な実現は困難であるものの、このフォントは基本的な漢字認識に苦労する人々にとって価値のあるツールになり得ることが強調されました。また、このプロジェクトの主な価値は、特定のデジタル読書デバイスなど、標準的なルビタグがサポートされていない環境で機能する能力にあるという意見もありました。精度の向上に関する技術的な実現可能性についても議論され、より高度なセグメンテーションアルゴリズムを統合するか、あるいはシェイピングエンジン内で言語モデルを実行することで、現在のフォントの精度を制限している文脈依存の問題を最終的に解決できる可能性が示唆されました。
結局のところ、Furifontはタイポグラフィと言語学におけるユニークな実験としての役割を果たしています。それは、表示の問題を解決するための現代的なフォント仕様の力を示すと同時に、局所的な文字シェイピングだけで達成できることの境界を浮き彫りにしています。当面の間、それはハイテクなタイポグラフィと実用性のバランスをとる特殊なツールとして存在し続けます。