Apple Machine Learning Researchは、MLXフレームワークを使用してMac Studioハードウェア上で最先端クラスの大規模言語モデル(LLM)を実行する能力を実証しました。MLXは、Appleシリコンの統一メモリアーキテクチャを活用するように設計されたオープンソースの配列フレームワークであり、開発者がローカルで推論やファインチューニングを実行することを可能にします。この研究では、Mac Studioのクラスターを利用することで、約1兆のパラメータを持つ混合専門家(MoE)モデルであるMuse Spark Openを実行できることを強調しています。テストでは、4台のマシンによるクラスターで、8,192トークンのコンテキストサイズにおいて毎秒36トークン以上の速度を達成しました。これは平均的な人間の読書速度を上回る数値です。
MLXは、Appleシリコンの統一メモリアーキテクチャを活用するように設計されたオープンソースの配列フレームワークであり、開発者がローカルで推論やファインチューニングを実行することを可能にします。
これらのモデルのパフォーマンスは、ハードウェアのメモリアーキテクチャと専用のアクセラレータに大きく影響されます。例えば、M5 Ultraチップには専用の行列乗算をサポートするGPU Neural Acceleratorが搭載されており、Appleの報告によれば、前世代のM3 Ultraと比較して「最初のトークンまでの時間(TTFT)」を最大4.6倍高速化できるとのことです。Qwen 3.8 (27B)やMistral Medium 3.5 (128B)のような比較的小規模なモデルは、512GBの統一メモリを備えた単一のMac Studioに収まりますが、Muse Spark Openモデルはネイティブ精度では1.6TB以上のRAMを必要とします。4ビット(NVFP4)精度に量子化した場合でも、モデルのメモリフットプリントは約493GBに達するため、モデル自体および推論中に必要な中間計算を収容するために、複数のマシン間での並列化が必要となります。
これらの巨大なモデルを処理するために、MLXはパイプライン並列化とテンソル並列化という2つの主要な並列化スキームをサポートしています。パイプライン並列化は、モデルのレイヤーを異なるマシンに分割するもので、1台のMac Studioが最初の半分のレイヤーを実行し、その出力を次のマシンに渡します。テンソル並列化は、モデルの幅を分散させるもので、各マシンがすべてのレイヤーの断片を保持します。テンソル並列化を実用的にするために、MLXはThunderbolt 5経由の低レイテンシRDMA(Remote Direct Memory Access)ドライバーを利用しています。これにより、クラスター全体で出力を集約するために必要な高速なマシン間通信が可能になります。パイプライン並列化はシンプルさを提供しますが、通信オーバーヘッドが低く抑えられている限り、クラスターに追加のマシンを加えることで、テンソル並列化は高密度アーキテクチャに対して大幅な高速化を提供することができます。
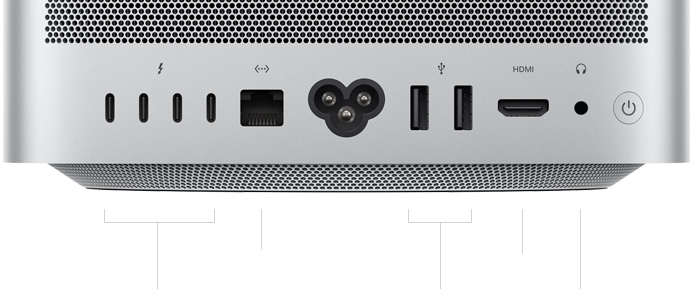
テンソル並列化を実用的にするために、MLXはThunderbolt 5経由の低レイテンシRDMA(Remote Direct Memory Access)ドライバーを利用しています。