Anthropicは最近、巨大なモノレポを処理するために設計されたバージョン管理システム「Scion」を発表しました。Anthropicは発表の中で、このシステムはGoogleのPiperやMetaのSaplingといった既存のシステムから得られた「苦労して得た教訓」に基づいて構築されたと述べています。しかし、Scionの技術的な実装、特に「blame」などの操作を最適化するための「派生データ」の使用は、MetaのSaplingプロジェクトのコンポーネントであるMononokeの設計とほぼ同一であることがオープンソースコミュニティによって特定されました。
Scionの核心的なメカニズムは、複雑なクエリに効率的に答えるために、変更セット(changesets)から追加のデータ構造を構築することです。変更セットは変更点のみを記録するため、特定の行を最後に編集した人物を迅速に特定することはできません。Scionは、親の変更セットから再帰的に計算されるファイルblame、パス履歴、コミットグラフのインデックスである「派生データ」を作成することでこれを解決します。これは、早くも2017年から2018年に開発されたMononokeのアーキテクチャを反映しています。批判的な意見としては、Anthropicは広範なSaplingプロジェクトを認めているものの、派生データモデルの実際の技術的設計図を提供したMononokeを具体的にクレジットしていないことは、用語やデータモデルがほぼ同一であることを考えると、盗作に近い行為であると主張されています。
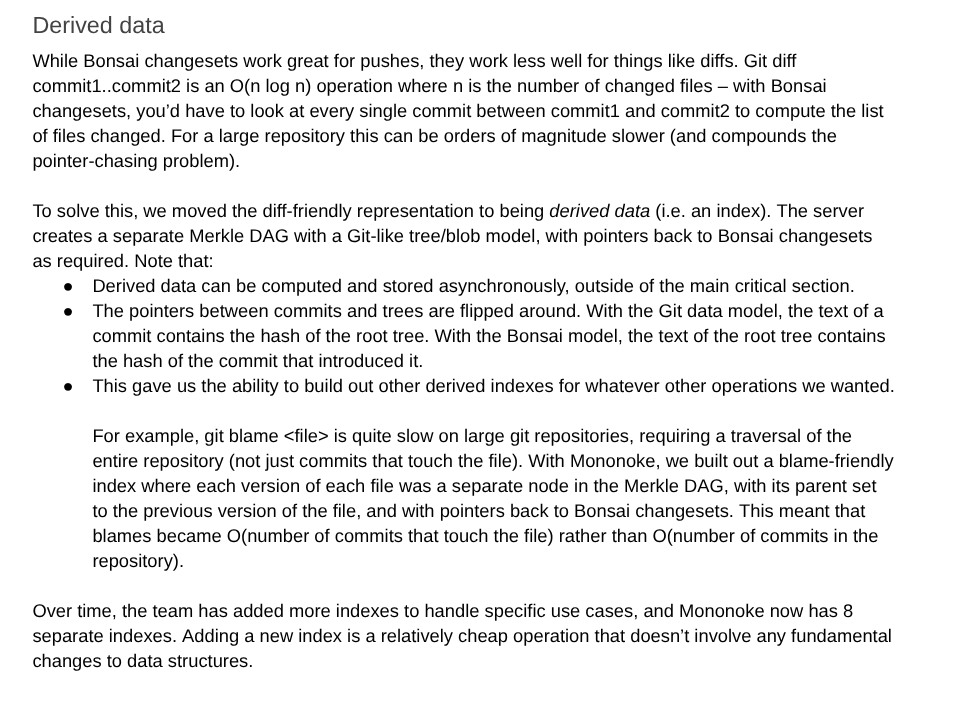
この画像は、Scionの設計の主な比較対象となっているMononokeの派生データの技術的アーキテクチャを説明している。
この論争は、大規模言語モデル(LLM)の時代における高まりつつある緊張を浮き彫りにしています。Mononokeはオープンソースであり、ClaudeやGPTのようなモデルのトレーニングセットに含まれているため、これらのモデルは元の人間の制作者への帰属を示さずに、複雑で非自明なエンジニアリング設計を容易に複製することができます。一部の観察者は、LLMによって「vibe-code(感覚的なコーディング)」やシステム全体のゼロからの生成が安価になるにつれ、「知的財産の洗浄(IP laundering)」のリスクが増大していると示唆しています。これは、イノベーションの元のソースを認めずに、AI支援の開発チームによって貢献が瞬時に抽出され再ブランド化される可能性がある場合、オープンソースプロジェクトを共有し維持する動機が低下するという長期的なリスクを生み出します。
既製品のソリューションが企業の規模に完全に適合しない場合、カスタムシステムを構築することは正当なエンジニアリングの選択であると主張する者がいる一方で、類似性が非常に高いため、独立した発見ではなく直接的な派生であることを示唆していると指摘する者もいます。議論は、既存のオープンソースリポジトリに基づいてコードを生成するためにLLMを使用することが、帰属のための新しい基準を必要とするのか、あるいは現在の「苦労して得た教訓」という枠組みで現代のソフトウェア開発において十分なのか、という点に集中しています。
結局のところ、この状況はソフトウェア制作の変化を強調しています。AIによって複雑なシステムを構築するコストは大幅に低下しましたが、基礎となるロジックの出所は不明なままです。オープンソースコミュニティにとっての課題は、AIがその労働の結果をいとも簡単に複製できる環境において、元のイノベーションにおける「人間」の労働が認識され続けることを保証することです。
ScionとMononokeの技術的な違いは、依然として論争の争点となっています。Scionの実装はプロプライエタリ(独占的)ですが、blameに適したインデックスを作成するためにMerkle DAGを使用するという基礎的なロジックは、Mononokeの設計から直接引き継がれたものです。これは、現代の開発における特定のトレードオフ、すなわちAI支援による作成のスピードと、構築されるソフトウェアの知的系譜の保存との対立を浮き彫りにしています。
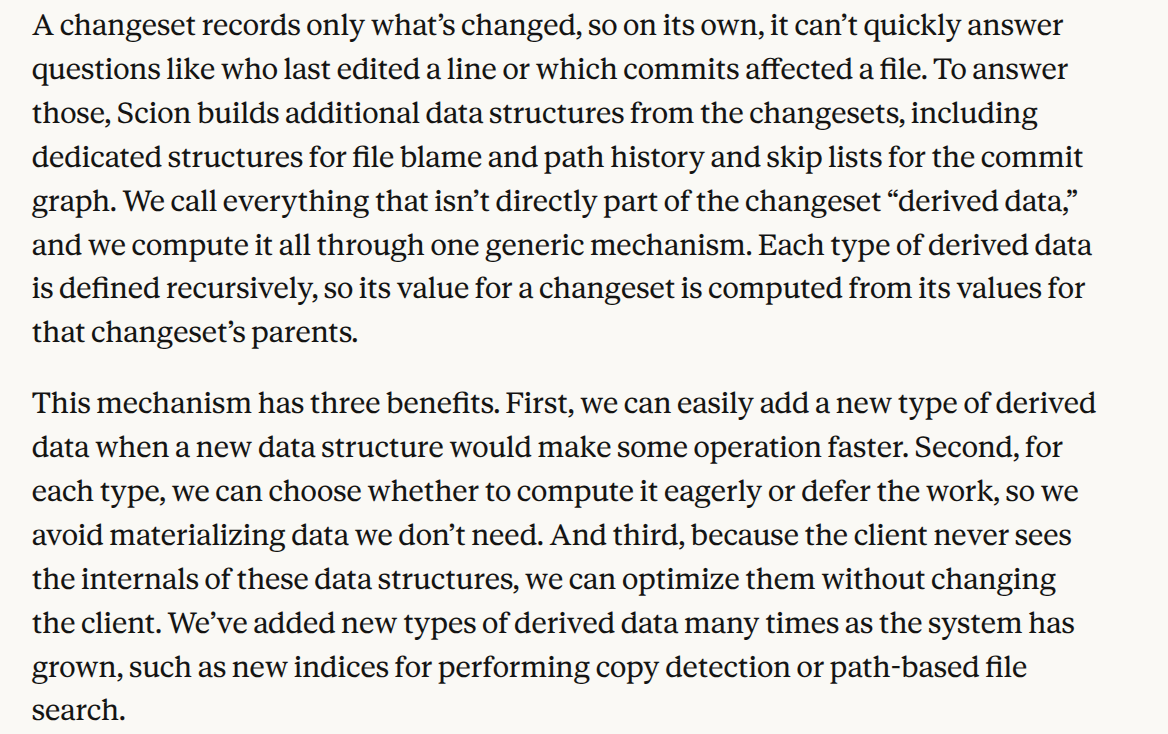
この視覚資料は、設計の類似性の論争の核心であるScionの派生データの具体的な技術実装を描写している。
Anthropicが潜在的なIPOを含む将来の節目に向けて準備を進める中、そのエンジニアリング慣行に対する監視は、業界全体のケーススタディとなっています。これは、企業が、結果としての製品を斬新なイノベーションとして提示しながら、高価値なアーキテクチャ設計を求めてオープンソースリポジトリを「剥掘(strip mine)」するためにAIを使用するという倫理を、どのようにナビゲートしていくかという問いを投げかけています。]