Liquid AIは、LFM2.5ファミリーの中で最大のモデルであるLFM2.5-24B-A2Bをリリースしました。このモデルは、プライバシーの確保と低レイテンシを実現するために、クラウドではなくユーザーのハードウェア上でローカルに動作するAIシステムである「オンデバイス」エージェント向けに特別に設計されています。このモデルはMixture-of-Experts(MoE)アーキテクチャを採用しており、総パラメータ数は240億と大きい一方で、生成される各トークンに対してはその一部(20億)のみをアクティブにする仕組みになっています。この設計により、コンシューマー向けのハードウェア上で、同等のMoEモデルよりも大幅に高速な動作が可能となり、例えばApple M5 Maxでは毎秒184トークンの速度を達成しています。

この画像はLFM2.5-24B-A2Bモデルの主要なビジュアルであり、高速なオンデバイス・エージェントとしての役割を説明しています。
LFM2.5-24B-A2Bモデルは「推論専用」モデルであり、最終的な回答を出す前に明示的な思考の連鎖(Chain of Thought)を生成するようにトレーニングされています。このアプローチは、MoEアーキテクチャの高いデコード速度を活用しながら、回答の質を向上させることを目的としています。複雑なエージェント・タスクをサポートするため、このモデルは教師あり微調整(SFT)、教師の専門化、およびエージェント的強化学習を含む5段階のポストトレーニング・パイプラインを経てきました。これらの段階は、モデルがOpenClawやHermes Agentといった普及しているエージェント・ハーネス内でのツール呼び出し、マルチターン・トラジェクトリ、およびインタラクション・パターンを習得するのを助けるために設計されました。
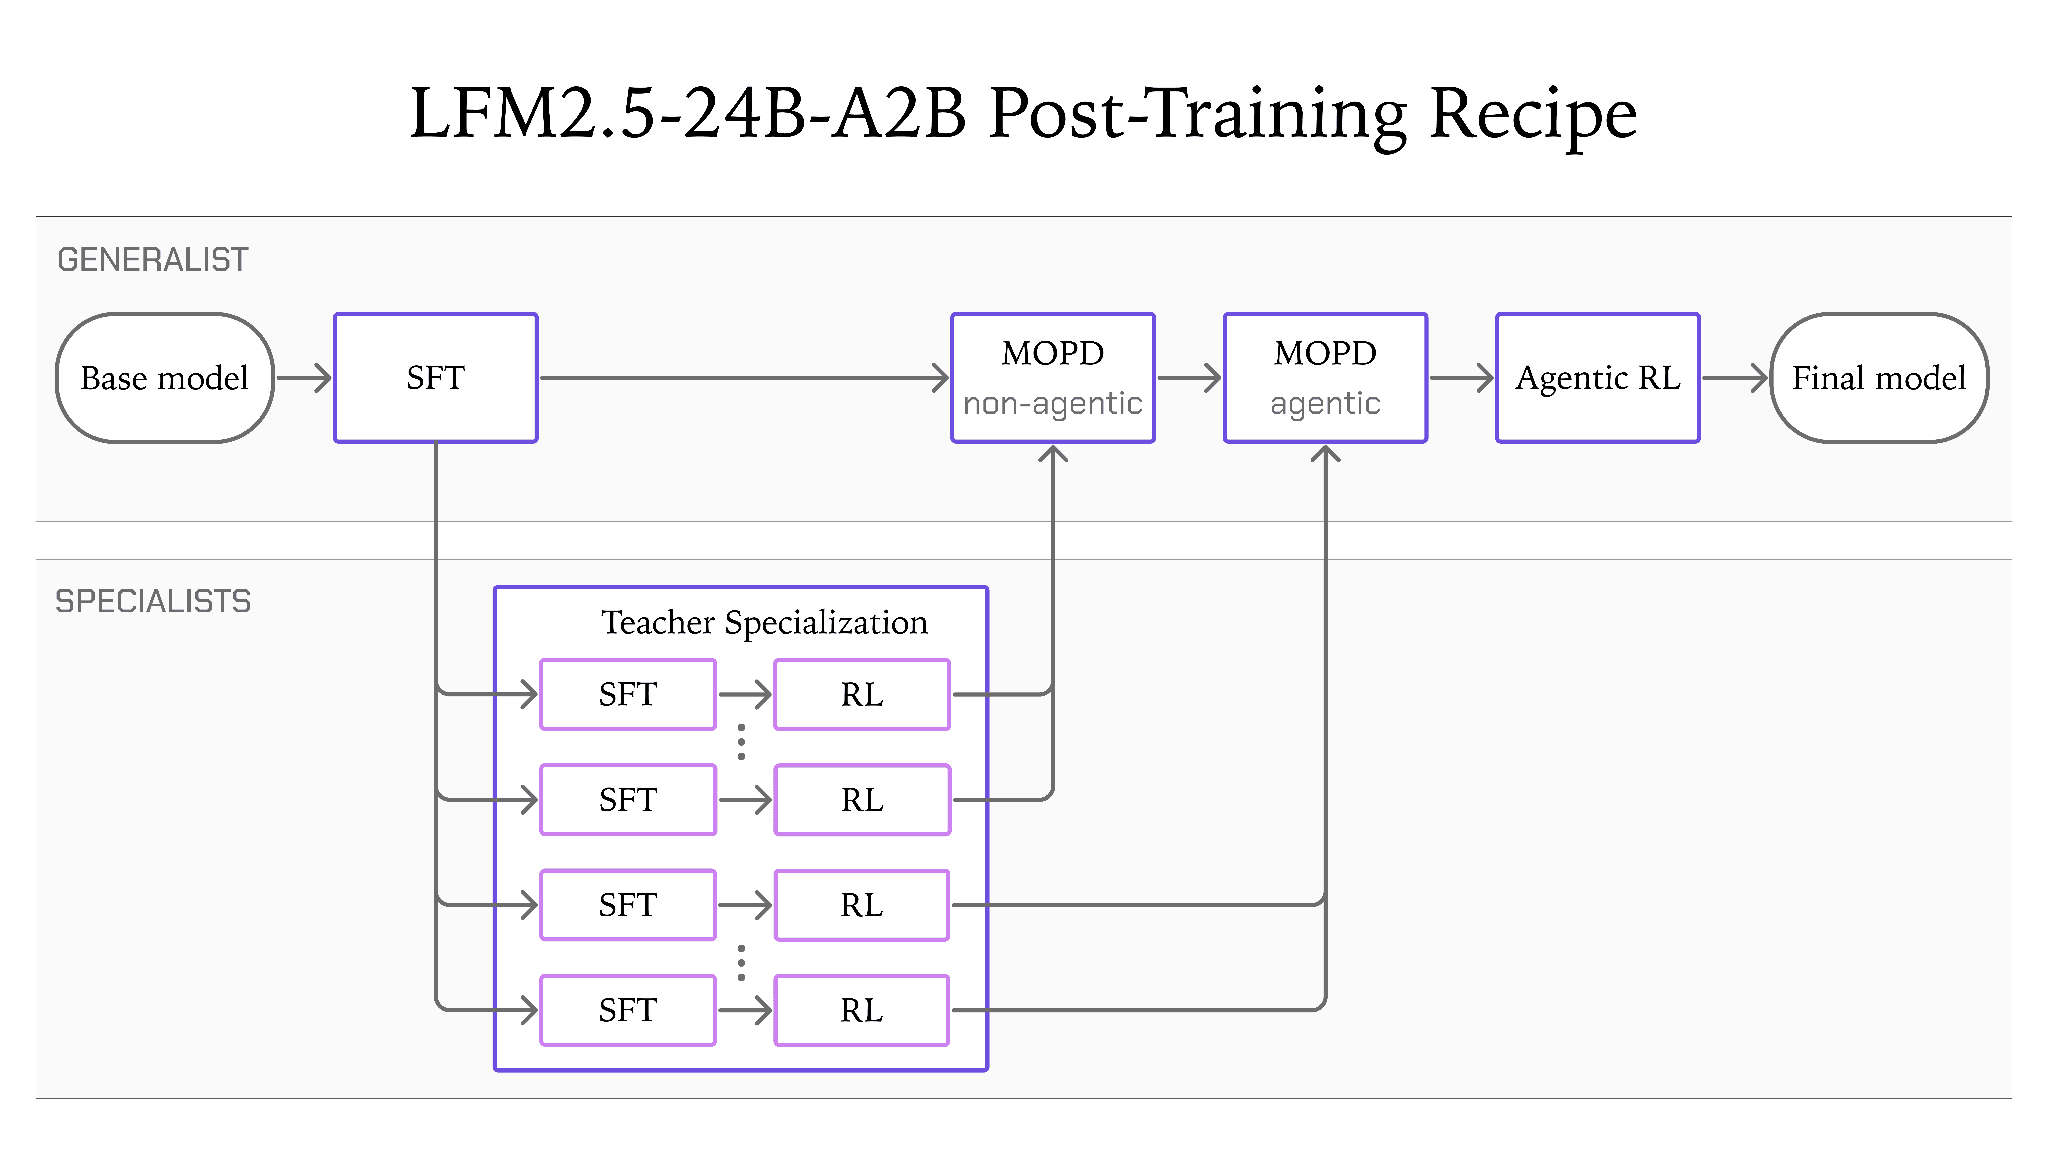
この図は、テキスト内で言及されているSFTやエージェント的強化学習を含む特定のトレーニング段階を説明しています。
このモデルは、ツール利用や指示遵守のベンチマークにおいて強力な性能を示しており、AutomationBenchなどのカテゴリーでは一部のより大きなモデルを上回っていますが、知識の密度が高いタスクにおいてはトレードオフが生じます。Liquid AIは、深い事実知識を必要とするワークロードについては、検索拡張生成(RAG)やウェブ検索と組み合わせるべきであると指摘しています。さらに、このモデルは速度と特定のエージェント・ワークフローにおいて優れていますが、ユーザーからは、より大きなモデルと比較して複雑なコーディング・タスクでは苦戦する可能性があるとの指摘もあり、最適化された推論速度と専門領域における深い推論能力のバランスが浮き彫りになっています。