市場データは、連続的かつ離散的要素が混在するため、モデリングにおける独特の課題となる。例えば価格などの個々の属性は連続的に変化する一方で、オーダーブックは注文の配置、キャンセル、執行といった離散的イベントを不規則な間隔で経時的に変化させる。この二重性により、純粋に連続的あるいは純粋にカテゴリアルなデータを前提とする従来の生成モデルは、金融時系列のマイクロ構造を捉えることが困難になる。定量金融では、過去の市場データストリームから将来の価格を予測することが一般的だが、現実的な合成データを生成するには、価格やタイミングといった変数の連続的ダイナミクスと、イベントタイプの離散的性質の両方を保持する必要がある。Jane Street のインターンプロジェクトを Kavish が率い、画像、ビデオ、ロボット工学、音声生成で成功した手法をオーダーブックイベントの特性に適応させることで、自己回帰拡散がこのギャップを埋め得るかを検討した。
チームはエンコーダ‑ディフューザーアーキテクチャを構築した。因果マスクのかかったトランスフォーマーエンコーダはシーケンスの各位置に対する潜在埋め込みを作成し、これが小さなカテゴリアルヘッドに供給され、次のイベントがトレードかベストビッド/オファー(BBO)アップデートかを予測する。一方、ディフュージョンヘッドは価格、経過時間、サイズなどの連続的ターゲットを生成する。初期実験では、1,000ステップのコサインスケジュールとDDIMサンプリングを用いたDenoising Diffusion Probabilistic Model(DDPM)を使用したが、この構成は不安定であった—生成軌道はすぐに発散し、すべての連続的ターゲットにおいて平均から8シグマを超える値が88‑95%を占めた。あるHacker Newsのコメントでは、『DDPMは破綻する。なぜならオーダーブックイベントの間隔は滑らかなガウスではなく離散的な点質量だからだ』と述べられていた。ノイズとデータの間を線形補間し、ネットワークにその直線上での速度を予測させるflow matchingに切り替えると、追加の調整なしで安定した性能が得られた。市場データに固有の不連続性(たとえば、タイミングがゼロや整数秒周りにクラスターし、価格がビッド/アスクミッドポイントに集中するなど)に対処するため、Kavishはカテゴリアルヘッドを20クラスに細分し、一般的なイベントサブタイプを表現し、『アトムスムージング』と呼ばれる手法を開発した。この手法はスパイク状の分布を滑らかにし、その後スパイクを再形成して確率質量を保ちつつ人工的な不連続性を生じさせない。
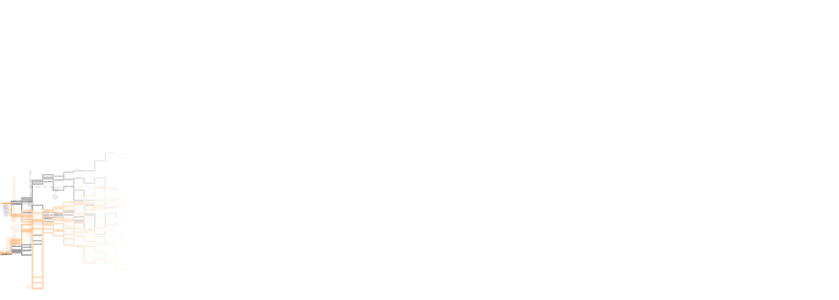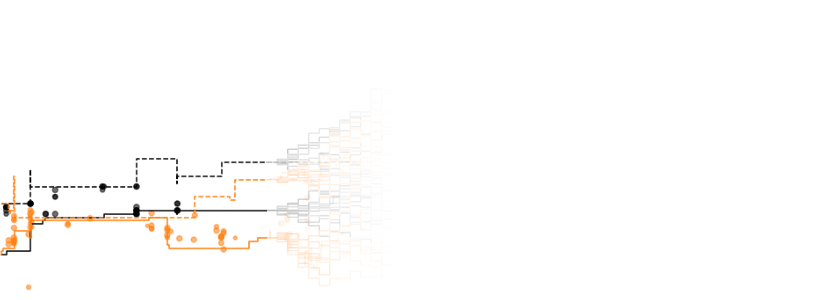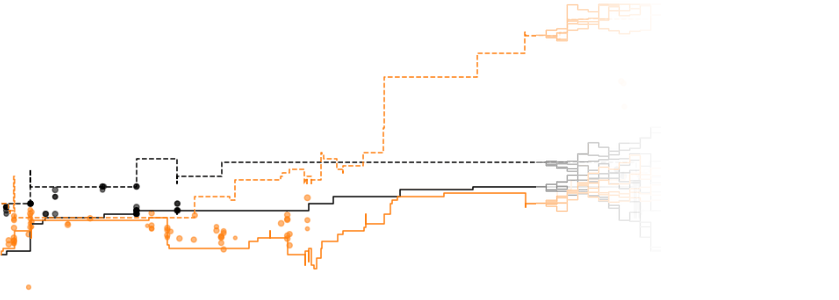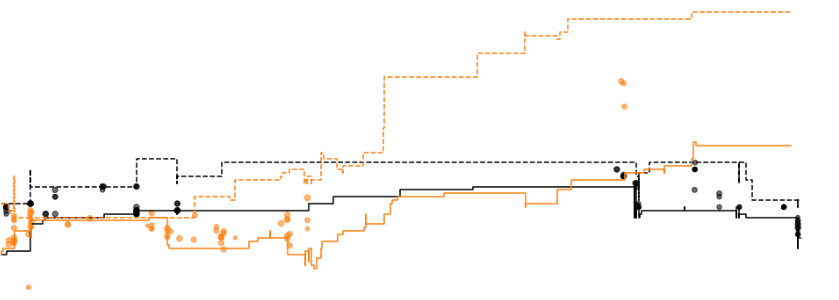
この画像は、記事で述べられているエンコーダ‑ディフューザーアーキテクチャを示しており、トランスフォーマーエンコーダがイベントタイプを予測し、ディフュージョンヘッドが価格や時間などの連続的変数を生成する。
評価の結果、atom squeezingを適用したflow matchingモデルは、真のデータにより近い周辺分布を生み出し、モデル出力と実際のイベントを区別するように訓練された分類器で判別した際により現実的なサンプルが得られた。しかし、自己回帰ロールアウトにより、長い時間軸での合成軌道が劣化することが明らかになり、合成されたCME米国価格のスプレッドが実際のデータよりも広がり、誤りが蓄積していることを示した。したがって、このモデルはまだ実用的な市場データジェネレーターとして十分な精度には達していない。このインターンシップを通じて、今後の作業に向けた二つの公開された疑問が明らかになった。すなわち、どの程度の離散性を明示的にモデル化すべきか、あるいは拡散プロセスに任せるべきか、そして拡散がオーダーブックデータの複雑でスパイクの多い統計を効果的に学習できるように、特徴分布をどのように表現し滑らかにすべきかである。別のコメントでは、『本当の物語は、離散的でも連続的でもない時系列データに拡散モデルを適用したこの素晴らしい解説にある』と観察された。