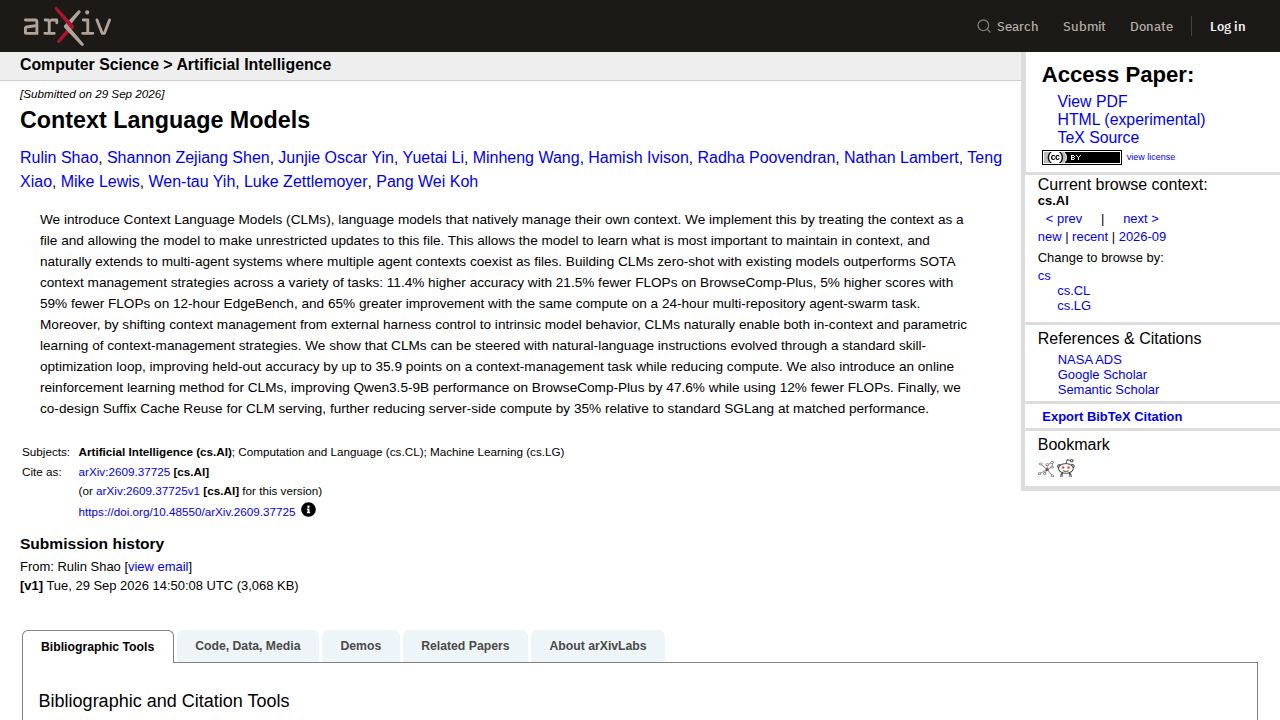
コンテキスト言語モデル(CLM)は、コンテキストを自由に更新できるファイルとして扱うことで、言語モデルが固有に自身のコンテキストを管理する新たなアプローチを提示する。主要なソースによれば、この実装は『コンテキストをファイルとして扱い、モデルにこのファイルへの無制限な更新を許可する』ものであり、これによりシステムは保持すべき最も重要な情報を学習できる。これは、ハーネスやプロンプト技術を通じて外部から制御される従来の手法とは対照的である。
論文では、既存のモデルに対してゼロショットでCLMが複数のベンチマークにおいて最先端のコンテキスト管理手法を大きく上回ることを示している。具体的には、『BrowseComp-Plusでは精度が11.4%向上しFLOPsが21.5%削減、12時間EdgeBenchではスコアが5%向上しFLOPsが59%削減、同じ計算量での24時間マルチリポジトリエージェントスウォームタスクでは改善が65%大きい』と研究結果が示されている。これらの結果は、CLMが計算資源を大幅に削減しながら優れたパフォーマンスを達成することを示している。
効率の向上に加えて、CLMは外部システムからモデル自身へ制御を移すことで、コンテキスト管理戦略のインコンテキスト学習とパラメトリック学習の両方を可能にする。さらに、研究では標準的なスキル最適化ループを通じて進化した自然言語命令でCLMを操舵でき、コンテキスト管理タスクにおける保持外精度を最大35.9ポイント向上させながら計算量を削減できることを示している。また、共同設計されたCLMサービス用のSuffix Cache Reuseは、同等のパフォーマンスにおいて標準のSGLangと比べてサーバーサイドの計算量を35%さらに削減する。