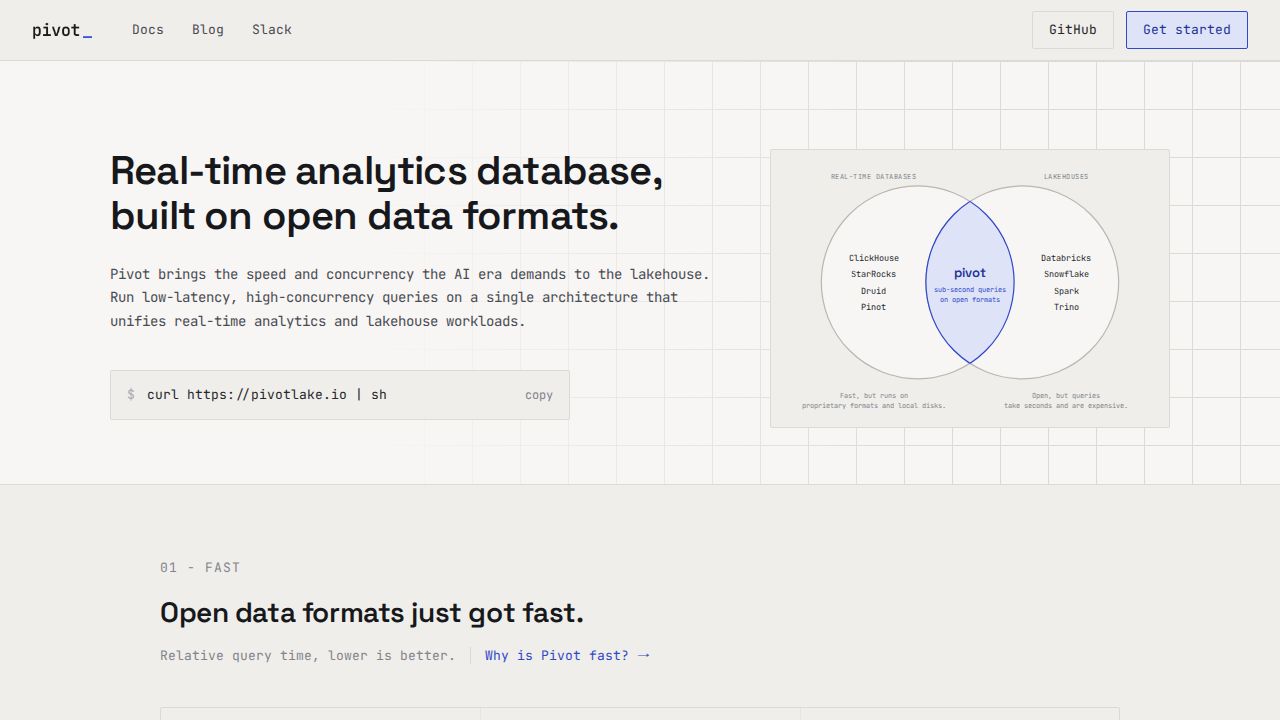
Pivotは、データをプロプライエタリーエンジンに最初にコピーすることなく、Apache IcebergやDelta Lakeなどのオープンデータフォーマット上で、低レイテンシかつ高い並行性でSQLクエリを実行できるオープンソースのアナリティクスデータベースです。PostgreSQLプロトコルをポート5432で話すため、既存のSQLクライアント、ビジネスインテリジェンスツール、AIエージェントはpsqlまたはPostgreSQL互換ドライバーを使って接続し、オブジェクトストレージに残ったデータをクエリできます。
プロジェクトのドキュメントに含まれるパフォーマンス測定によると、Pivotは既存のアナリティクスデータベースよりも高速です。ClickBenchの43のクエリからなるスイートでは、Pivot(Parquet)は相対時間1.09×を記録しました。これに対し、ClickHouse(ネイティブ)は2.17×、DuckDB(ネイティブ)は4.17×でした。つまり、PivotはClickHouseのほぼ2倍の速さで、DuckDBのほぼ4倍の速さで動作します。TPC‑H SF1000ベンチマークでは、Pivot(Parquet)をベースラインの1.00×とし、DuckDB(Parquet)は2.16×、ClickHouse(ネイティブ)は3.10×、Sparkは53.73×でした。プロジェクトはこれらの利点を、Rustベースのエンジンによるものと説明しています。このエンジンはインメモリデータにArrowを使用し、スレッドパーコア実行モデル、カスタムメモリアロケータ、そして現代のCPUメモリ帯域幅を最大限に活用するチューニングされたJOINとGROUP BYアルゴリズムを特徴としています。
速度以外にも、Pivotは運用の柔軟性とオープンネスを重視します。オブジェクトストレージを唯一の真実のソースとして扱い、メモリには一時的な状態のみを保持するため、インスタンスはほぼ瞬時にスケールアップ、スケールダウン、またはゼロにすることができます。これにより、突発的なワークロードやコスト削減のためのオートスケーリングが可能になります。ユーザーは、同時アクセスのために共有サーバーとしてPivotを実行するか、ターミナルからローカルで起動してアドホッククエリを実行するかのいずれかを選択できます。両方のパスはオブジェクトストレージ内の同じテーブルにアクセスします。ベンチマークハーネスとクエリはリポジトリで公開されており、報告された数値はAWS c8gd.metal‑48xlインスタンスで取得されたため、他のハードウェアやワークロードでは結果が異なる場合があります。