openTPUは、RTL、ISA、シミュレータ、コンパイラ、プロファイラのツールを1つのモノレポに組み合わせたオープンソースのAIアクセラレータプロジェクトです。そのドキュメントによれば、このプロジェクトはAIエージェントがハードウェア設計においてどれだけ進歩できるか、および自分たちの推論を実行できるチップを作成できるかを探求しています。アクセラレータの実装全体は、SystemVerilogによるハードウェア設計、定義された命令セット、ビット精密なシミュレータ、カスタムカーネル言語とそのコンパイラ、そして物理的なPCIe FPGAカード(Inspur YPCB-00338、Xilinx Kintex-7 xc7k480tおよび2チャネルのDDR3)を駆動するホストソフトウェアを含むリポジトリに存在します。
この画像は、記事で説明されているopenTPUのモノレポを表しており、ハードウェア設計、命令セット、シミュレータ、コンパイラ、プロファイラツールを含んでいます。
このアクセラレータは、シーケンサが1サイクルごとにDMA、行列乗算(int8重みはDRAMからストリーム)、ベクトル演算(fp32)、および量子化ユニットに1つの命令を発行するシンプルな実行モデルを使用しており、キャッシュや隠れたスケジューリングはありません。性能測定によれば、FPGAカードはシミュレータと同等のトークン生成レートを達成し、ハードウェアはビット単位で完全に同じトークンシーケンスを出力します。たとえば、LFM2.5-230Mモデルをint8精度で実行すると、デバイス上で59.0トークン/秒、ウォールクロック時間で52.3トークン/秒を達成し、利用可能なDRAM帯域幅の85%を使用します。プロジェクトの量子化スキームを使用してHugging Face Transformersと検証した結果、Qwen3-0.6BやLFM2.5-230Mなどのモデルでトップ1の一致率が96%以上となり、KLダイバージェンスは低く抑えられています。
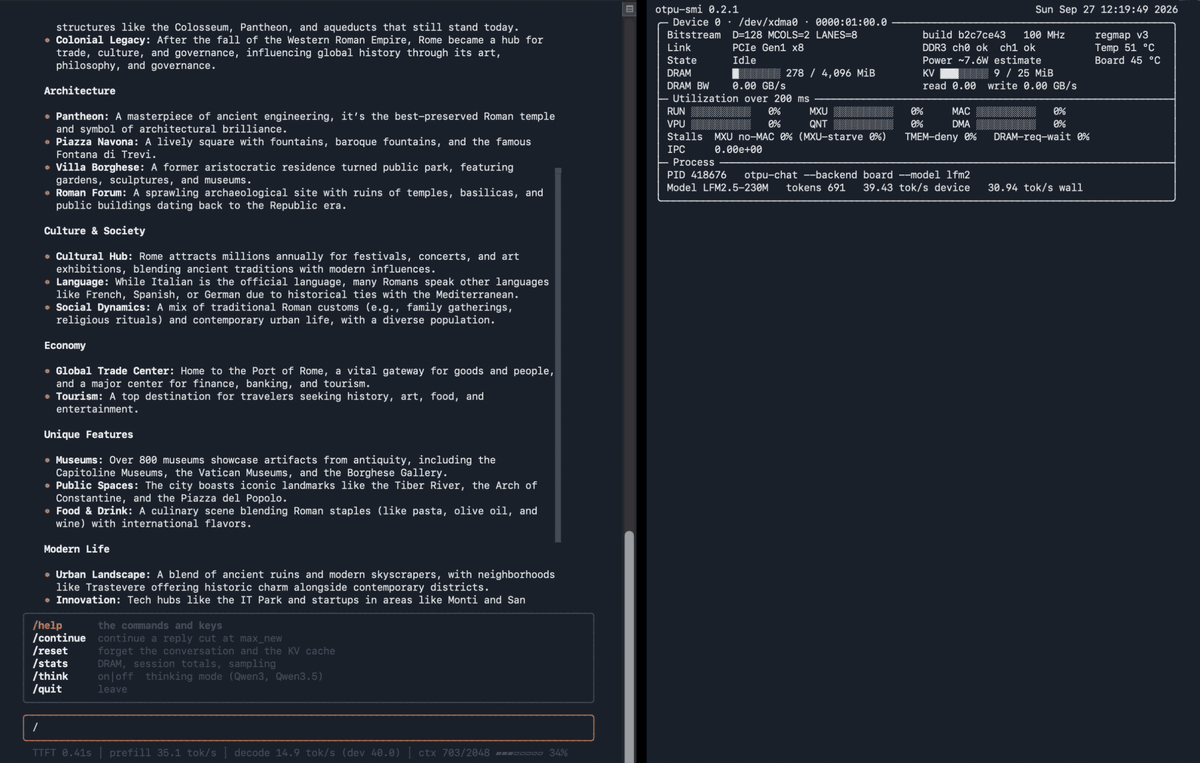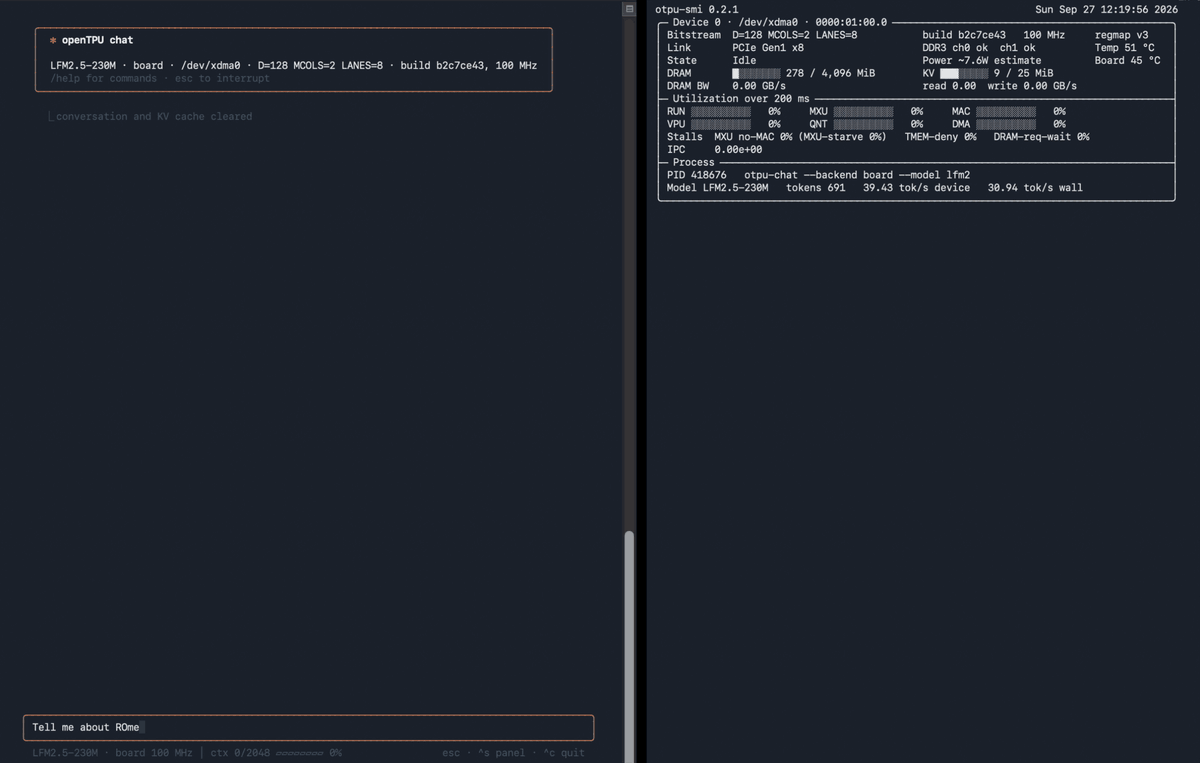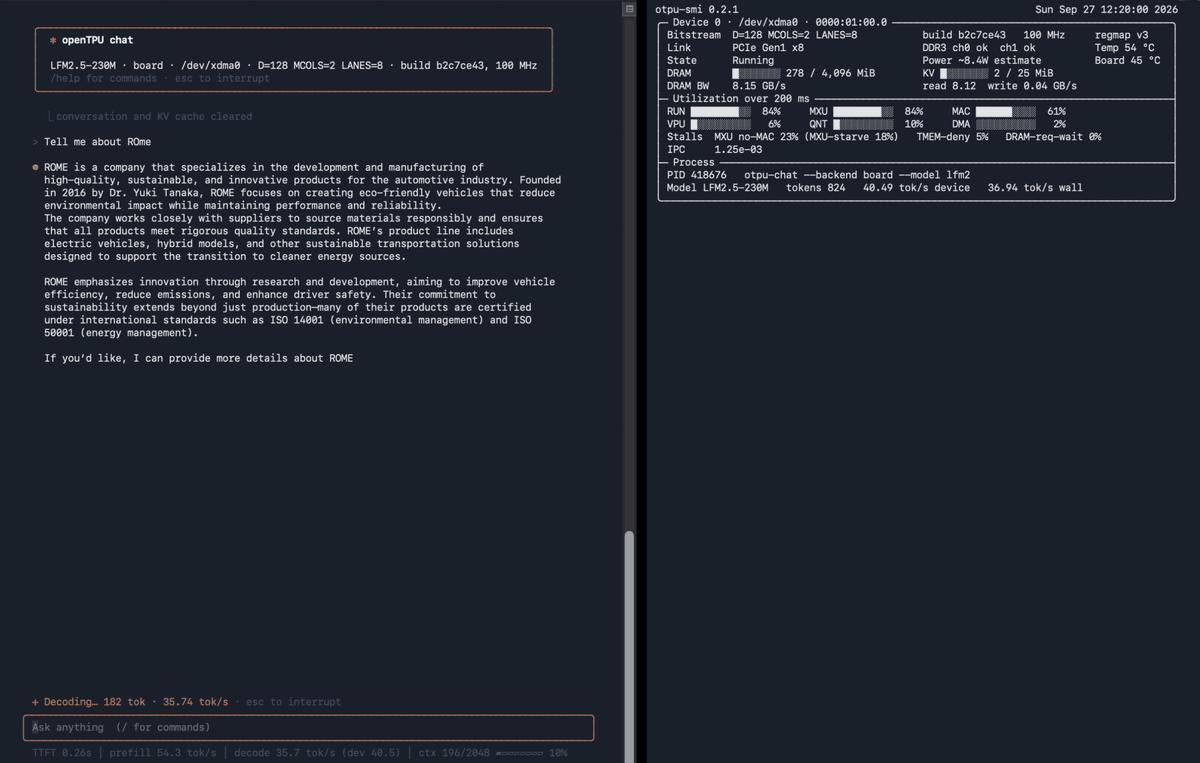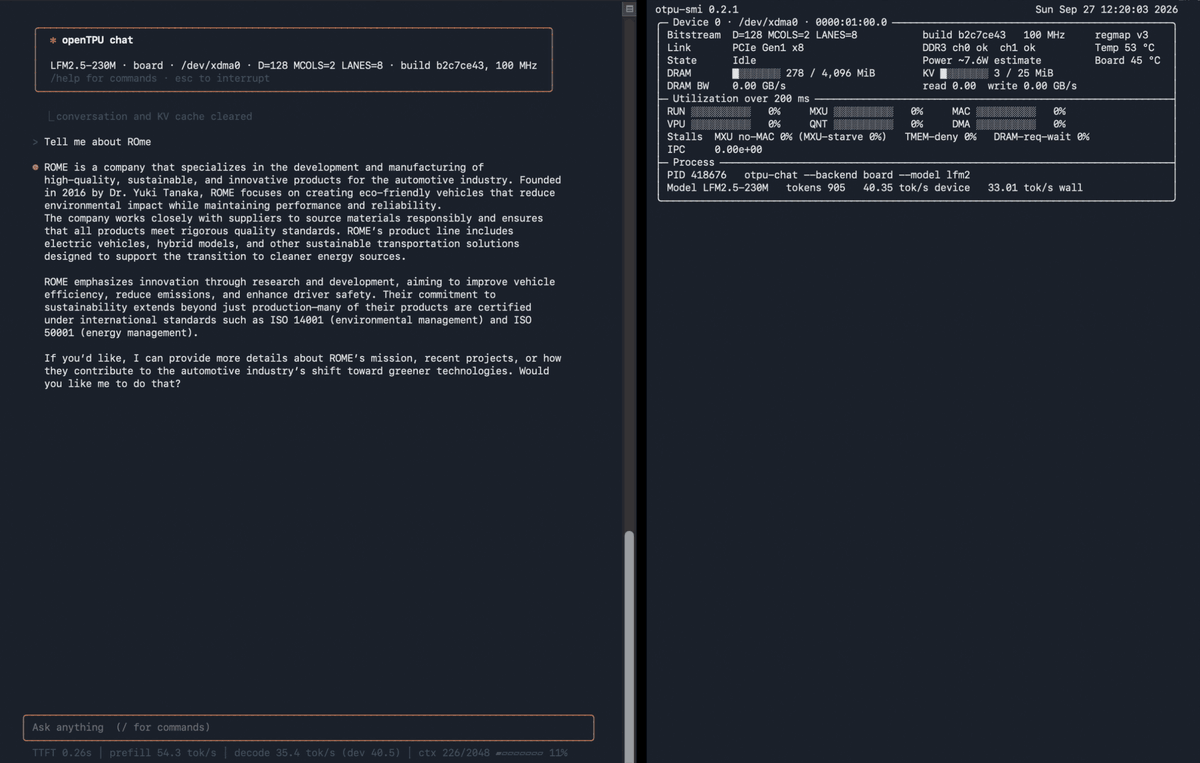
この画像は、量子化言語モデルを実行するopenTPUアクセラレータの実際のパフォーマンスを示しており、記事でのトークン生成レートとシミュレータ完全一致の出力に関する議論と一致しています。
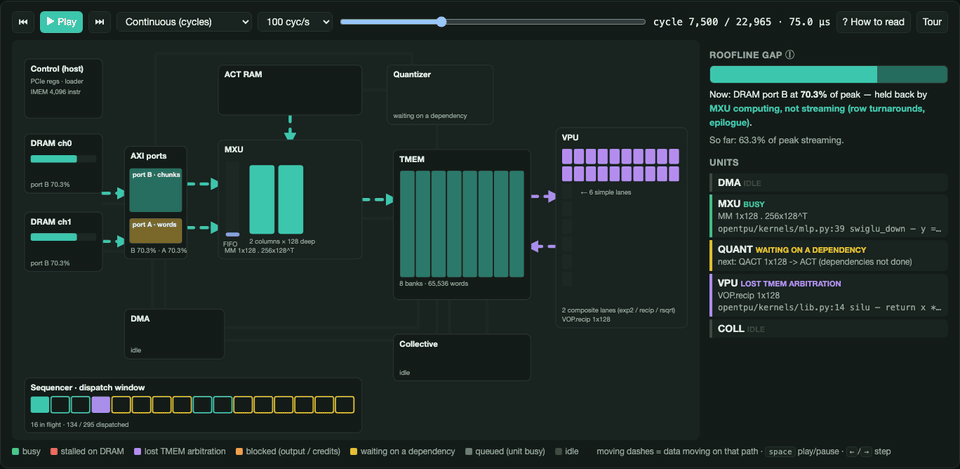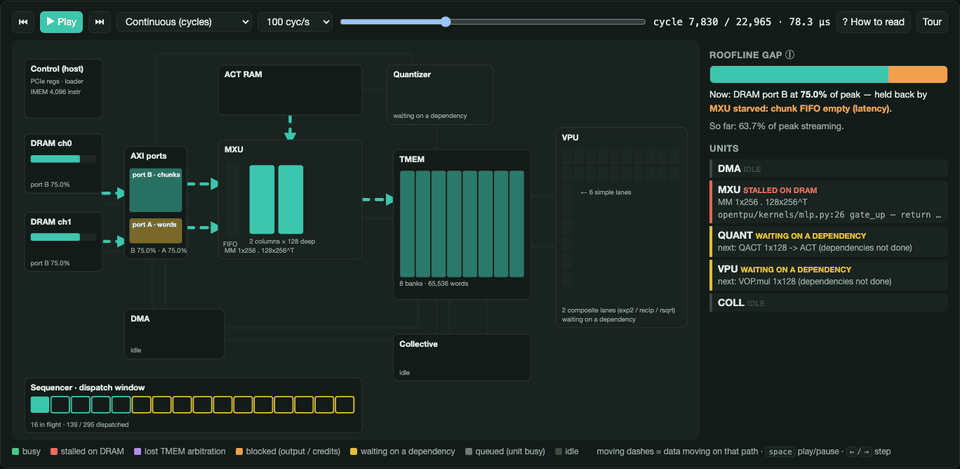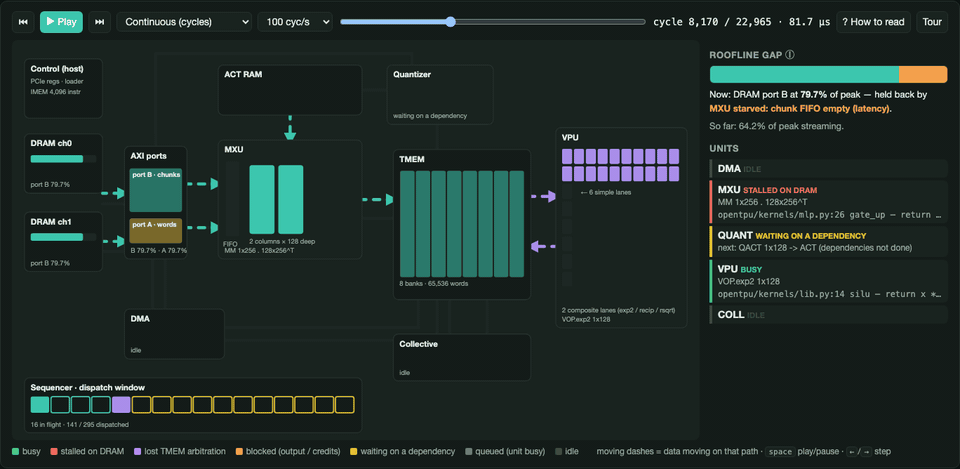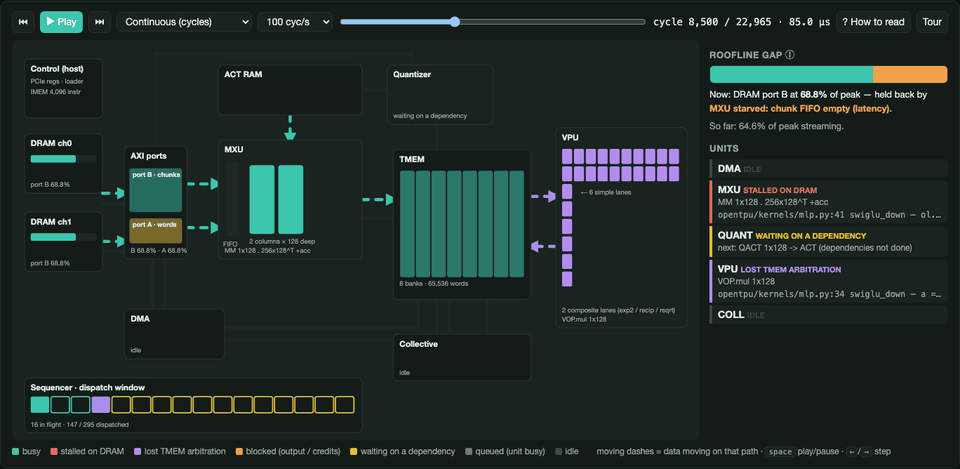
この画像は、ハードウェアフロアプランとデコードステップのランタイム動作を示しており、記事でのビット精密シミュレータとQwen3の実行に関する言及を裏付けています。
制限とトレードオフが存在します:カードの4 GiB DRAMを超える混合エキスパートモデル(例えばQwen3.5-35B-A3B)では、エキスパートがホストストレージからPCIe経由で1トークンあたり最大153 MBの速度でストリーミングされます;4ビット重み量子化はメモリ使用量を約3分の1に削減し、デコード速度を40%-45%向上させますが、プロジェクトのドキュメントで報告されているように測定可能な perplexity コストが発生します;また、Qwen3.5のprefillなどの特定の操作は、実行前に各チャンクのプログラムをホスト側でコンパイルする必要があり、ホストがすべてのワークロードから完全に離れているわけではないことを示しています。