Jane Street の内部メッセージング フレームワークである Aria は、1 日あたり数テラバイトのデータを処理し、サブスクライブしているクライアントにライブ メッセージ ストリームを提供しています。 Aria の使用量が増えるにつれ、システムは 2 つの復旧プロセスでパフォーマンスのボトルネックに直面しました。つまり、遅れを取っているクライアントがインメモリ リング バッファから最近のメッセージを要求する tip 復旧と、再起動したクライアントが週の初めからの歴史的メッセージを要求する initial 復旧です。これらの操作は負荷増加に伴い締め付けられ、夏のインターンである Theodor Totev がメッセージ フィルタリングを効率化する方法を調査するきっかけとなりました。
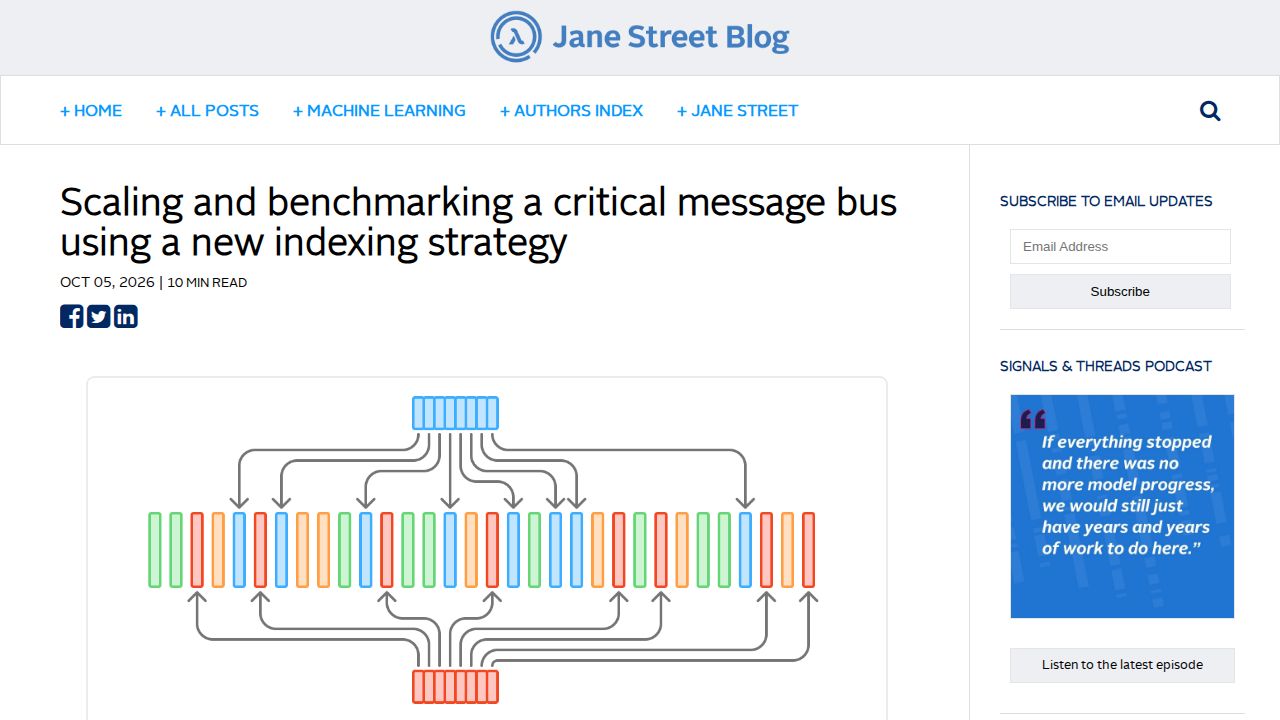
tip 復旧を高速化するため、 Totev はストリーム全体の naïve な線形スキャンを、各トピック パーティションのインデックスに置き換えました。トピック パーティションとは、同じ 2 セグメント プレフィックス(例: 'app/codestore' の下のすべてのトピック)を共有するトピックのグループです。クライアントがメッセージを要求すると、 Aria は関連するパーティション インデックスを最小ヒープを使って n‑ウェイ マージし、必要なメッセージ ストリームを順序どおりに再構築します。ベンチマークでは、標準のヒープ実装を fast_heap_unboxed バージョンに置き換えることで、インデックスを使用した復旧コードのパフォーマンスが 2 倍になり、本番ワークロードにおける CPU 使用率が観測的に 30% 低下しました。このときシステムの厳格な正しさの要件は保たれました。
initial 復旧に対して、 Totev は別の非効率性に取り組みました。 Aria のディスク上のストレージは当初、トピック名の最初の 3 セグメントに基づく単純なヒューリスティックでメッセージ セグメントをサブツリー ストアに分割していました。これにより、高ボリュームのトピックが低ボリュームのトピックと同じストアに置かれる可能性がありました。その結果、小さなトピックを読むクライアントは、関係ない大量のデータをフィルタリングしなければならず、必要以上のバイトを最大で 10 倍読み込むこともありました。 Totev はトピックごとの実際のメッセージ ボリュームを分析し、貪欲クラスタリングと二分探索を組み合わせた適応的な分割アルゴリズムを考案しました。このアルゴリズムは、メッセージ ボリュームが大きいトピックには独自のサブツリー ストアを割り当て、ボリュームが小さいトピックについては共有ストアにまとめることで、トピック固有の読み込み中の無駄なバイトを最小限に抑えます。