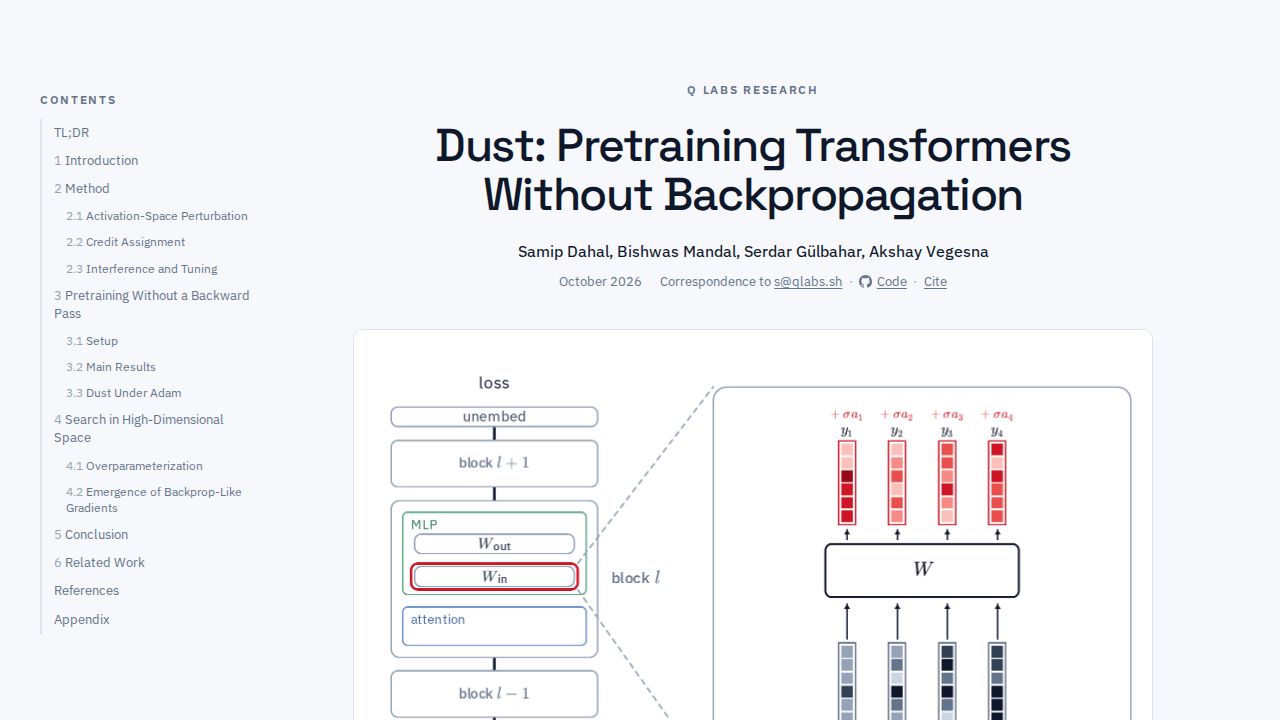
Dustは標準的なニューラルネットワークのトレーニング手法から根本的に逸脱しています。バックプロパゲーションは微分可能な計算を必要とし、連鎖律によって一次勾配を計算しますが、Dustはゼロ次最適化手法であり、アクティベーションを直接摂動し、損失の変化を測定することで勾配を推定します。一次情報源で述べられているように、この方法は各線形層の出力に、各トークンで独立してガウスノイズを加え、フォワードパスを実行し、そのトークンでの損失変化によってノイズに報酬を与えます。このアプローチは、研究者が『仮想的な人口』と呼ぶものを作り出します。ここで各トークンが人口のメンバーとなり、単一のフォワードパスで多くの摂動を並列に評価できます。これに対し、重み空間で動作する従来の進化戦略では、各摂動ごとに別々のパスが必要となります。
Dustの核となる効率の利点は、アクティベーション空間での摂動アプローチに起因します。重みではなくアクティベーションを摂動することで、Dustは重み空間での各人口メンバーを具現化する必要を回避し、EGGROLLのような重み空間進化戦略と比べて桁違いに効率的になります。一次情報源によれば、Dustは100万トークン以上から外挿した結果、EGGROLLのトランスフォーマー実装と比べて10^3から10^4倍の効率があるとされています。この効率の向上は、人口メンバーごとに逐次的に評価するのではなく、トークン間で摂動を並列に評価することから得られ、単一のフォワードパスで現代のトランスフォーマーにおける重み空間ESよりも少なくとも3桁大きい人口を評価できます。
実証結果は、Dustが既存の最適化手法と競争力があることを示しています。一次情報源によれば、Dustは大きな人口サイズではバックプロパゲーションに近似し、複数の設定ではそれを上回ることもあり、計算リソースが豊富な regime での利点を示唆しています。従来の常識では大きなモデルは人口効率が低いとされてきましたが、研究者らはDustを用いると大きなモデルほど実際には人口効率が高いことを発見しました:243Mパラメーターモデルは、ほとんどの人口サイズにおいて120倍小さいモデルを上回ります。さらに、人口が増えるにつれてDustによる勾配推定はバックプロパゲーションのものとより良い整合性を示し、1Bトークンまでのすべてのテスト済みスケールで良好な整合性が保たれています。これは研究者にとって、より大きなモデルと長いトレーニングランへのアプローチのスケーリングに対する励みとなっています。