Mistral AIは、同社で最も大きく、かつ最も能力の高いモデルであるMistral Large 4(ML4)のパブリックプレビューを公開しました。このモデルはネイティブマルチモーダルであり、複雑な文書、チャート、自然な画像にわたる推論が可能です。総パラメータ数は1兆に達しますが、520億のアクティブパラメータを持つMixture-of-Experts(MoE)アーキテクチャを採用しています。Mistral AIは2026年10月末までにモデルのウェイトを公開する予定であり、これにより組織はプライベートなインフラストラクチャにモデルをデプロイし、データとAIの主権をより高度に制御できるようになります。
ML4は、特にサイバーセキュリティとコーディングといった専門的な企業向け垂直分野において顕著な性能を示しています。サイバーセキュリティにおいて、ML4はArtificial Analysis Cyber Indexで世界トップ5のモデルの一つにランクされており、特に脆弱性の調査やパッチ適用を拒否しないため、特定のタスクにおいていくつかの主要なクローズドモデルを上回っています。コーディングにおいては、このモデルはCoding Agent Indexで49.8%のスコアを達成し、DeepSeek V4 ProやQwen3.8 Maxといった競合他社を上回りました。さらに、このモデルは完全なHartree–Fockシミュレーションの生成などの科学的ワークフローにおいて高い習熟度を示し、知識労働においても、HarveyAIのLegal Agentベンチマークや金融分析用のFinWorkBenchにおいてGPT-6-Astraを上回る性能を発揮しました。
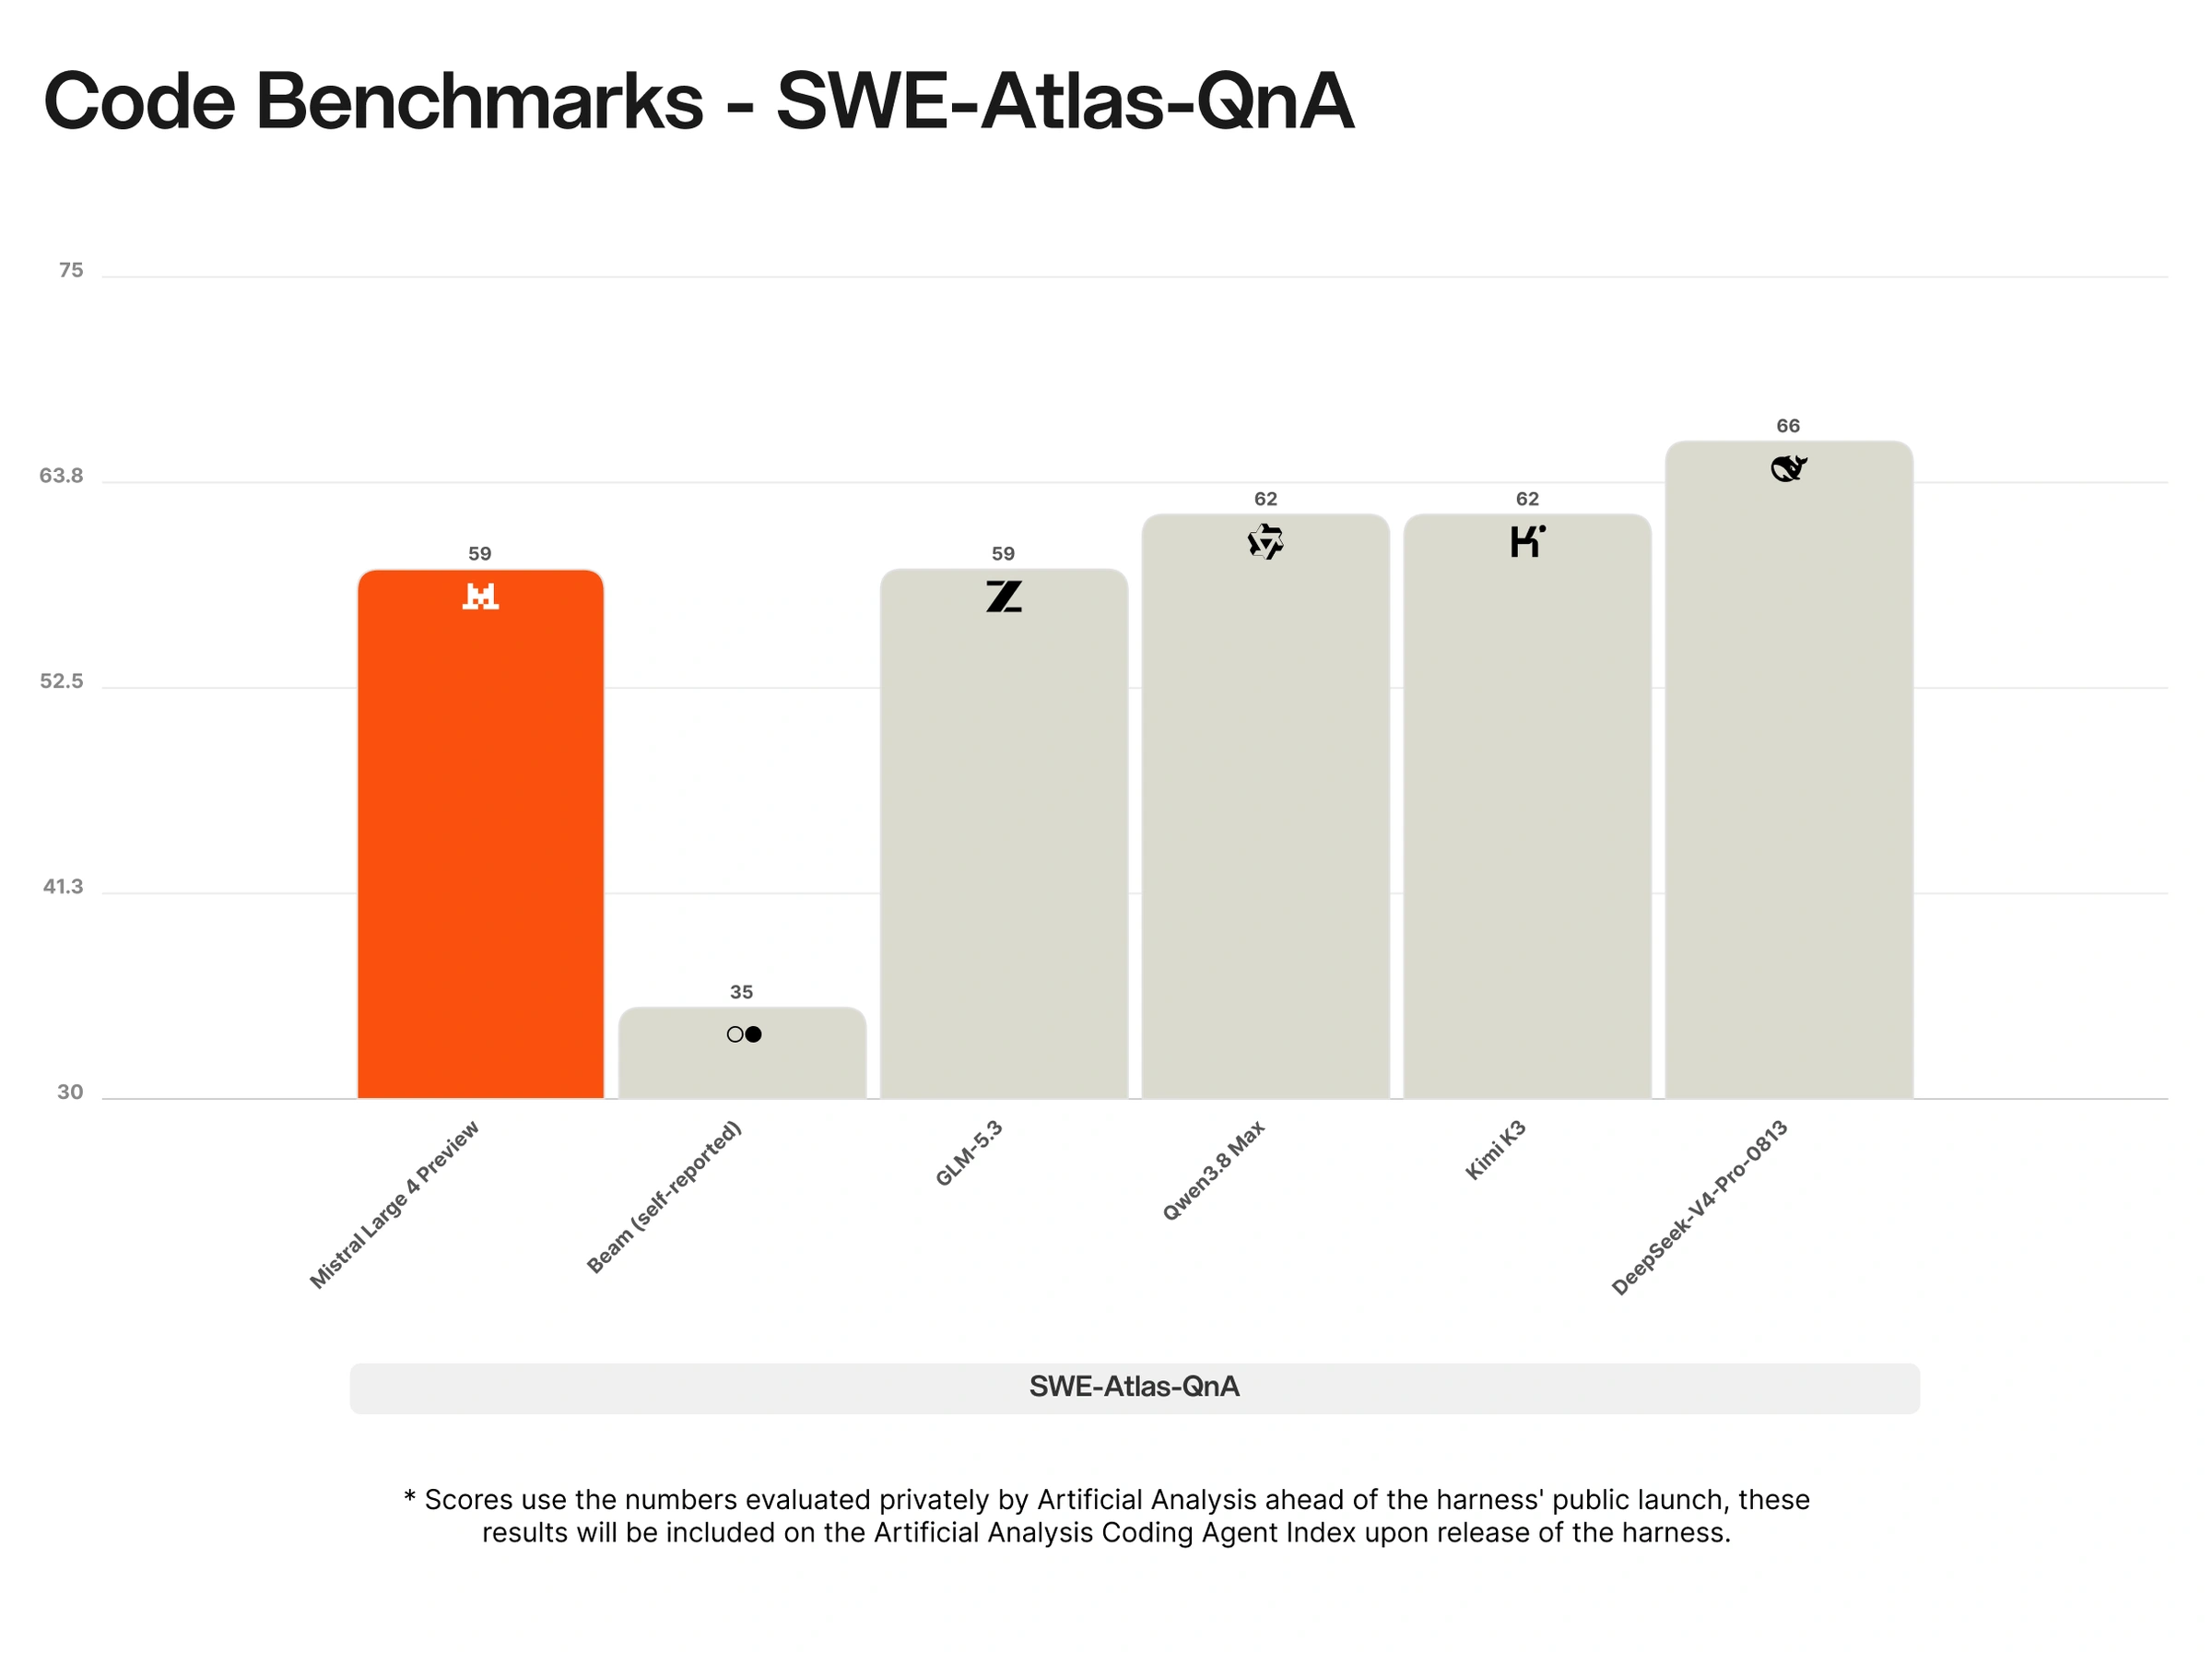
モデルのコーディングタスクにおける性能は、Coding Agent Indexでの高いスコアによって強調されています。

記事では、ML4がArtificial Analysis Cyber Indexで世界トップ5のモデルの一つにランクされていることが記されています。

このモデルは知識労働に優れており、特にHarveyAIのLegal AgentベンチマークでGPT-6-Astraを上回っています。
高い性能を誇る一方で、ML4は一部の特化したモデルと比較してコストと速度の面でトレードオフがあります。例えば、OpenRouterプラットフォーム上でDeepSeek V4.1 Flash 1017と比較すると、Mistral Large 4は入力価格が大幅に高く($1.36/M tokens 対 $0.049/M tokens)、中央値の処理能力も低くなっています(毎秒27.0トークン 対 44.0トークン)。さらに、ML4は高度な推論タスク向けに設計されていますが、初期のユーザーフィードバックの一部では、ドイツ語などの他言語でのやり取り中に中国語の文字を出力するといった、予期しない言語的挙動を示す可能性があることが示唆されています。Mistral AIは、欧州の法律の下での独立した運用を保証するため、自社の欧州データセンターにある3,800台のNVIDIA Grace Blackwell GPUを使用してモデルをトレーニングしました。