Strataが1250億パラメータの言語モデルをデスクトップにもたらした。モデルはQwenチームが実験的プレビューとして公開したQwen3.8-Flash-Nextで、次世代Qwen4の基盤となるアーキテクチャを先取りしている。MITライセンスのオープンソース推論エンジンStrataは、これを一般向けハードウェア――最近のNVIDIAまたはAMDのグラフィックカードを搭載したゲーミングPC――で実行し、24GBのカードでは約100トークン/秒の速度を達成する。データはローカルマシンから一切出ない。
冒頭の段落では、Strataを1250億パラメータモデルをデスクトップゲーミングPCにもたらすオープンソースエンジンとして紹介している。
このモデルは大規模だが、特異な構造だ。総パラメータ数は1250億だが、任意のトークン生成時に活性化するのは約60億のみである。これはMixture-of-Experts(専門家混合)モデルで、48層それぞれに512の専門家、合計約24,576の専門家を持ち、各単語に対して10のルーティング専門家と1つの共有専門家が選択される。残りは休眠状態だ。これが125Bモデルをステップごとに6Bモデルのように振る舞わせ、PCでの実行を可能にしている。
専門家ルーティングのほかにも、Qwenチームがスケール時の効率化を狙ったという複数のアーキテクチャ変更が導入されている。Qwen Sparse Attention(QSA)はテキストを個別トークンではなくマイクロブロック単位で処理し、長文脈でのレイテンシを削減。Gated Residualはデータ依存の読み書きゲートで、より幅広い残差ストリームを流れる情報を制御する。巨大なn-gram埋め込みテーブル――510億パラメータ分に相当し、短い単語列で索引付けされる――が、標準的な埋め込みより少ない計算量でパラメータ数を稼ぐ。ネイティブな文脈長は262,144トークンで、100万まで拡張可能だ。
Strataの役割は、これらすべてをゲーム用に作られたマシンに収めることだ。READMEはキッチンのたとえを使う:常に使う専門家はカウンターに置き、残りは食品庫で待機させる。具体的には、GPUが最も頻繁にアクセスされる数千の専門家を保持し、システムRAMがすべての専門家を保持し、プロセッサが残りの専門家を処理する間にGPUが動作し、SSDが巨大なルックアップテーブルを保持する。インストーラは量子化版モデル(重みあたり2〜4ビット)を選択する。フルモデルは12〜24GBのビデオメモリに収まらないためだ。
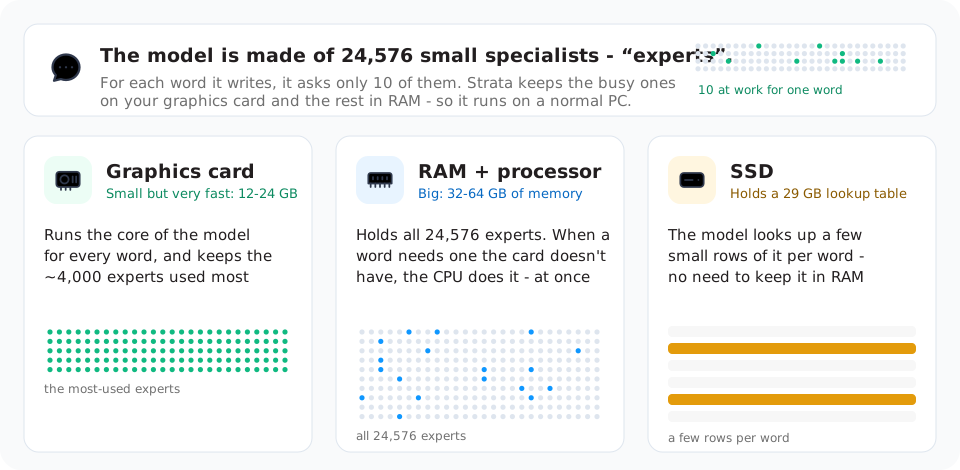
4段落目でキッチンのたとえと、125Bモデルをゲーミングマシンに収めるためのGPU、RAM、SSDへの専門家の具体的な分割について説明している。
返答を高速化する第二の仕掛けがある。小さなヘルパーモデルが次の数単語を予測し、大規模モデルがそれらを一括で検証して正しいものを採用する。READMEはこれを「推測してから検証」と呼び、同じ回答を1.6〜1.8倍速く生成できると説明する。長いプロンプトは最大8,192トークンのチャンク単位で読み込まれ、1,000トークン/秒以上の速度で処理されるため、32,000トークンの文書なら約1分で取り込める。
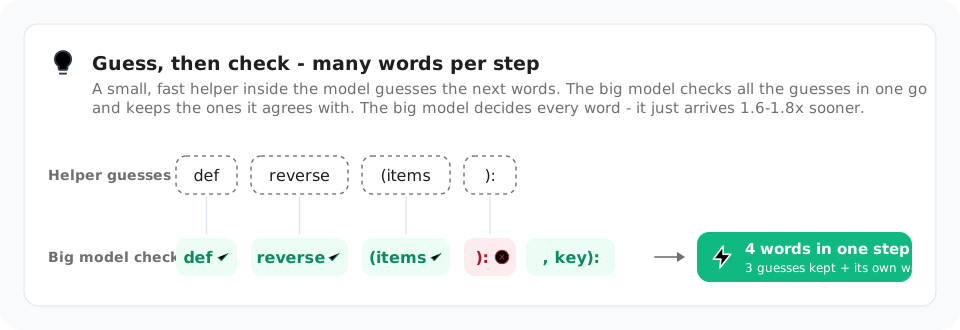
5段落目で、返答を高速化する推測・検証の仕掛けと、READMEが主張する「同じ回答をどれだけ早く生成できるか」について説明している。
公開されているベンチマークは、見出しにあるRTX 4090ではなく、ごく普通のゲーミングPC2台から得られたものだ。NVIDIA RTX 5070(12GB VRAM、64GB RAM、Ryzen 5 7600)では、最も積極的に圧縮したQ2_0量子化で94トークン/秒、より大きなIQ3_S量子化では53トークン/秒で回答を生成。同マシンで32,000トークンのプロンプト読み込みは1,620〜2,650トークン/秒だった。AMD RX 9070 XT(16GB)では、同じ量子化でそれぞれ60と52トークン/秒。READMEはVRAMが多いカードほど高速だと記し、RTX 3090(24GB)なら約100〜140トークン/秒と推定している――見出しが参照するボールパーク数値だ。トークンはおよそ単語の4分の3に相当するため、100トークン/秒は十分に読書速度を超える。
トレードオフは品質だ。READMEは率直に認めている:より小さく高速な量子化ファイルは、サイズが大きいほど少し賢くなる。インストーラはマシンのRAM量に応じて異なる量子化を推奨する。Coderバリアントは専門家を半分に減らし、著者の測定でフルモデルのSWE-bench Verifiedスコアの91%に達し、32GB RAMに収まる――しかしコード以外、特に中国語などCJKテキストでは弱い。コミュニティ製ファインチューンも存在する:回答前の思考時間を短縮したSwift 1.5版、推奨量子化の間に位置するUnslothの約4ビット版群、フルに近い版は64GB PCで7〜8.5トークン/秒しか出ない(SSDからの読み出しが主体のため)。モデルの公開ベンチマークスコア(Hugging Faceページ掲載)はQwenチーム自身によるフル精度での測値であり、非圧縮モデルの参考値であって、特定の量子化コピーの性能を保証するものではない。
実行は簡単だ。インストーラがモデルサイズ、保持する文脈長、画像読み取りの有無を尋ね、約70GBをダウンロードしてエンジンを起動する。ブラウザでlocalhost:8080にアクセスするとチャットインターフェースと、モデルおよびマシンのGPU、CPU、RAM使用率のライブモニタが表示される。OpenAI互換APIを使うアプリはhttp://127.0.0.1:8080/v1を、Anthropic APIを使うアプリはmessagesエンドポイントを指定でき、Claude Codeなどのツールからローカルモデルへリクエストをルーティング可能。さらにOpenAIの新しいインターフェース向けにResponses APIも公開されている。
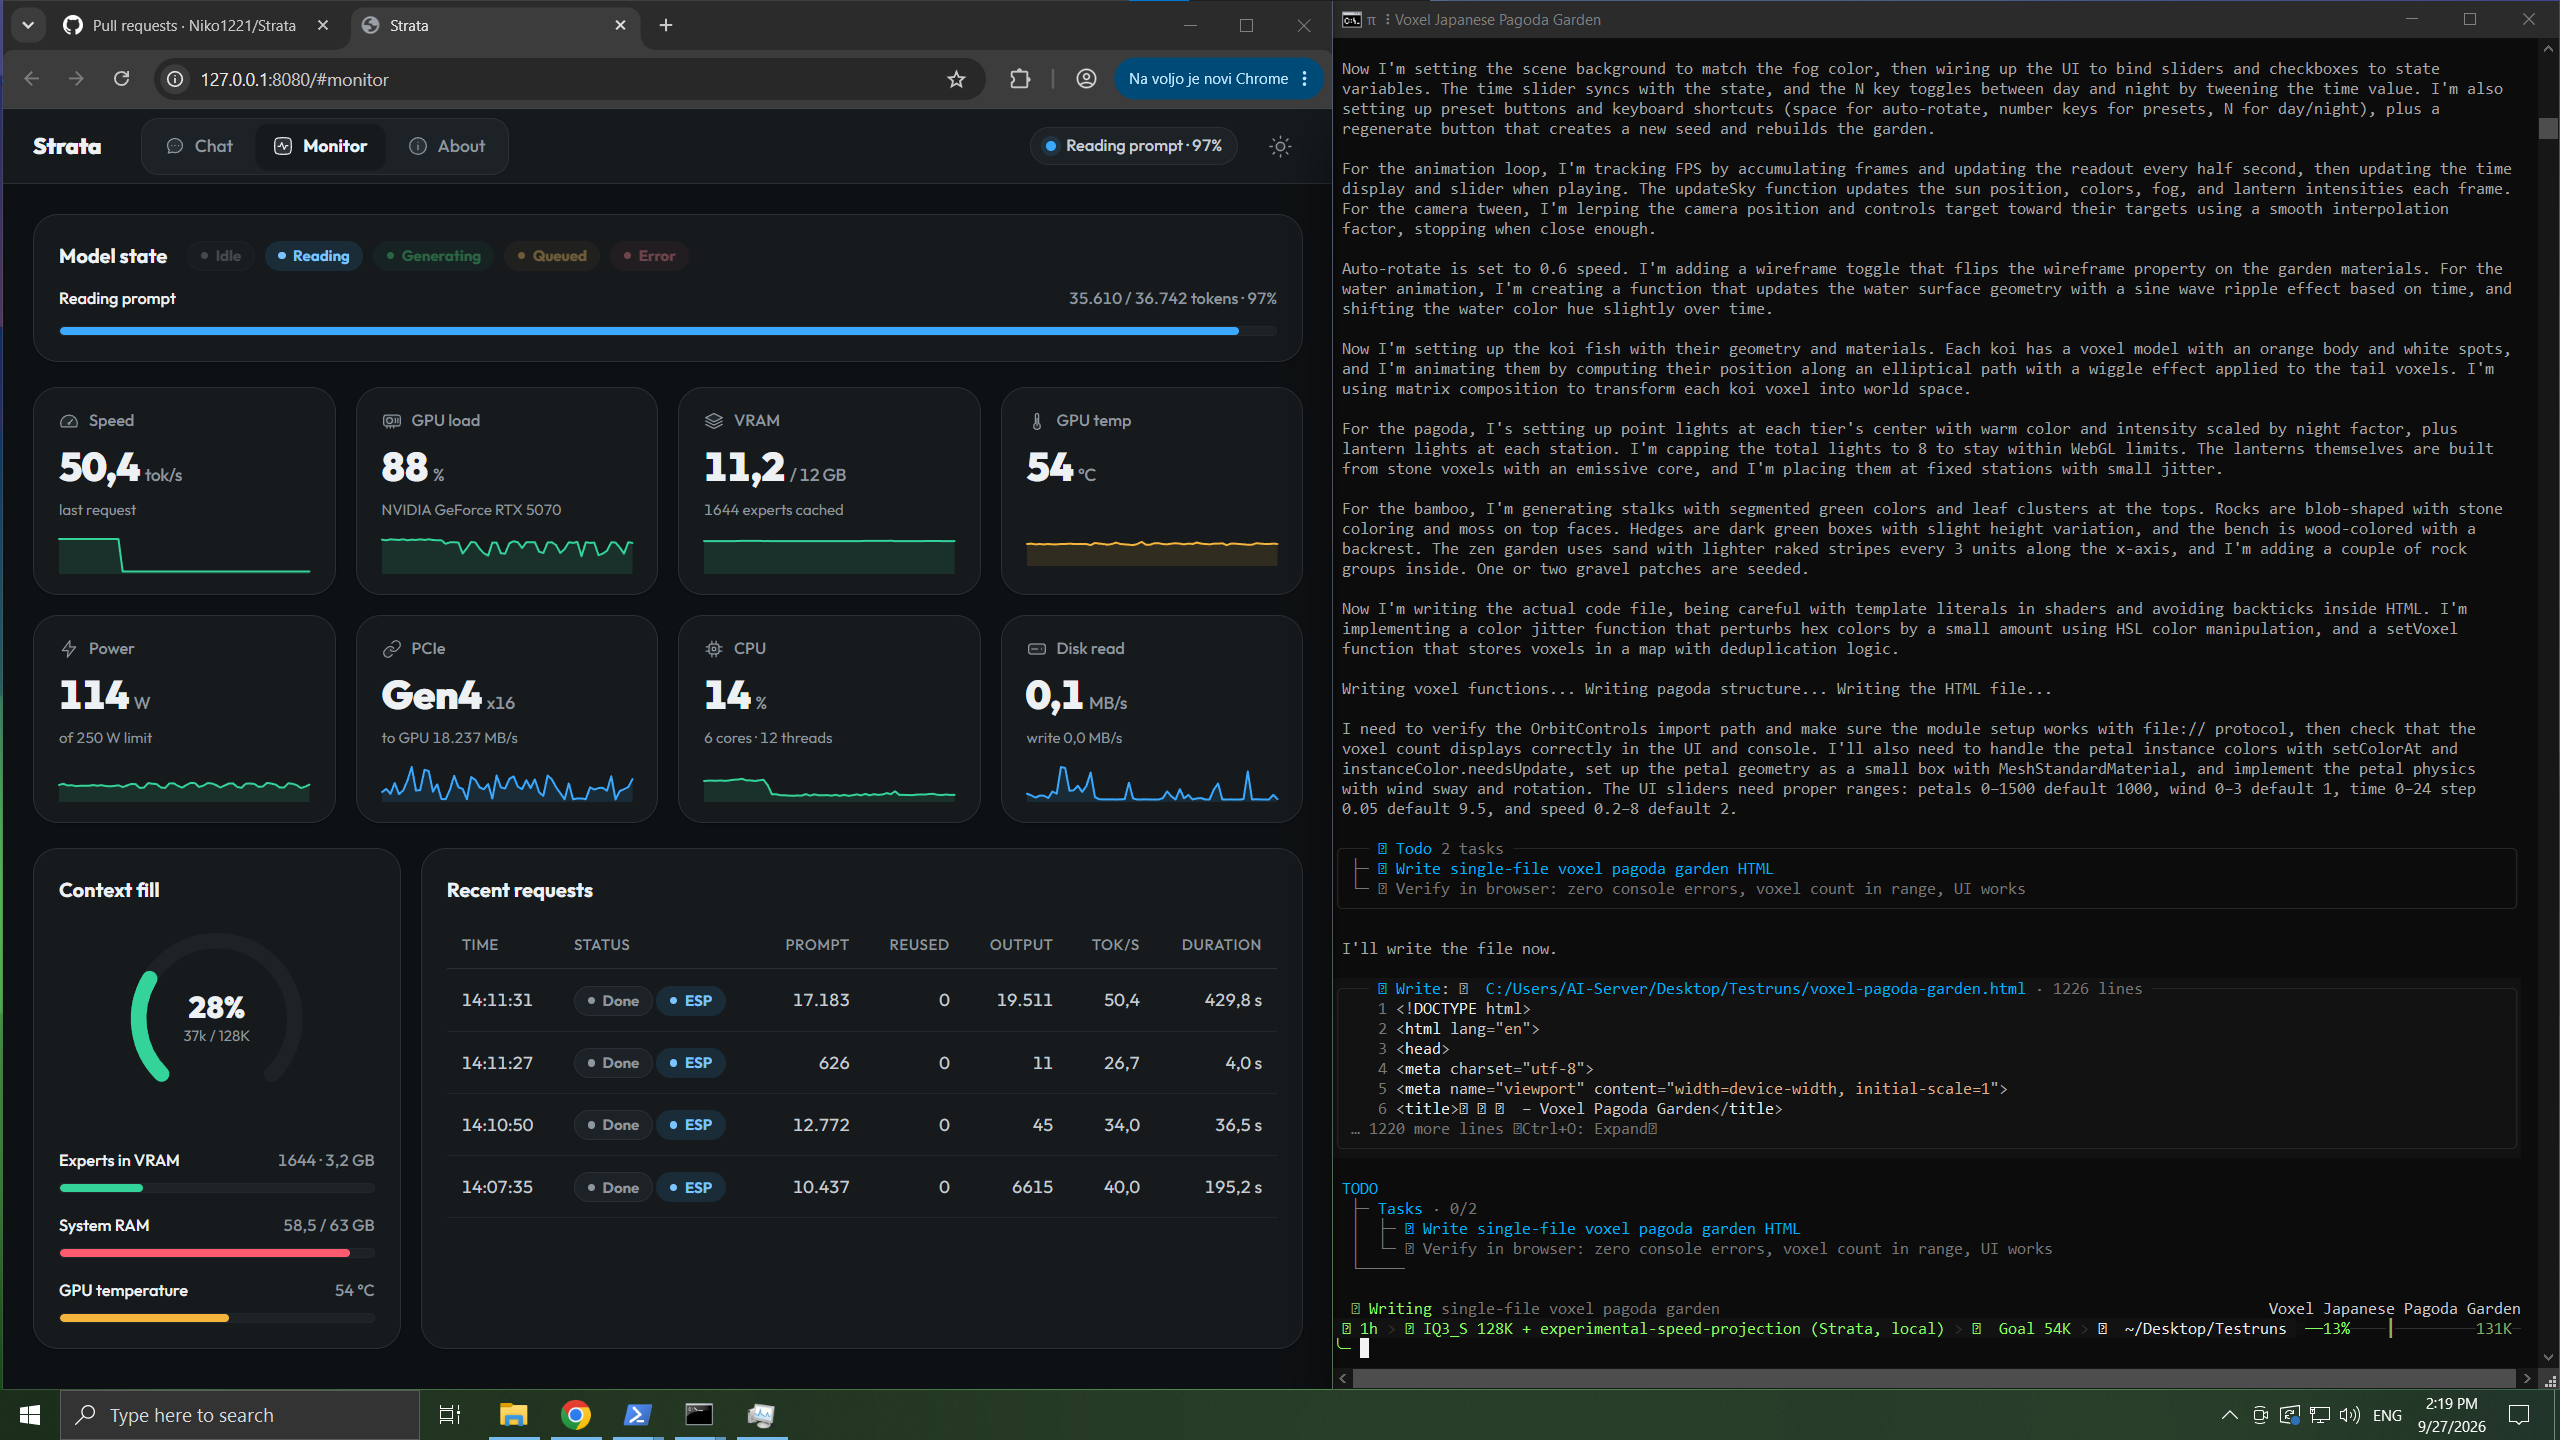
8段落目で、localhost:8080のブラウザチャットインターフェースと、モデルおよびマシンのGPU、CPU、RAM使用率のライブモニタについて説明している。
魅力の一部は、かつてサーバーファームが必要だった125Bモデルが今やデスクトップで動き、データがリモートプロバイダに送られない点だ。コーディング、執筆、エージェント的タスクに強力なローカルモデルを求め、コードや文書をクラウドサービスに送ることを懸念する開発者やホビイストにとって、これは意義深い変化である。
注意点も重要だ。Strataは実験的で、READMEは初回起動時にモデルがRAMにロードされる間、1〜3分間マシンがフリーズする可能性があると警告している(これは正常)。エンジンはデフォルトで一度に1リクエストのみ処理するが、複数の同時ストリームにも設定変更可能。画像入力はほとんどの環境で動作するが、現状ではAMDカードはLinuxでのみ画像読み取りが可能でWindowsでは不可。速度数値は特定のエンジンバージョンと特定ハードウェアでのものだ――公開テーブルの大半はエンジン0.1.26使用、最速のQ2_0行のみ0.1.36使用――ため、実測値はカード、量子化サイズ、プロンプトによって変わる。
不確実なのは、より低ビットの量子化が実用上どれだけ耐えうるか、そして見出しの「RTX 4090で約100トークン/秒」が、エンジン自身が同等の24GBカード向けに推定する数値と一致するかだ。RTX 3090の数値は推定であってベンチマークではなく、公開テーブルも異なるカードから得られたものだ。正確な構成での独立したテストが必要だろう。