2026年9月、Pythonベースのコンテンツ管理システムであるWagtail CMSのチームは、「オープンモデルのみ:バック・トゥ・スクール・チャレンジ」と名付けた実験に着手しました。目標は deceptively simple(一見単純)なものでした。それは、効率的なオープンモデルの階層であるGLM 5.3 Flashのみを使用して、9月の1ヶ月間すべてをコーディングすることです。チームの説明によれば、「9月の1ヶ月間をたった一つの効率的なオープンモデルだけで過ごすという挑戦を設定することは、その時点では素晴らしいアイデアのように思えました。」
選択されたモデルは、効率的なオープンソースAIモデルの階層であるGLM 5.3 Flashでした。Wagtailのブログによると、GLM 5.3 Flashは100万のコンテキストウィンドウを備えており、拡張されたコーディングタスクや複雑な推論を可能にします。また、ビジョンサポートも提供されているため、スクリーンショットや視覚的なQA(質問回答)を扱うことができます。このモデルは幅広いプロバイダーで利用可能であり、健全な競争の恩恵を受けています。これらの技術的な強みは、チームが自ら設定した挑戦に非常に適していました。
この1ヶ月間でうまくいったことは何でしょうか?チームは9月の前半をGLM 5.3 Flashのみを使用して過ごすことに成功しました。そのモデルの使用量は予算内に十分に収まり、コストは約68ドル、エネルギー消費は約4 kWh、炭素排出量は365グラムでした。これを比較するための指標として、チームはこのエネルギー消費が電気自動車を約15マイル走らせる、あるいは10ガロンの水を沸騰させることに相当すると述べています。GLM 5.3 Flash自体は、チームが必要としたタスク、すなわちWagtail自体を使用したサイト構築、UIタスク、AIの研究開発、ドキュメント作成、およびコード評価において優れた性能を発揮しました。このモデルの多用途性は、彼らのワークフローにとって「非常に多機能(polyvalent)」なものでした。
しかし、月の後半は計画通りには進みませんでした。約10億トークンが他のモデルに費やされ、総トークン使用量は目標の10億ではなく20億に達しました。エネルギー消費量は予想の10 kWhではなく、約35 kWhに達しました。チームはいくつかの予期せぬ障害を特定しました。
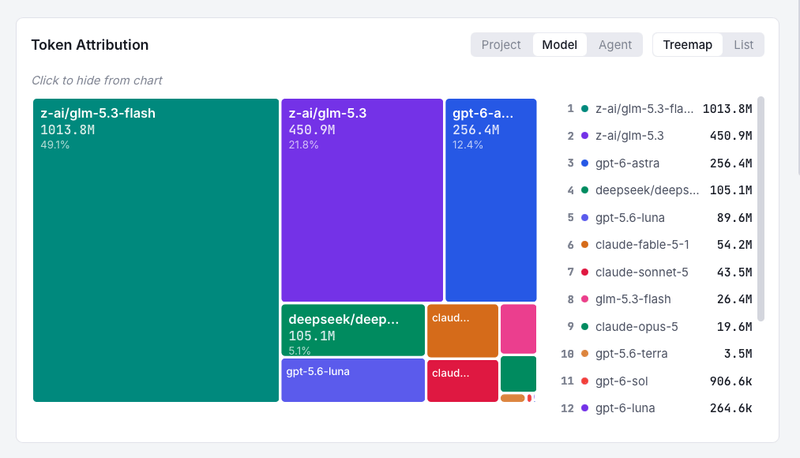
実験の主要な発見の視覚的表現:トークンの50%のみが目標モデルに費やされ、半分が他のモデルに費やされた。
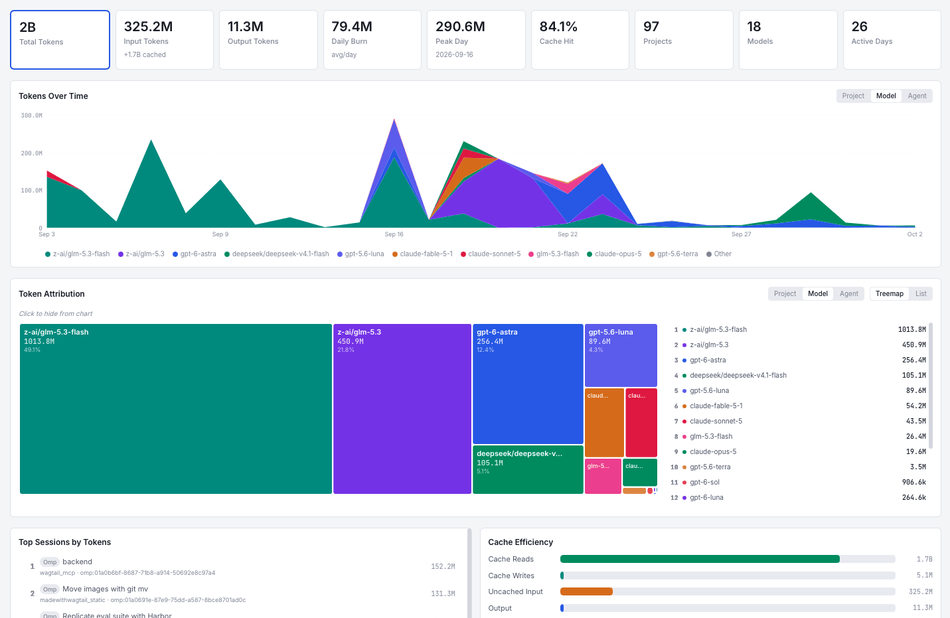
目標の10億を超えた総トークン消費量を示すスクリーンショット。オーバーシュートの規模を例示。
一つの重要な問題は、チームが「バイブ・コーディング(vibe coding)のコスト」と呼ぶものでした。彼らの実験的なWagtail MCPサーバー(バイブ・コーディングによるプロトタイプ)は、プロトタイプの目的には「不適切な」モデルを使用していました。彼らは、ほぼ一晩で4億5000万トークン/150ドル/5 kWhのエネルギー消費を招くモデルを選択してしまったのです。チームはこのことがプロトタイプのミスであったことを認めています。「ほとんどのケースで、それほど多くの努力をせずに、おそらく5倍少ないコストで同様の結果を達成できたはずです。」教訓は、モデルの選択とエージェンティックなパターンに注意することです。彼らはこれに予算を割り当て、より注意を払う必要がありました。予見できたはずのことですが、今はそれを知っています。
もう一つの障害はインフラの可用性でした。チームは推論プロバイダーの比較について広範囲に執筆してきました。彼らの選択はほとんどの場合うまく機能しますが、これらのモデルは非常に人気があり、すべてのGPUを独占している大手ラボと同じ容量を持っているわけではありません。彼らの状況では、欧州のデータセンターで利用可能と確認できるのはオープンモデルのみであったため、GLM 5.3 Flashのパフォーマンス低下は、それが「我々の仕事に関連するモデルのパレート境界(Pareto frontier)において非常に高い位置にある」ためである可能性が高いです。GLM 5.3 Flashの性能が低下した際、チームはDeepSeek V4.1 FlashやQwen 3.8 Flashといった他の類似モデルに切り替える必要がありました。この切り替えは「非常に簡単に行えたものの、それでも予期せぬことでした。」
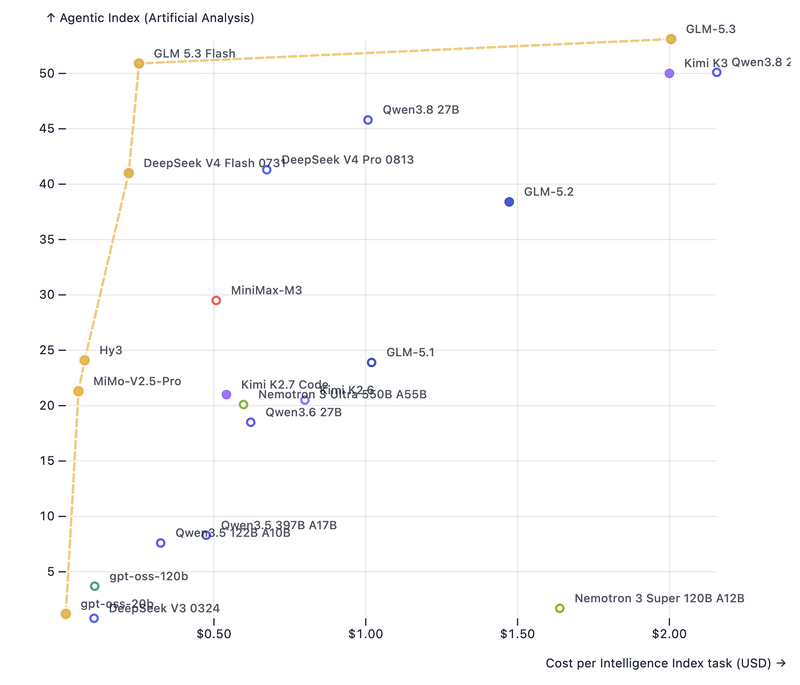
記事で議論されているモデル選択の課題の図解。GLM 5.3 Flashのような高性能モデルがパレート境界に位置している。
日々のエンジニアリングに一つのモデルを使用するだけでなく、チームは幅広いモデルを実験し続け、プロバイダーがリリースするものを把握し続けることが不可欠であると感じました。これは、彼らがWagtailタスクにおけるモデルのパフォーマンスのベンチマークを開始する際に特に重要であり、そこでは幅広いモデルにわたるデータが必要になります。チームはベンチマークのプレビューを共有し、「このような具体的なデータがあれば、人々をより軽量な選択肢へと導くことがずっと簡単になる」と述べています。
チームの教訓と次のステップは明確です。技術的には、この挑戦は失敗でした。目標モデルの使用率は50%にとどまり、20億トークンのうち10億トークンでした。エネルギー消費量は10 kWhではなく約35 kWhでした。しかし、彼らは多くのことを学び、チームはそれを現在の瞬間において極めて重要であると考えています。10月に向けてこれらを振り返ると、成功させるためのポイントは以下の通りです: - 絶え間ないローカルの使用量測定と報告。トークンだけでなく、エネルギー消費や支出、そして理想的にはそれがどのように具体的なポジティブな成果につながるかにも注目する。 - 日々のタスクだけでなく、実験のための予算を確保する。どのプロトタイプを構築する価値があるか、そしてどのように構築するかについて、より計画的な意思決定を行う。 - より良いプロンプトの選択とマルチエージェント技術。オーケストレーター、スカウト、実装者、レビューアーといったエージェントの役割分担。限定された目標。高度な科学ではありませんが、確実に学ぶべきことの一つです。 - より効率的な技術とモデルを追求し続ける。Jevスタイルの意思決定拡散モデル(decision diffusion models)は、効率的に実行できれば非常に有望に見えます。最新のフラグシップモデルも、その点において正しい方向への一歩のように見えます。
日々の開発作業において、チームは1つまたは2つのフラッシュ階層の安価なモデルに集中することは完全に実行可能であると結論付けています。実行可能な目標は、AI推論作業の大部分を、無意味なトークン数ではなく、コストやエネルギー消費で測定されるような、そのような効率的なモデルで行うことでしょう。それが10月の目標です。彼らは他の人にも試してみることを推奨しており、その過程で多くのことを学べるからです。彼らは11月にWagtile Space 2026に出席し、すべてがどのように進展したかを聞く予定です。
この実験は、AI開発哲学における重要な転換を反映しています。チームは、ほとんどのAI推論作業は、無意味なトークン数ではなく、コストやエネルギーで測定される効率的なモデルへと移行すべきであると主張しています。この経験は新しいパラダイムを示唆しています。それは、Claude Opusのような強力なモデルを置き換えることではなく、ルーチンなタスクのための「ワークホース(主力)」として効率的なモデルを確立し、複雑で斬新な課題のためにプレミアムモデルを温存することです。
今後、Wagtailチームはこれらの教訓を10月に実施し、より効率的なAI使用パターンを目指します。彼らは、現在の瞬間が、これらの効率的なモデルが現在置き換えられているフロンティアモデルと同じくらい競争力があり需要が高くなる前に、より良い慣行を確立するための重要な機会であると指摘しています。この実験は、技術的には目標モデルの使用率が50%にとどまった部分的な失敗として終了しましたが、より広いAI開発コミュニティにとって極めて重要な学習体験となりました。
] ,