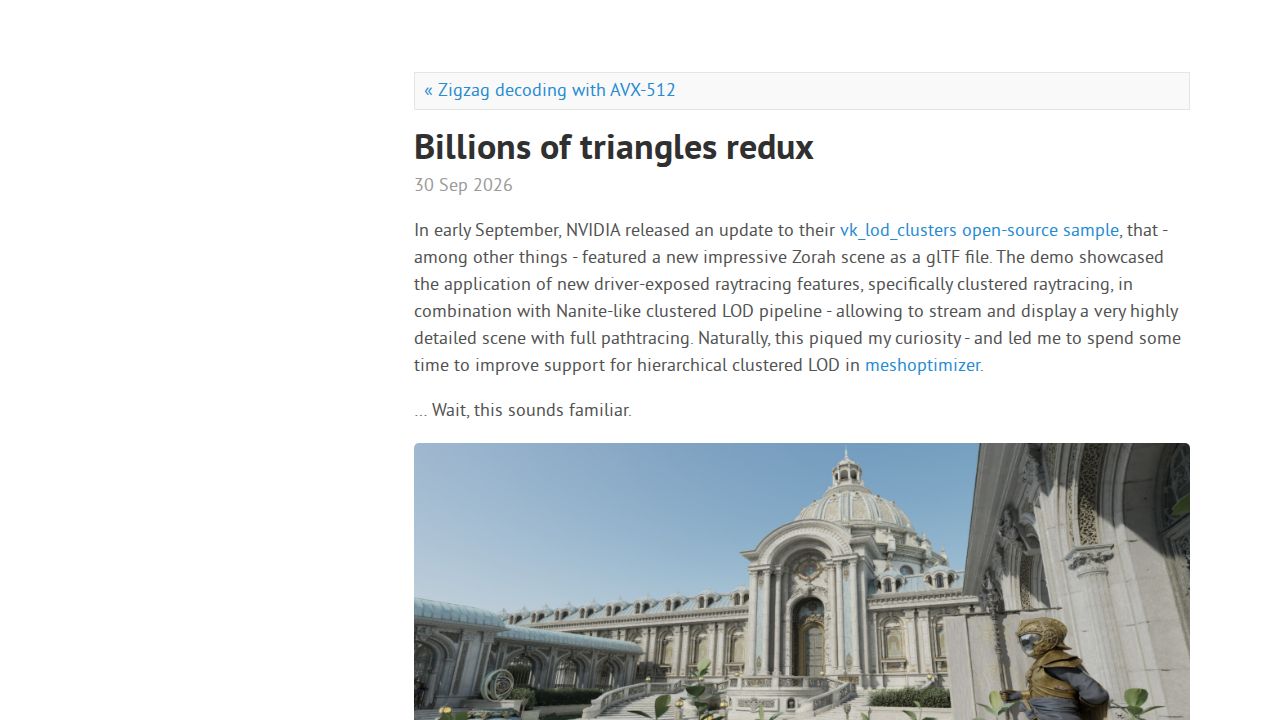
2026年9月初旬、NVIDIAはオープンソースのvk_lod_clustersサンプルの更新版をリリースしました。これは、ドライバーが公開するクラスタ化レイトレーシングと、Naniteのようなクラスタ化レベル・オブ・ディテール(LOD)パイプラインを組み合わせ、極めて詳細なシーンを完全なパストレーシングでストリーミング表示するVulkanデモです。この更新では新しいZorahシーンがglTFファイルとして追加され、meshoptimizerメッシュ処理ライブラリの作者であるArseny Kapoulkineが、「数十億の三角形、再び」というタイトルのフォローアップ記事を発表するきっかけとなりました。この新しい記事は、シーンに関する彼の以前のレポートよりも処理時間に焦点を当てることが少なく、代わりに圧縮とパイプラインの他の側面に焦点を当てています。以前の記事を読んでいなくても理解できます。
新しいZorahシーンは約16億の三角形に拡張され、約70 GBのダウンロードとして提供されます。最も注目すべきはダウンロードサイズではなく、glTFシーンデータ自体です。2026年バージョンでは約32 GB、2025年バージョンでは約36 GBであり、全体的なジオメトリ量はほとんど変わっていません。対照的に、NVIDIAは現在、属性もテクスチャも持たないオリジナル版のシーンをわずか9 GBで提供しており、属性とテクスチャの追加が以前のファイルを36 GB近くに押し上げた主因であったことを裏付けています。
サイズ削減は、glTFシーンにおけるmeshoptimizer圧縮拡張によってもたらされます。EXT_meshopt_compressionは、古い「v0」頂点フォーマットを使用した頂点およびインデックス圧縮を公開し、より新しいKHR_meshopt_compressionは、アップグレードされたv1頂点フォーマットを使用し、2026年初頭に標準化されました。これらの拡張は、一度に1つのメッシュをパッケージングするのではなく、頂点またはインデックスデータを表すバイト配列としてデータを編成するため、ツールがメッシュをどのように分割しバッファリングするかを自由に決定できます。meshoptimizer頂点コーデック自体はロスレスであり、元のバイト列を正確に再現しますが、その下のレイヤーでは、glTFアクセサーが対応している場合の事前量子化データや、わずかな精度を犠牲にして圧縮率を向上させる「フィルタ」によってロスイーにすることができます。Zorahシーンは最終的な配信フォーマットではなく中間ファイルであるため、ロスレスオプションを使用しています。最後の1マイルの配信では、ファイルサイズを最小化するために調整されたロスイー圧縮が使用されます。
Kapoulkine氏は、以下のサイズをシーンについて報告しています。生データ(非圧縮)、v0(ダウンロードファイルにディスク上で格納されているもの)、およびv1(v1フォーマットで再圧縮したもの):
カテゴリ 生データ v0 v1 位置 14.3 GB 9.1 GB (63.5%) 8.9 GB (62.1%) 属性 30.1 GB 21.6 GB (71.8%) 20.5 GB (68.2%) インデックス 18.9 GB 1.9 GB (10.1%) 1.9 GB (10.1%) 合計 63.3 GB 32.6 GB (51.5%) 31.3 GB (49.5%)
インデックスデータは特に高い圧縮率を示します。位置と属性はより控えめな圧縮率です。v1頂点フォーマットへの切り替えにより、さらに数ポイントの改善とより高速なデコードが得られます。
なぜ中間ファイルを圧縮するのか。Kapoulkine氏は2つの理由を挙げます。第一に、シーンをディスクから読み取るコストを削減できることです。頂点またはインデックスデータのデコードは、シングルコアで出力ベースで秒間数ギガバイトの速度で実行され、デコードは総処理時間の1%未満で完了し、完全に並列実行され、ディスク読み取りフットプリントを半分に削減します。第二に、メッシュに最適化されたコンプレッサーは、汎用コンプレッサーよりも小さくなる可能性があります。生データにレベル6のZstandardを適用すると38.0 GB(生データの60.1%)になりますが、v1 meshopt圧縮の上にZstandardを適用すると27.4 GB(生データの43.3%)に達します。これは一見するとパラドックスのような結果です。この設計の意図は明確です。meshoptimizerコーデックは完全なロスレスコンプレッサーを再実装するのではなく、汎用コンプレッサーがしばしば見逃す機能を対象としながら、出力ストリームを高速デコードと更なる事後圧縮の両方に適したものに保ちます。元々の動機は単純に、SSDが不合理なほど高速になってきたことです。ドライブが秒間数ギガバイトでストリーミングできる場合、遅いがコンパクトな圧縮はまったく割に合わない可能性があり、階層的なアプローチにより、パブリッシャーはメッシュレイヤーに触れることなく、基盤となるコーデック(LZMA、Zstandardなど)を選択できます。
処理側では、パイプラインは前回の記事とほぼ同じです。入力メッシュをクラスタに分割し、クラスタをグループに分割し、境界を保持しながら各グループを簡略化し、新しいグループをさらに多くのクラスタに分割し、これを繰り返します。ランタイム側では、clusterlod.hがclodBuildHierarchyを提供するようになり、クラスタDAG上にBVHを構築して、元のNaniteプレゼンテーションで説明されているように、適切な忠実度レベルのクラスタを迅速に選択できるようになりました。シーンが属性を持つようになったため、meshopt_simplifyWithAttributesによる属性対応簡略化が使用されます。各属性には、表面の外観をどれだけ変化させるかに応じてスカラー重みが与えられ、簡略化の誤差メトリックが完全な視覚的結果を反映するようになります。
clusterlod.hへの最近の変更により、空間的一貫性と簡略化の堅牢性が向上しました。partition_sortオプションは、パーティションをモートン順で並べ替えることで、DAGを空間的により一貫性のあるものにし、ストリーミングの局所性を向上させます。meshopt_buildMeshletsSpatialは、戦略的に配置されたプリフェッチにより高速化されました。meshopt_partitionClustersも最近のリリースで改善されました。meshopt_SimplifyPermissiveフラグで有効になる許容モードは洗練され、安定としてマークされました。これにより、ほとんどのトポロジ的制約が緩和され、シームが豊富なメッシュで簡略化が停止する問題(高詳細なソースメッシュを単一クラスタまで簡略化する階層的LODスキームにとっての問題)が解決され、属性誤差をクランプして過度に悲観的なLOD選択を防止できるようになりました。許容モードを使用する場合、不連続性のある属性は属性ベースの重み付けのために簡略化器に渡され、LOD選択は固定の三角形予算ではなく、計算された出力誤差に依存すべきです。Zorahは選択的な不連続性保護を使用しません。Zorahシーンでは、低品質の「スロッピー」フォールバックが、簡略化されたグループの約0.01%で採用されるようになりましたが、作者はこれを無害と見なしています。
この記事には、GeForce RTX 5070(12 GB VRAM)でのテスト結果が記載されており、最後の1マイル配信シナリオ向けのロスイー圧縮チューニングを扱った付録が含まれています。