AIエージェントは今日しばしば、『メモリ』プラグインに依存し、セッション間で永続的なコンテキストを提供しようとします。しかし、これらのシステムは根本的に欠陥があります。エージェントがプロジェクトを理解するのを助ける代わりに、これらのメモリプラグインは宝くじとなり、エージェントは関連すると思われる過去の会話のスニペットを検索して、それがトップに浮上するのを期待します。 問題はこれらのメモリシステムのアーキテクチャにあります。ほとんどの商用メモリプラグインは同じように動作します:セッションのトランスクリプトを分析し、メモリスニペットを生成し、ベクターデータベース(RAG)に保存し、プロンプトごとに最も類似度の高い上位5つのスニペットを取得してエージェントのコンテキストに注入します。このアプローチはいくつかの重大な制限を抱えています。 第一に、メモリは埋め込み空間での類似性のみに基づいて表面化され、スニペットが正しいか、最新か、完全かを判断するメカニズムがありません。 第二に、スニペットのみを保存すると、動機、学んだ教訓、環境要因、決定の理由といった重要なコンテキストが失われます。 第三に、これらのシステムは過去を真実として扱い、コードベースが日々進化することを無視します。したがって、認証などの機能に関するスニペットはすぐに古くなります。 第四に、エージェントにメモリ上の検索ツールが与えられても、自分が何を知らないかわからないため、何を検索すべきかわかりません。 最後に、メモリストアは監査不能になります—SQLiteに数千の埋め込みがあり、どのメモリが存在するか、どれが古いか、あるいはエージェントの行動に不適切に影響を与えているものがあるかを確認する方法がありません。 核心的な洞察は、エージェントはより良い回復メカニズムではなく、ドキュメントが必要だということです。著者が観察しているように、『3年前のチームミーティングをもう一度見て、機能の制約条件を思い出すことはありません。人々は書き留め、その記録を使います。』 この気づきがドキュメントベースのメモリシステムの開発につながりました。会話の一時的なスニペットをキャプチャする代わりに、これらのシステムはエージェントにマークダウンファイルの構造化されたワークスペースを提供し、そこでは仕様、決定、調査結果、インデックス、ガイドラインなどの重要な知識を永続化できます。エージェントループは『prompt → build → forget』から『prompt → consult → build → update』に変換されます—作業開始前に、エージェントは自身のブレインから関連するドキュメントを参照し、作業完了後に、古くなった情報を修正し、必要に応じて新しいドキュメントを追加することでブレインを更新します。 このアプローチの実装の一つがOperator Memoryです。これはエージェントにマークダウンベースのブレインを提供し、以下の3つのパーティションに整理されます:プライベートプロジェクト知識(.operator/)、リポジトリと共有されるプロジェクト知識(.operator-shared/)、およびプロジェクト間で共有される個人ルール(~/.operator/user/)。このシステムは、仕様と決定の自動ドキュメント化、読み取り可能なマークダウンファイルとしての透明なメモリ、Gitバージョン管理を通じた知識の共有、そしてバックグラウンドエージェント、埋め込み、ベクターデータベースを必要としないゼロインフラストラクチャ要件を特徴とします。 同様の原則は、代替システムであるEncephalonにも見られます。Encephalonは耐久性のあるエージェント知識をSQLiteでインデックス付けされたGitマージ可能なJSONレコードとして保存します。両方のアプローチは、エージェントのメモリを不透明な回復メカニズムではなく、読み取り、更新、コミット、共有が可能なドキュメントとして扱うという重要な特徴を共有しています。 この変化は、エージェントの状態についての考え方における根本的な変化を表しています:脆く文脈のないスニペットから、プロジェクトやチームとともに成長する保守可能で監査可能なドキュメントへと移行することを意味します。
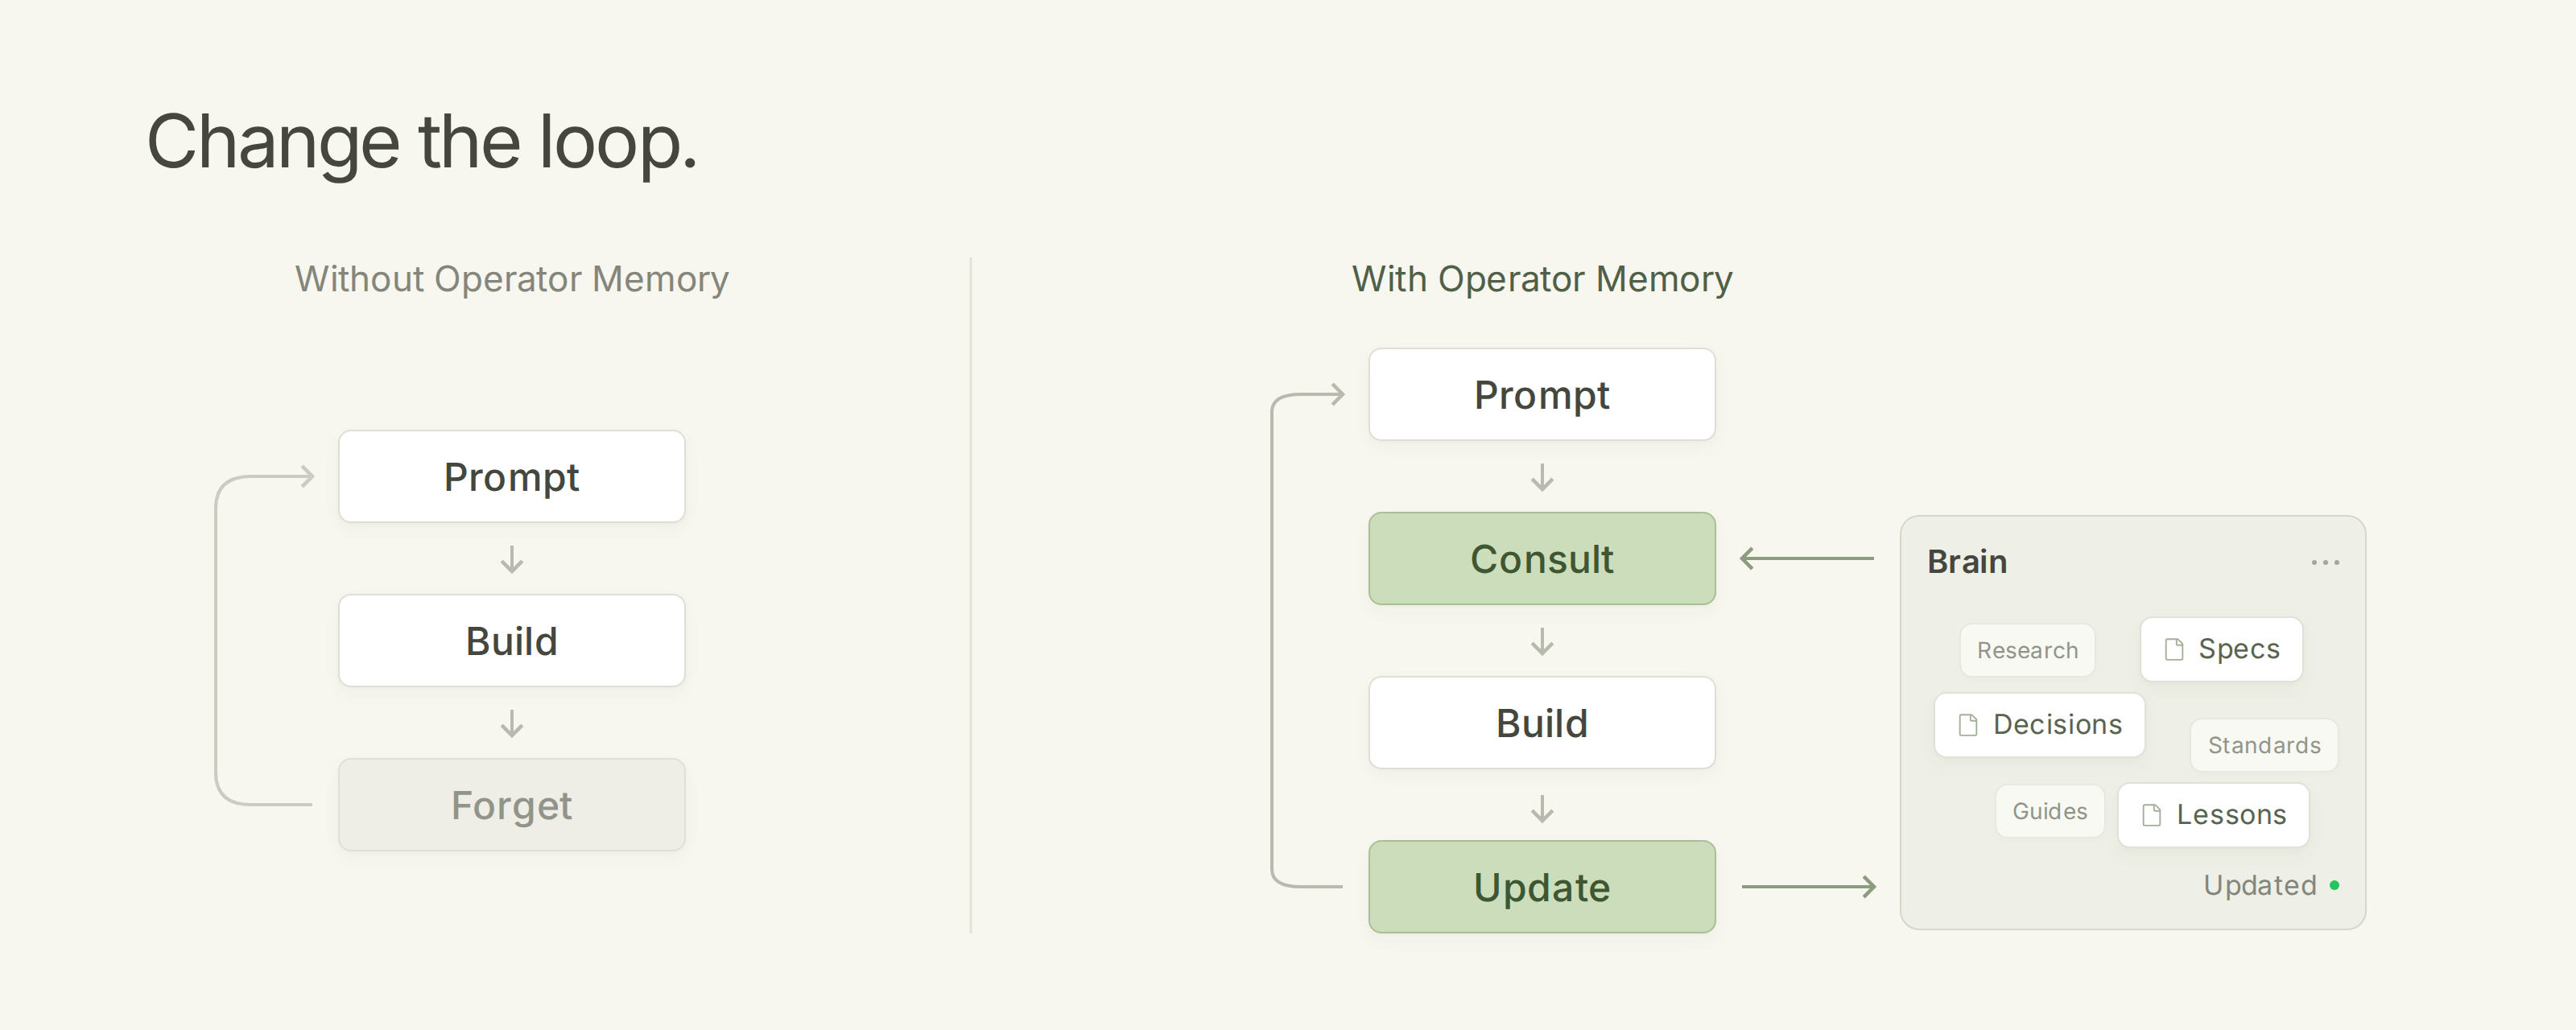
The image supports the article’s core argument that agents should consult documentation (the brain) before building and update it after work, rather than relying on unreliable memory snippets.