TypeSafeのJevのような決定モデルは、従来の分類器の構造化された型安全な出力と、大規模言語モデルのゼロショットの柔軟性を組み合わせた中間的なアプローチとしてAIセーフティガードレールに導入されました。テキストを生成する代わりに固定された決定(例えば確率)を返すことで、Jevは従来のテキスト分類器に必要なタスク固有のトレーニングデータを回避しながら、より高速で低コストな推論を提供すると主張しています。
Red HatのAI Safetyチームが実行したベンチマークテストでは、プロンプトインジェクションおよびコンテンツセーフティガードレールのレイテンシと精度が測定されました。プロンプトインジェクション検出では、Jevは86.35%の精度で中央値レイテンシ348.1msを達成し、従来のdeberta‑v3‑base‑prompt‑injection‑v2分類器は89.01%の精度で54.1ms、Qwen3.6‑35B LLM‑as‑a‑judgeモデルは89.31%の精度で312.5msでした。毒性/不適切語安全テストでは、Jevは86.20%の精度で360.4msのレイテンシを記録し、従来のgranite‑guardian‑hap‑125m分類器は80.27%の精度で33.2ms、Qwen3.6‑35Bは85.47%の精度で307.6msでした。Shieldstral‑1.0やNemotron‑3.5バリアントなどの他のLLM‑as‑a‑judgeオプションと比較しても、類似のレイテンシギャップが観察されました。
この画像は、記事で言及されている決定モデルと従来の分類器のベンチマークテストを実施した組織を表すRed Hat AIロゴを表示しています。
これらの結果は、Jevが約束した速度の優位性を提供していないことを示しています。そのレイテンシは従来の分類器の約6倍であり、主要なLLM‑as‑a‑judgeモデルよりも10‑20%高いです。Jevの精度は依然として競争力があり、ゼロショット機能はトレーニングデータがない新しいガードレールシナリオで役立つ可能性がありますが、追加の意思決定遅延は、ミリ秒レベルの応答時間が期待される高スループットAIアプリケーションではスキーマセーフティの利益を上回る可能性があります。したがって、導入者は優れた効率性を前提とするのではなく、特定のレイテンシ要件に対してJevを評価する必要があります。
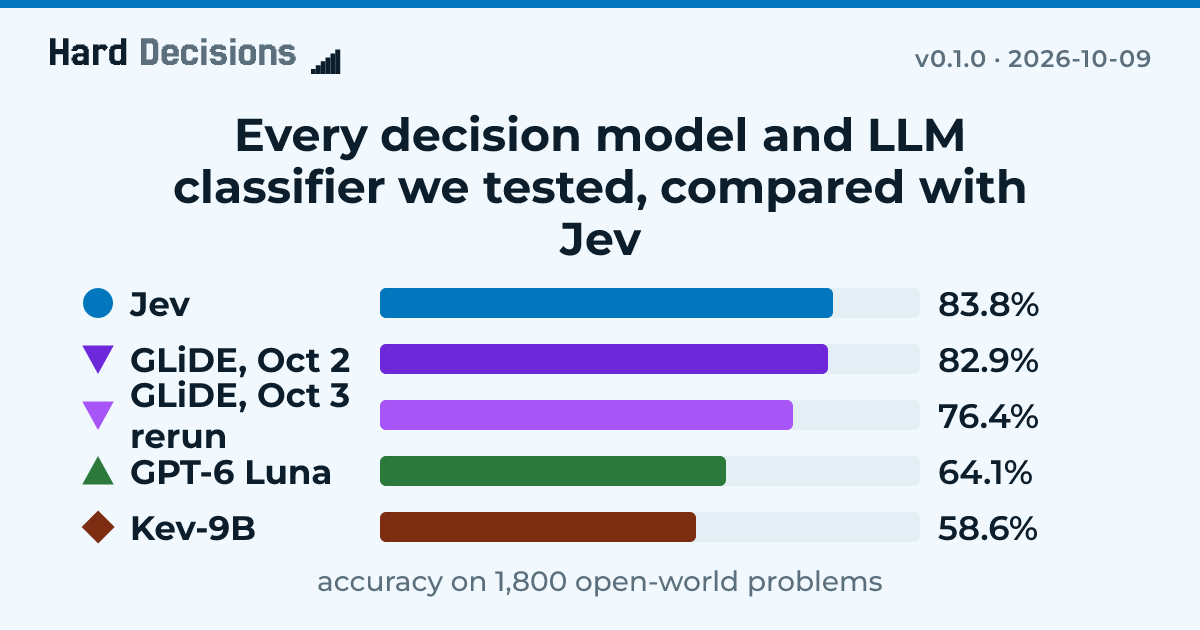
このグラフは、Jevが83.8%の精度を達成し、GLiDEより低く、GPT-6 LunaとKev-9Bより高いことを示しており、記事で議論された精度とレイテンシのトレードオフを示しています。