Tokio上で良好に動作する非同期アプリケーションを書くことは、公平性とバッチ処理、競合と分離の間のバランスを取ることです。「高速なTokioアプリケーションのための原則」という記事で、Russell Cohenは最も一般的な落とし穴と最適化のための戦略を特定しています。
**問題が存在するかどうかを判断する** 最適化の前に、パフォーマンスの問題がユーザー向けメトリクスに影響しているかを確認してください。著者が観察しているように、ほぼすべての実際のTokioアプリケーションでは、Alice Ryhlがブロッキングに関する記事で推奨している10〜100マイクロ秒よりも、poll間隔(`.await`ポイント間の時間)がはるかに長くなっています。しかし、長いpollは無害な場合があります。アプリケーションは完全に無害な長いpollを持つことがあり、それを修正してもユーザー向けメトリクスは測定可能なほど改善しません。最も有用なTokioメトリクスはスケジュールレイテンシのヒストグラムで、タスクが準備完了になってからTokioが実際にfutureをpollするまでの時間を測定します。
**レイテンシのために分割し、スループットのためにバッチ処理する** 多数のリクエストにわたる低レイテンシには公平性が必要です。素朴なパイプライン実装では、あるクライアントのパイプライン全体が別のクライアントの後ろで待つことになり、レイテンシが劇的に増加します。各リクエスト後に明示的にyieldすると、レイテンシを約10倍削減できます。連続する即座にreadyなreadの後にyieldすると、スループットをあまり犠牲にせずに公平性が改善されます。
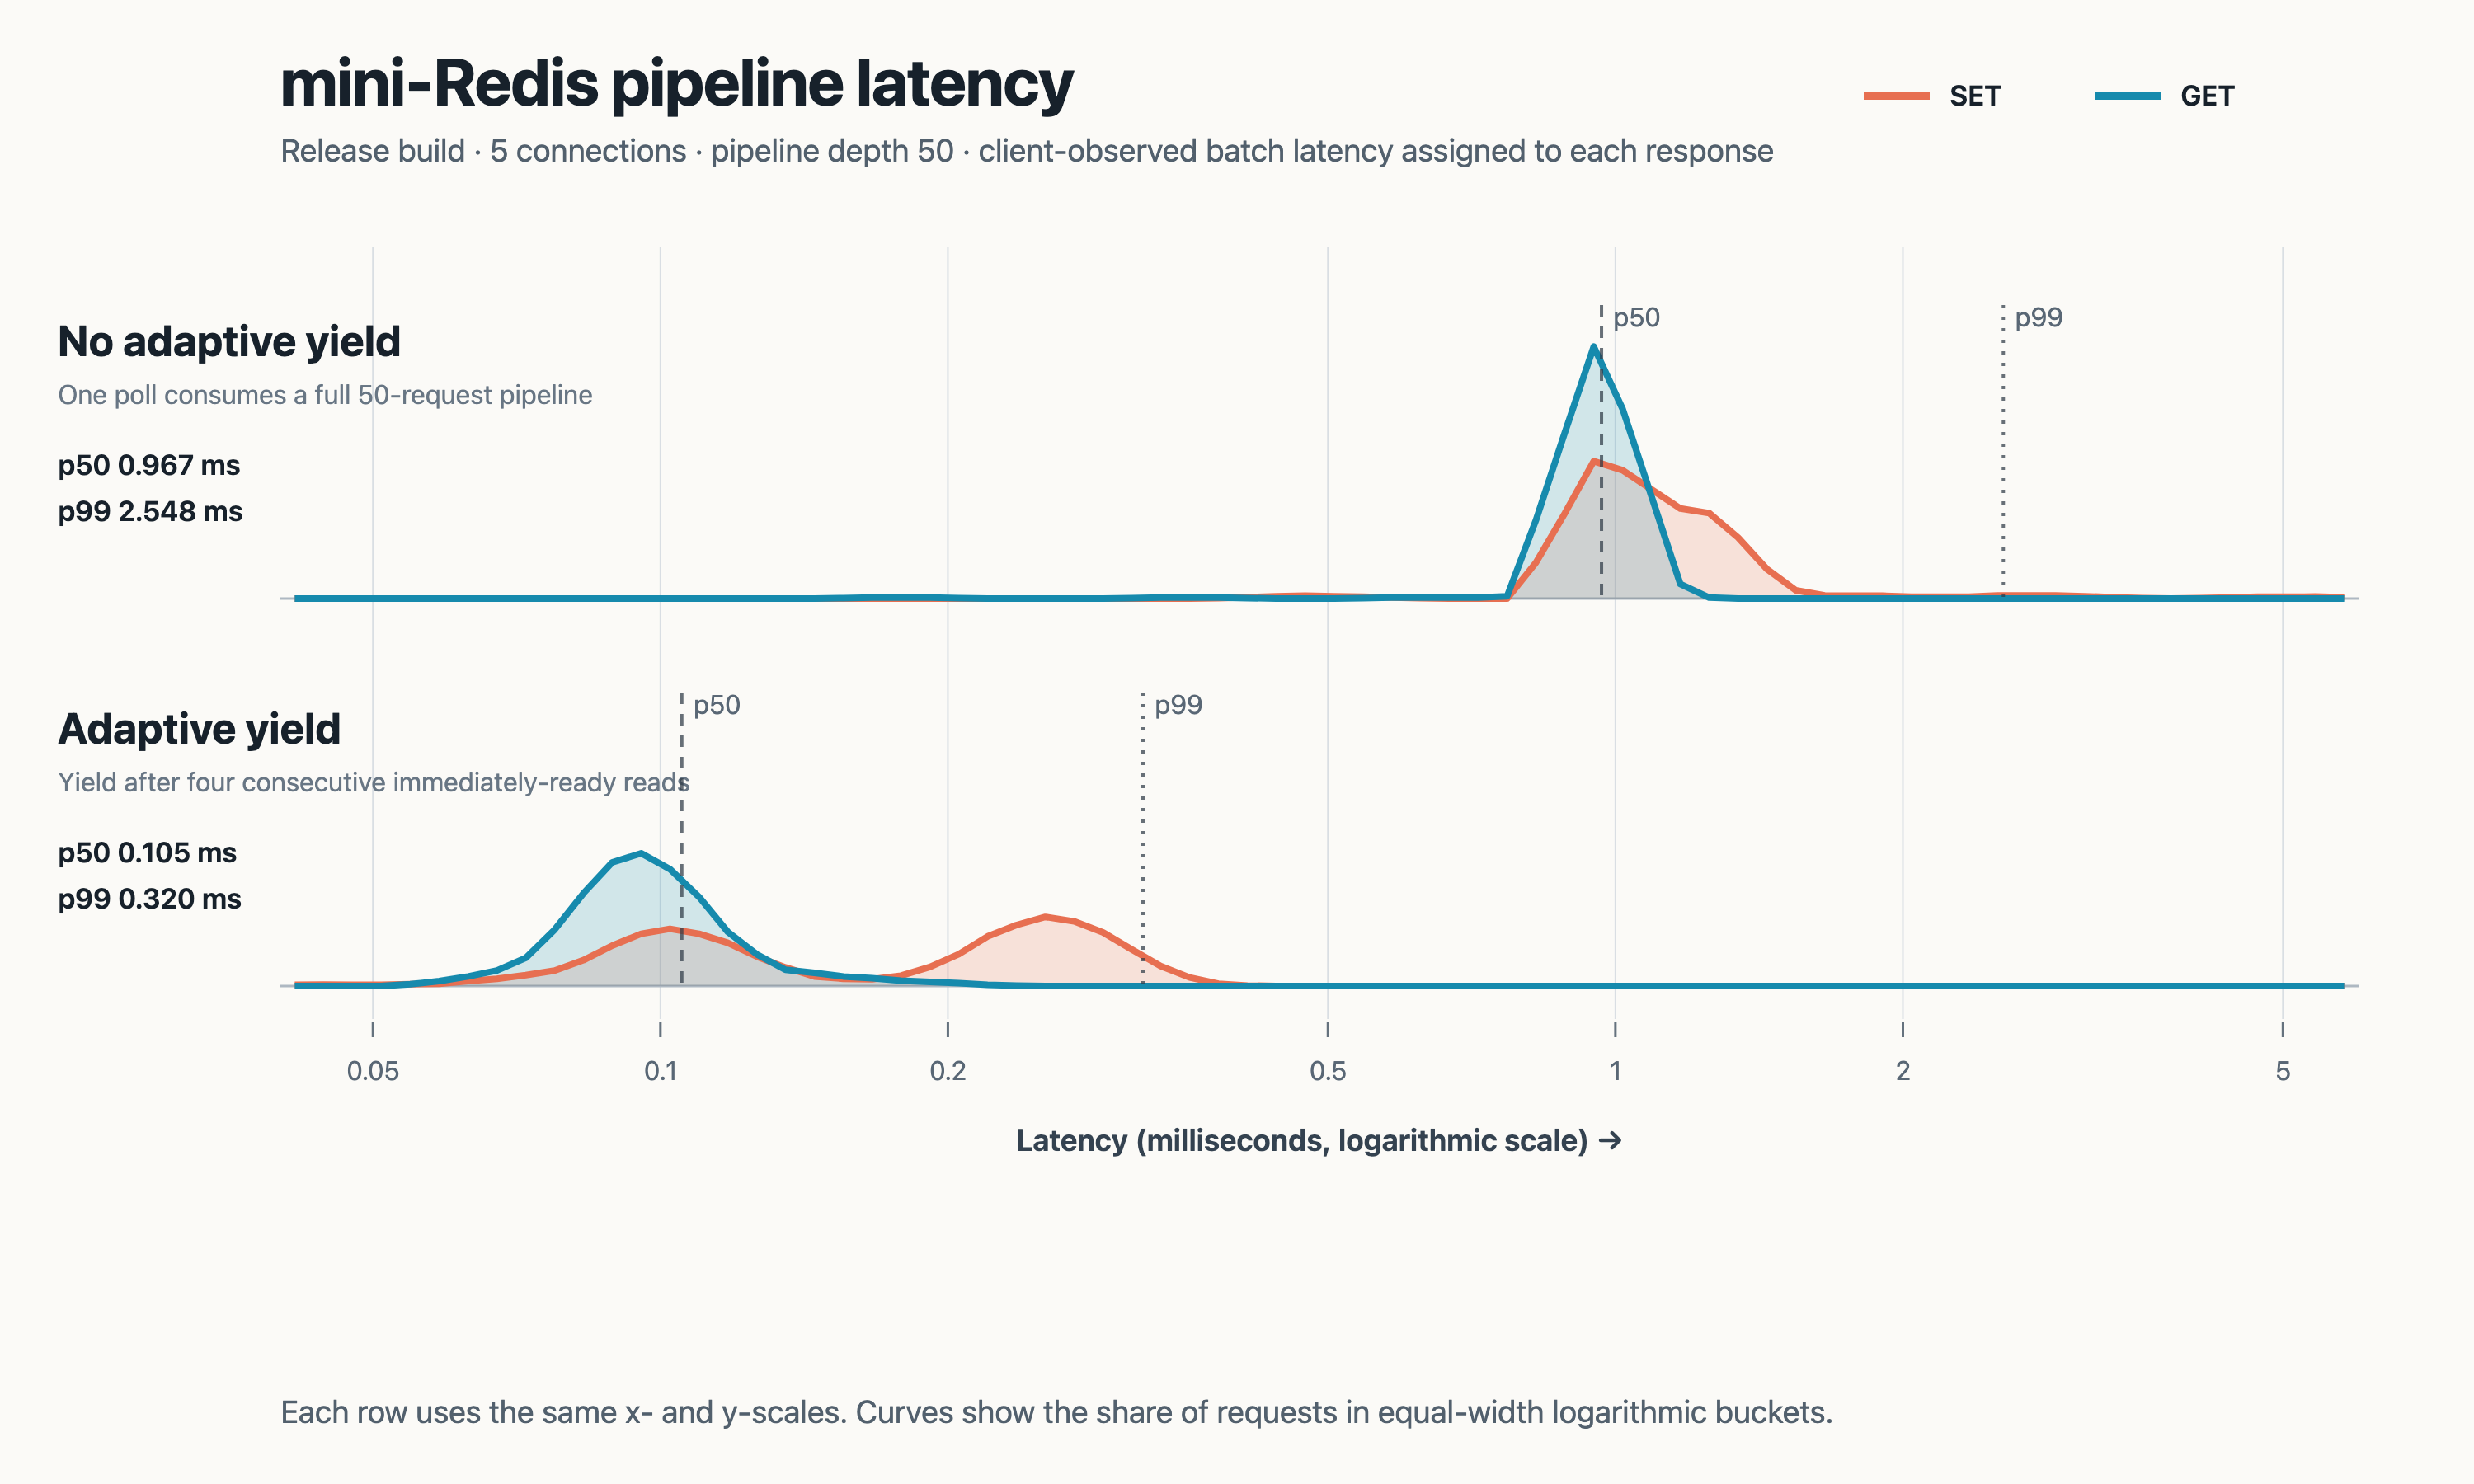
記事では、レイテンシのために作業を分割し、スループットのためにバッチ処理することを論じており、各リクエスト後にyieldするとスループットをほとんど犠牲にせずにレイテンシを大幅に削減できることを、これらのMini-Redisレイテンシ測定が示しています。
スループットのためには、ランタイムイベントごとに有用な作業をバッチ処理する方が効率的です。最良の例は`tokio::fs`です。`io_uring`がない場合、Tokioは各ファイルシステム操作を共有ブロッキングプールで実行し、各`spawn_blocking`呼び出しにはオーバーヘッドが伴います。一連のファイルシステム操作やブロッキング操作を実行する場合、それらを最大の合理的な単位にバッチ処理してください。場合によっては、専用のOSスレッドの方が適しています。
**グローバルリソースに注意する** Tokioランタイムには1つのグローバルブロッキングプールとグローバルタスクキューがあります。十分に高いレートになると、ブロッキングキューへの作業の投入がボトルネックになり、`spawn_blocking`がフレームグラフに現れることがあります。グローバルキューは一般にほぼ空の状態を保つべきです。キューが常に深い場合、`spawn_blocking`のようなランタイム全体の操作がフレームグラフで目立つようになります。
**ミューテックスには極めて慎重に扱う** ワーカーが競合したミューテックスでブロックすると、ランタイム全体が停止する可能性があります。ミューテックスや読み書きロックの裏にあるメトリクスレジストリは特に脆弱です。フラッシュがロックを保持したまま高コストな作業を行うと、すべてのTokioワーカーが最終的に同じロックでブロックするタスクをスケジュールする可能性があり、work stealingが不可能になります。クリティカルセクションを極めて短く保ってください。たとえば単一のハッシュマップ更新のみです。`RWLock`は読み取りパスでもアトミックな競合を生むため、ほとんど適切なプリミティブではありません。フラッシュ、I/Oの実行、別のfutureのawait中にロックを保持しないでください。よくあるトリックは、ロックしてからデータをクローンすることです。古い読み取りが許容できるなら、これによりミューテックス保持時間を制限できます。
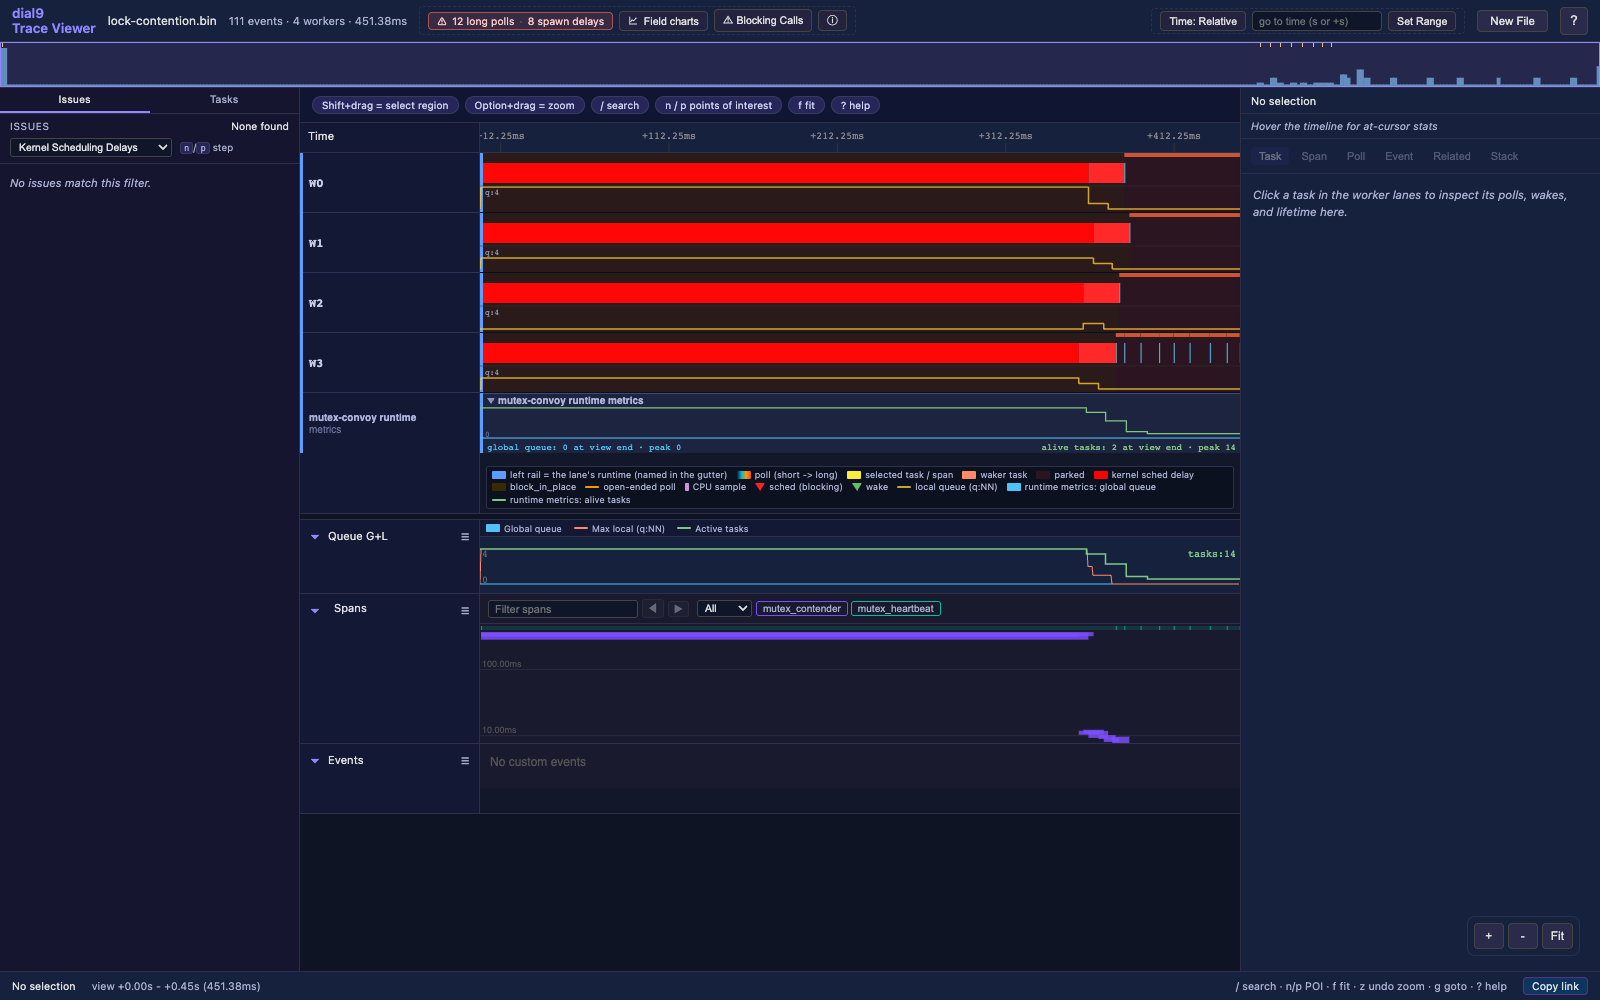
記事では、ワーカーが競合したミューテックスでブロックするとランタイム全体が停止する可能性があると警告しており、ミューテックス競合がカーネルスケジューリング遅延とワーカー活動の減少を引き起こすトレースを示しています。
`tokio::sync::Mutex`はある問題を別の問題と引き換えにします。ロックコストが高く、`FutureLock`のような微妙な問題を引き起こしやすく、クリティカルセクションが数ミリ秒続く場合にのみ本当に適切です。代わりにチャネルの使用を検討してください。1つのタスクが共有データを所有し、チャネルメッセージで変更を表現します。
**並行性を制限する——通常は** Tokioは、システムの他の部分が処理できるよりもはるかに多くのタスクを喜んでスポーンします。数千の同時接続を誤って開いてしまうことはよくあります。答えは地味です:並行性を制限してください。`Semaphore`で十分なことが多いです。洗練された適応アルゴリズムが適切な場合もありますが、複雑さが増します。
**Tokioワーカーを他のスレッドから分離する** オペレーティングシステムが高負荷の場合、Tokioがワーカーを起床させようとしてからカーネルが実際にスケジュールするまでに10〜20ミリ秒(またはそれ以上)かかることがあります。一桁ミリ秒のP99レイテンシではこれは大惨事です。`cgroups`や関連APIを使ってTokioワーカーを専用CPUコアにピン留めするのが最も基本的な解決策です。同じ問題は、バックグラウンドスレッド(例:`tracing_appender`)がCPUをyieldせずに100ミリ秒以上の作業を行う場合にも起こります。非クリティカルなバックグラウンド作業を独自のコアに移し、Tokioワーカーを他のコアに再配置すると、通常レイテンシが改善します。
**あなたがよりよく知っているときのためのトリック** 理想的な非同期アプリケーションでは、すべての作業が頻繁なyieldを伴う小さなバーストで起こります。現実世界は常にそううまくいくわけではなく、小さなバーストが必ずしもソフトウェアを実行する最速の方法ではありません。軽負荷では、1つのワーカーが通常より長く占有されているとき、Tokioのwork stealingが補償できますが、ランタイムやOSが高負荷のときはこれが崩壊します。両方の場合、stealingに時間がかかり、I/Oの駆動などのコアメンテナンスが十分な頻度で起こらなくなり、低レイテンシを維持できなくなります。
エグゼキュータをブロックすることは軽負荷では許容できますが、このアドバイスは`tokio::join!`や`tokio::select!`を使用している場合(タスク内並行性を利用する)には適用されません。単一のタスク内では、ブロックは他のいかなる進行も妨げ、予期せぬタイムアウトとして現れることがあります。
最強の分離は、作業を別々のランタイムに割り当て、それらのランタイムを専用コアにピン留めすることから得られます。多くのネットワークサービスにはレイテンシに敏感な作業と低優先度のバックグラウンド作業の両方があります。それらを別々のランタイムに配置するとスケジューリングの境界が生まれます。TokioConfでは、ほとんどのスピーカーが最終的に少なくとも2つのランタイムを持つ解決策に移行しました。
**制御を保持するためにスピンする** 制御を保持するためにスピンするのは、マイクロ秒単位で測定されるレイテンシを追求する非常に高度な戦術です。一般的には推奨されません。