2026 年 9 月中旬,當 TypeSafe AI 宣布推出 Jev 時,一種新型語言模型進入了公眾視野。Jev 是該公司所謂的「System One」模型系列的首次發佈。Jev 不進行聊天、不編寫代碼,也不生成開放式文本。相反,它接收非結構化輸入——如文件、消息、程序狀態——並返回類型化的、概率性的決策:分類、評分、路由選擇、提取。其開發者將其定位為「分類領域的 ChatGPT 時刻」:一個單一的通用模型,無需長期以來標準做法中的每項任務微調,即可廉價地處理多樣化的分類任務。
此次發佈伴隨著 Sebastian Raschka 的技術回顧文章,該文章梳理了文本分類的歷史——從詞袋模型和樸素貝葉斯到循環神經網絡和卷積神經網絡,再到現代 Transformer——旨在界定 Jev 改變了什麼,以及它沒有改變什麼。
## 從詞袋模型到校準決策
Raschka 的文章從詞袋模型時代開始,當時文本被簡化為固定大小的詞頻向量,輸入到樸素貝葉斯、邏輯回歸或 XGBoost 中。這種方法快速且可解釋,但它捨棄了詞序:「狗咬人」和「人咬狗」會變成相同的向量。N-grams 可以恢復部分局部結構,但代價是詞彙量的爆炸式增長。
深度學習引入了詞嵌入——代表單個單詞的密集向量——使循環神經網絡(RNN)和卷積神經網絡(CNN)能夠對序列和局部上下文進行建模。RNN 按步驟處理 token,維護總結歷史的隱藏狀態;LSTM 和 GRU 加入了門控機制以減緩梯度消失問題。CNN 在相鄰嵌入的窗口上滑動學習過的濾波器,然後通過池化獲得固定長度的表示。這兩種架構都早於 Transformer,但更難訓練且難以並行化。
2018 年的 ULMFiT 論文證明,在大型語料庫上預訓練 RNN 然後進行微調,可以在 IMDb 情感基準測試上達到 95.4% 的準確率,遠高於從頭開始訓練的 LSTM 的 85.7% 以及詞袋模型邏輯回歸的 89.9%。遷移學習成為主流範式,並最終推向了如 BERT 和 GPT 系列等基於 Transformer 的模型。
## Jev 的不同之處
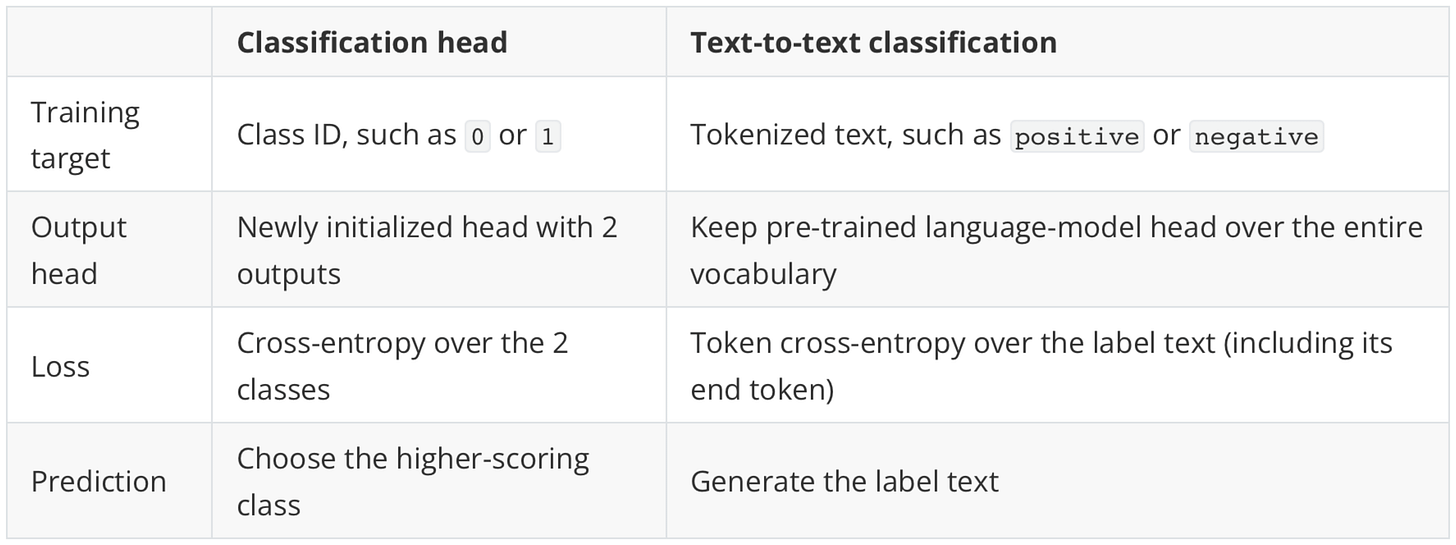
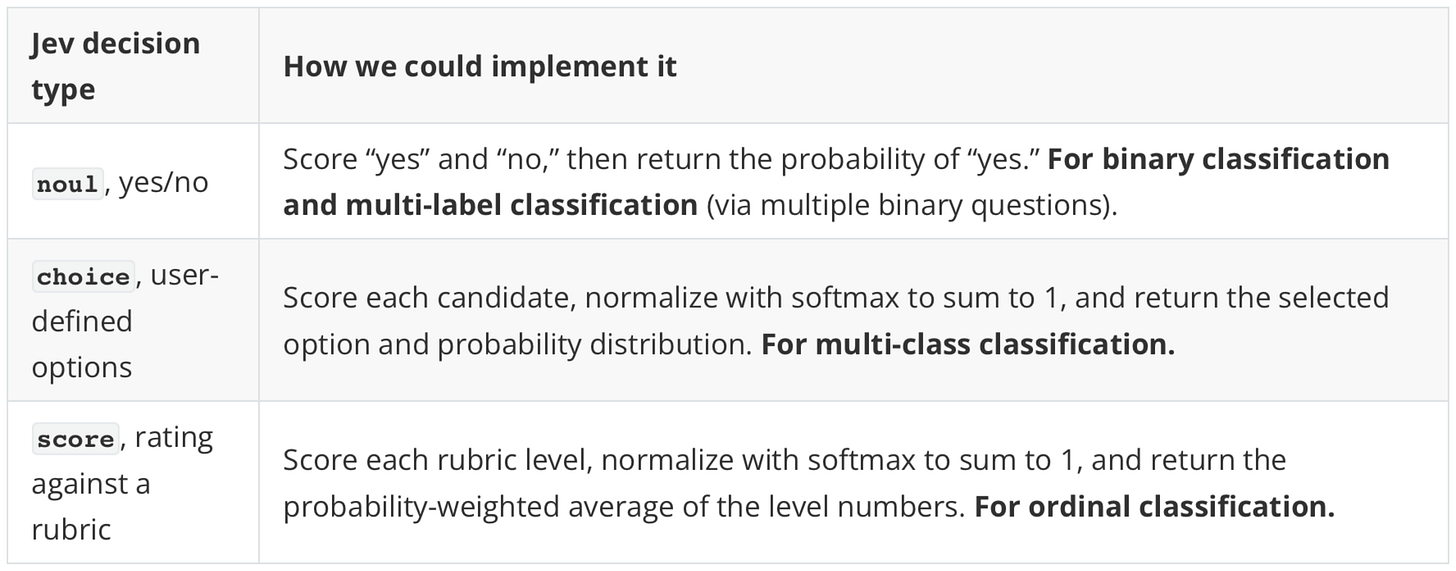
TypeSafe 的公告將 Jev 定位為在幾個維度上偏離 LLM 範式的模型,首先是其輸出空間:Jev 發出預先定義的結構化、類型安全的值——類別、評分、布爾標記。它無法產生自由文本,從構造上消除了幻覺和解析失敗。
TypeSafe 的公告將 Jev 定位為在幾個維度上偏離 LLM 範式的模型:
在 LLM 按順序生成 token(領先模型端到端耗時 3–329 秒)的情況下,Jev 並行計算所有輸出概率,在 70–500 毫秒內完成。其輸入 token 成本為每百萬 0.042 美元,而 LLM 為 0.20–$10 美元,且輸出 token 被描述為便宜到無法計量,因為該模型不生成變長序列。
- **輸出空間**:Jev 發出結構化的、類型安全的數值——預先定義的類別、評分、布爾標記。它無法產生自由文本,從構造上消除了幻覺和解析失敗。 - **採樣**:在 LLM 按順序生成 token(領先模型端到端耗時 3–329 秒)的情況下,Jev 並行計算所有輸出概率,在 70–500 毫秒內完成。 - **訓練目標**:與人類反饋強化學習(RLHF)或可驗證獎勵(RLVR)不同,TypeSafe 開發了用於校準決策的強化學習(RLCD)。目標是「知識上誠實的概率」:當 Jev 給出 90% 的置信度時,它應該在約 90% 的情況下正確,且相似的輸入應產生相似的置信度分布。 - **經濟效益**:輸入 token 的成本為每百萬 0.042 美元(相比於 LLM 的 0.20–$10 美元);輸出 token 被描述為「便宜到無法計量」,因為該模型不生成變長序列。
Raschka 指出,Jev 處於兩個極端之間:既有能夠分類但速度慢且昂貴的通用 LLM,也有針對單一任務速度快且便宜但缺乏通用性的窄域專用分類器。Jev 的賣點是兼具廣度和速度——一個模型即可用於路由、評分、提取、護欄檢查和實時決策分支。
## 校準作為自動化的驅動力
校準的聲明是自動化論點的核心。傳統 LLM 即便在提示要求提供置信度時,往往也傾向於過度自信且不一致。如果一個模型在 95% 的情況下成功,但無法標示出它將失敗的 5%,下游軟件在沒有人工審查的情況下就無法安全地根據其輸出進行操作。Jev 的 RLCD 訓練明確針對報告概率的可靠性進行優化,而不僅僅是 Top-1 準確率。
TypeSafe 的並排演示展示了架構上的差異:Jev 在單次前向傳播中返回預定義鍵的完整概率分布,而 LLM 則會逐個 token 生成 JSON 對象。並行設計還意味著延遲隨模型大小縮放,而非隨輸出長度縮放。
## 範圍與限制
兩個來源都對邊界劃分非常謹慎。Raschka 強調,對於窄域且定義明確的問題,專用分類器可能會在準確性、速度和成本上擊敗 Jev。Jev 的價值在於通用性:「比那些特定任務的模型通用得多。」TypeSafe 承認長期定價的可持續性尚未得到證實,且發佈的延遲數據來自位於當前服務區域的西海岸筆記本電腦。
該模型目前處於早期訪問階段。來源包中未提供獨立基準測試或第三方評估。arXiv 參考(Raschka, 2014)提供了關於樸素貝葉斯的歷史背景,但與 Jev 的性能無關。
## 為何技術社群產生反應
附加在 Hacker News 提交上的討論提示捕捉到了一個循環的主題:花費多年時間構建每項任務分類器的開發者看到 Jev 可能是一個轉折點——一個模型,無需微調,立即獲得結構化輸出。與 ChatGPT 對文本生成影響的類比非常明確:一個通用工具,去除了廣泛問題類別中的定制工程步驟。
Jev 是否能在大規模上兌現這一承諾仍有待驗證。但其架構選擇——並行結構化輸出、校準概率、固定架構決策——代表了對於從根本上屬於分類型 AI 工作負載的、與主流 LLM 範式不同的連貫替代方案。