Histerは、訪問したWebページ、ブラウザの履歴とブックマーク、ローカルファイル、クロール対象として指定したWebサイトからパーソナルなインデックスを構築するセルフホスト型の検索エンジンです。ライブWebにクエリを送る従来の検索エンジンとは異なり、Histerは抽出した文書コンテンツを検索インデックスとともに自身が運用するサーバに保存するため、元のページが変更されたり消滅したりしても情報を見つけられます。
## 仕組み
Histerサーバをローカルまたは自身が管理するマシンで実行します。FirefoxまたはChrome用のブラウザ拡張機能によって、ページを訪問すると自動的にインデックス化できます。また、既存のブラウザ履歴とブックマークをインポートしたり、ローカルディレクトリを監視して新しいファイルを検知したり、特定のWebサイトをクロールしたりすることも可能です。サーバはHTML、PDF、その他サポート対象のフォーマットからテキストを抽出し、タイトルとURLだけでなく全文をインデックス化します。
同じインデックスを複数のインターフェースから検索できます。`http://127.0.0.1:4433` でアクセスできるWeb UI、ターミナルベースのUI(TUI)、コマンドラインツール、HTTP API、そしてMCP(Model Context Protocol)エンドポイントで、AIアシスタントが検索結果を直接取得できます。
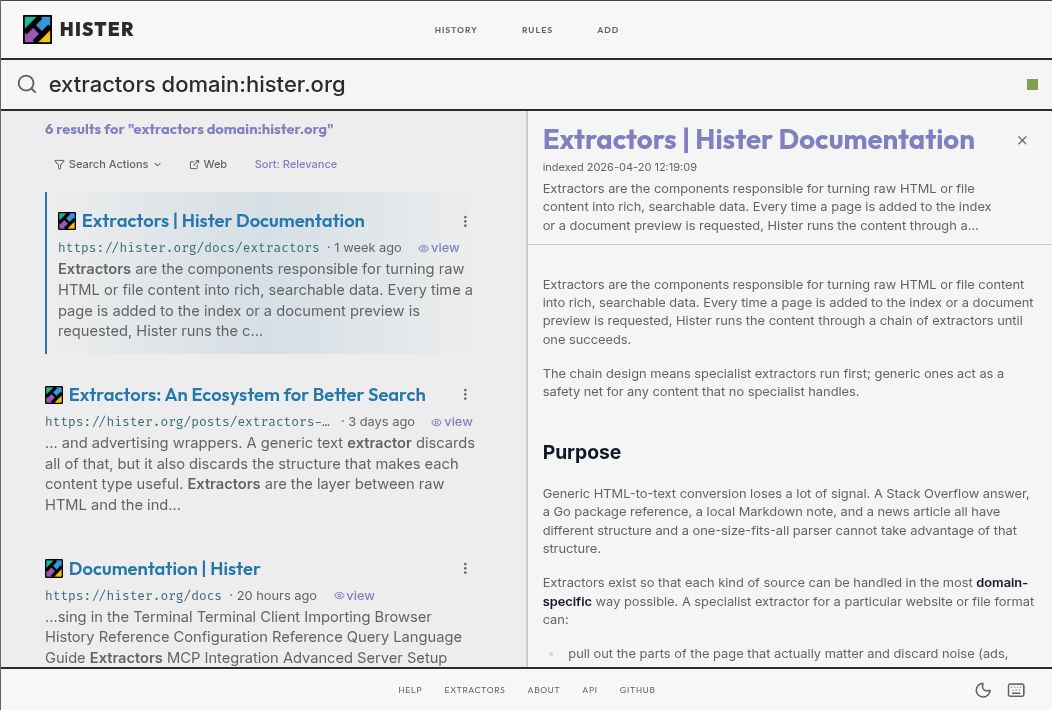
この画像は、http://127.0.0.1:4433 にあるHister Webユーザーインターフェースを示しており、ユーザーはインデックス化されたページやファイルを検索し、保存されたコンテンツの読みやすいプレビューを表示し、検索インターフェースを離れずに結果をナビゲートできます。
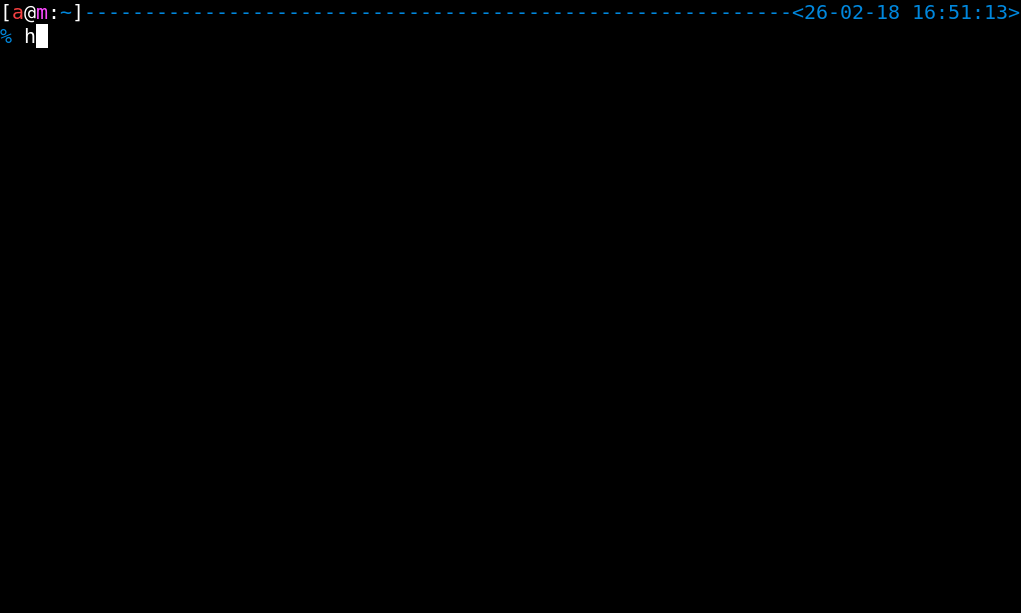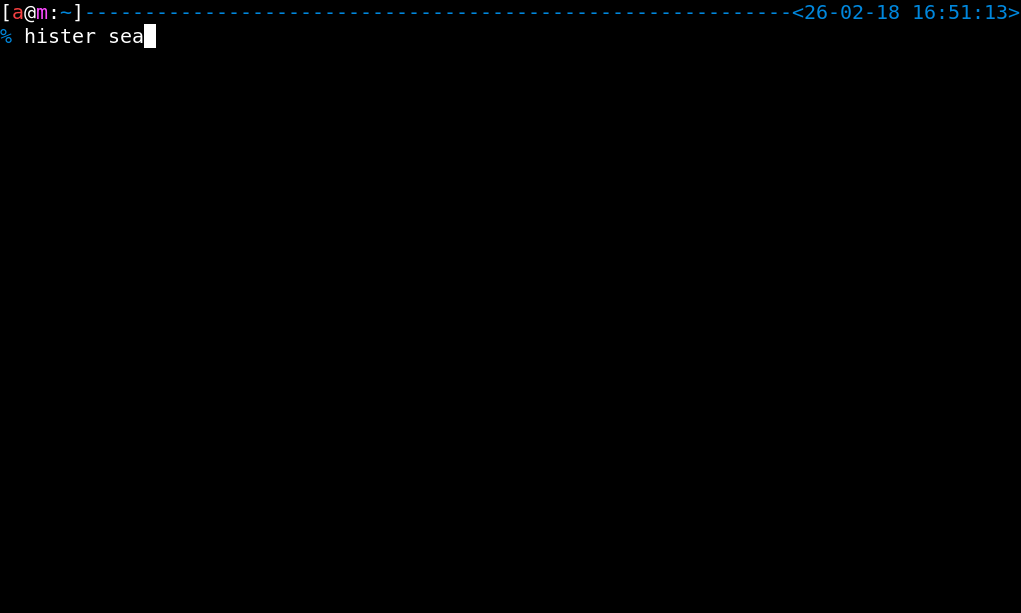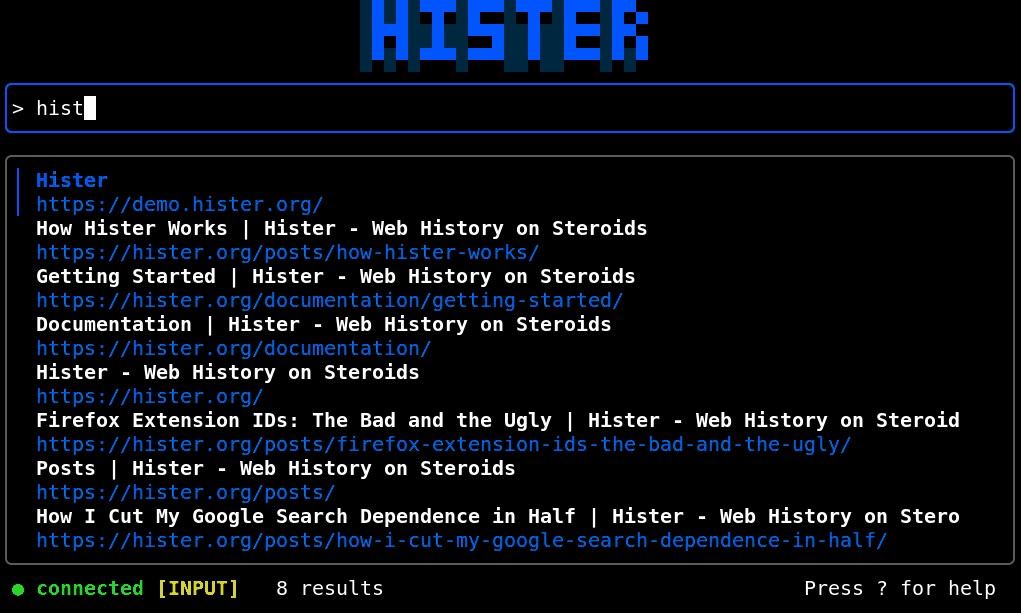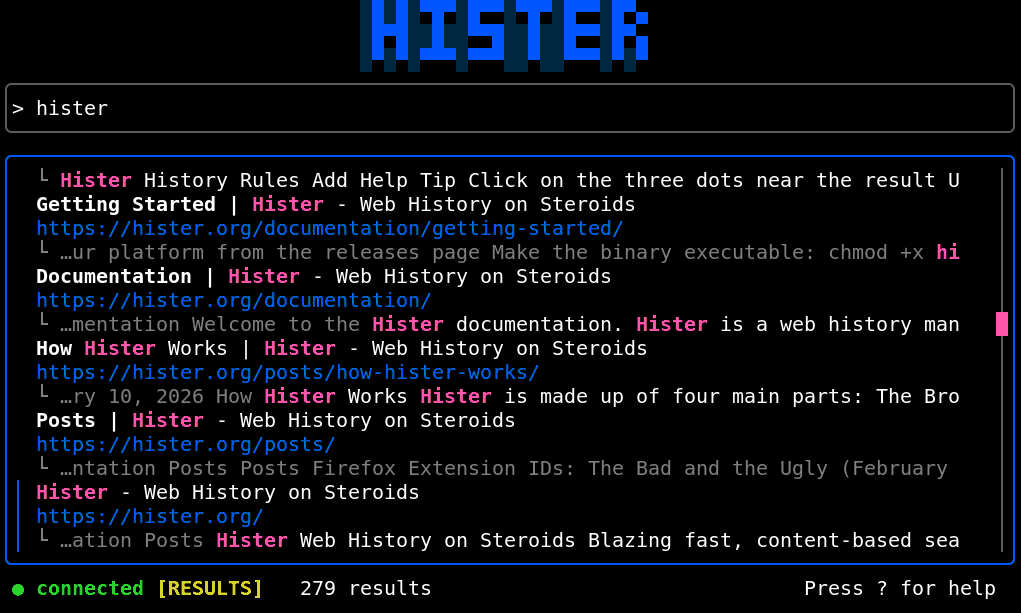
このアニメーションGIFは、Histerターミナルユーザーインターフェースを示しており、パーソナルインデックスをキーボード操作で検索し、結果をブラウズし、Web UIと同じ機能をコマンドラインから利用できることを説明しています。
## 検索機能
Histerは単純なキーワード検索を超える豊富なクエリ言語をサポートしています。
- `url:`、`title:`、`domain:` などの特定属性内を検索する**フィールドフィルタ** - 完全一致のための**引用符で囲んだフレーズ** - **ワイルドカードと否定**(例: `python -snake`) - インデックス化された日時で絞り込む**日付範囲** - 再利用可能な複雑なクエリのための**クエリエイリアス** - 特定のソースを優先する**結果の優先度設定**
オプションのセマンティック検索を有効にすると、正確な用語ではなく意味で文書を検索できます。これは文書のテキストを設定した埋め込みエンドポイント(Ollama経由のローカルモデルやリモートAPIなど)に送信することで動作し、プライバシー設定に応じて有効・無効を切り替えられます。
## コンテンツの処理とプレビュー
Histerがページをインデックス化すると、抽出したコンテンツを検索インデックスとともに保存します。検索結果には、保存されたコンテンツの読みやすいプレビューが元のURLとともに表示されるため、検索インターフェースを離れずにマッチ内容を確認できます。コンテンツがローカルに保存されるため、ソースページが後から編集されたり、ペイウォールの対象になったり、完全に削除されたりしてもアクセス可能です。
インデックスルールにより、何をインデックス化し、どうランク付けするかを制御できます。スキップルールでは一致するURLやパターンを除外し、優先ルールでは好みのソースからの結果をブーストします。バージョン追跡では、文書が変更された際に過去のバージョンを保持できます。機密コンテンツチェックでは、ユーザーが定義したパターンに一致する素材をフラグ付けしたり除外したりできます。
## プライバシーモデル
Histerにはテレメトリがなく、デフォルトでは外部へのネットワークリクエストを行いません。ブラウザ拡張機能は、設定したHisterサーバにのみページコンテンツを送信します(ページのファビコン取得を除く)。サーバは文書とインデックスをローカルに保存します。オプションのセマンティック検索では、選択した埋め込みエンドポイントにテキストを送信します。スタック全体を単一マシンでクラウド依存なしに実行できます。ソースコードはAGPLv3ライセンスです。
## デプロイオプション
単一のバイナリがLinux、macOS、Windowsで動作し、個人利用では設定不要です。共有サーバ向けには、ユーザーごとの文書分離による複数ユーザー対応があり、バックエンドにはSQLiteまたはPostgreSQLを使用できます。DockerとNixのパッケージも提供されています。開発にはGo 1.26、npm、CGO依存関係のためのCコンパイラが必要です。
## 背景と制限事項
このプロジェクトの作者は以前、プライバシーを尊重するメタ検索エンジンであるSearxを構築しましたが、メタ検索モデルの限界に直面し、パーソナルインデックスのアプローチへ移行しました。Chromeには2008年から2013年にかけて同様の全文履歴検索機能が搭載されていましたが、その後削除されました。
ユーザーが指摘する現在の制限事項には、ブラウザ拡張機能がデフォルトで訪問したすべてのページをインデックス化すること(改善案として、4秒以上閲覧したページのみをインデックス化する滞在時間の閾値設定が提案されています)、主要なLinuxディストリビューションのリポジトリにまだパッケージ化されておらず、一部ユーザーはこれを導入の障壁と見なしていることなどがあります。MCP統合は比較的新しく、さまざまなAIアシスタントでの実用性はコミュニティによって模索中です。