現代のAIパイプラインでは、メールのトリアージ、フィッシング検知、チケットのルーティングといった単純で構造化されたタスクに、生成型大規模言語モデル(LLM)が頻繁に利用されています。このアプローチは、モデルがトークンをストリーミングする必要があるため大きな遅延を生じさせ、さらにハルシネーション(幻覚)や数学的なキャリブレーションの欠如といった課題を引き起こします。新たにリリースされたオープンソースの意思決定エンジンであるLayaは、「システム1」アーキテクチャを採用することでこれらの非効率性を解消しています。これは、自由形式のテキストを生成することなく、反射的な意思決定を即座に行う非自己回帰型のアプローチです。Layaは、「choice(基準辞書からの選択)」、「score(入力の順序尺度への配置)」、「noul(直接的なブール確率予測)」という3つの主要なプリミティブを使用して動作します。モデルは数値と確率のみを出力するため、正規表現やJSON解析の必要がなく、生成モデルに共通するハルシネーションも防止されます。このシステムは、標準的なハードウェア上で質問あたり約33ミリ秒という推論速度を達成しており、従来の生成型LLMワークフローを大幅に上回る性能を発揮します。多様な入力を処理するために、Layaには22種類のアルファベットにわたる入力テキストのUnicodeスクリプトを検査する組み込みルーターが含まれており、無視できる程度のオーバーヘッドで、多言語対応のmmBERT-baseモデルなどの適切な専門チェックポイントへリクエストを自動的に振り分けます。このルーティング機能により、システムは100以上の言語で高い精度を維持します。LayaはApache 2.0ライセンスの下で公開されており、独自の意思決定APIに代わる透明性の高いセルフホスト可能な選択肢を提供します。生成テキストではなくキャリブレーションされた信頼スコアに焦点を当てることで、Layaは自己回帰モデルに依存するよりも高速で信頼性の高い、本番環境に対応したガードレールや自動化ワークフローの構築を可能にします。
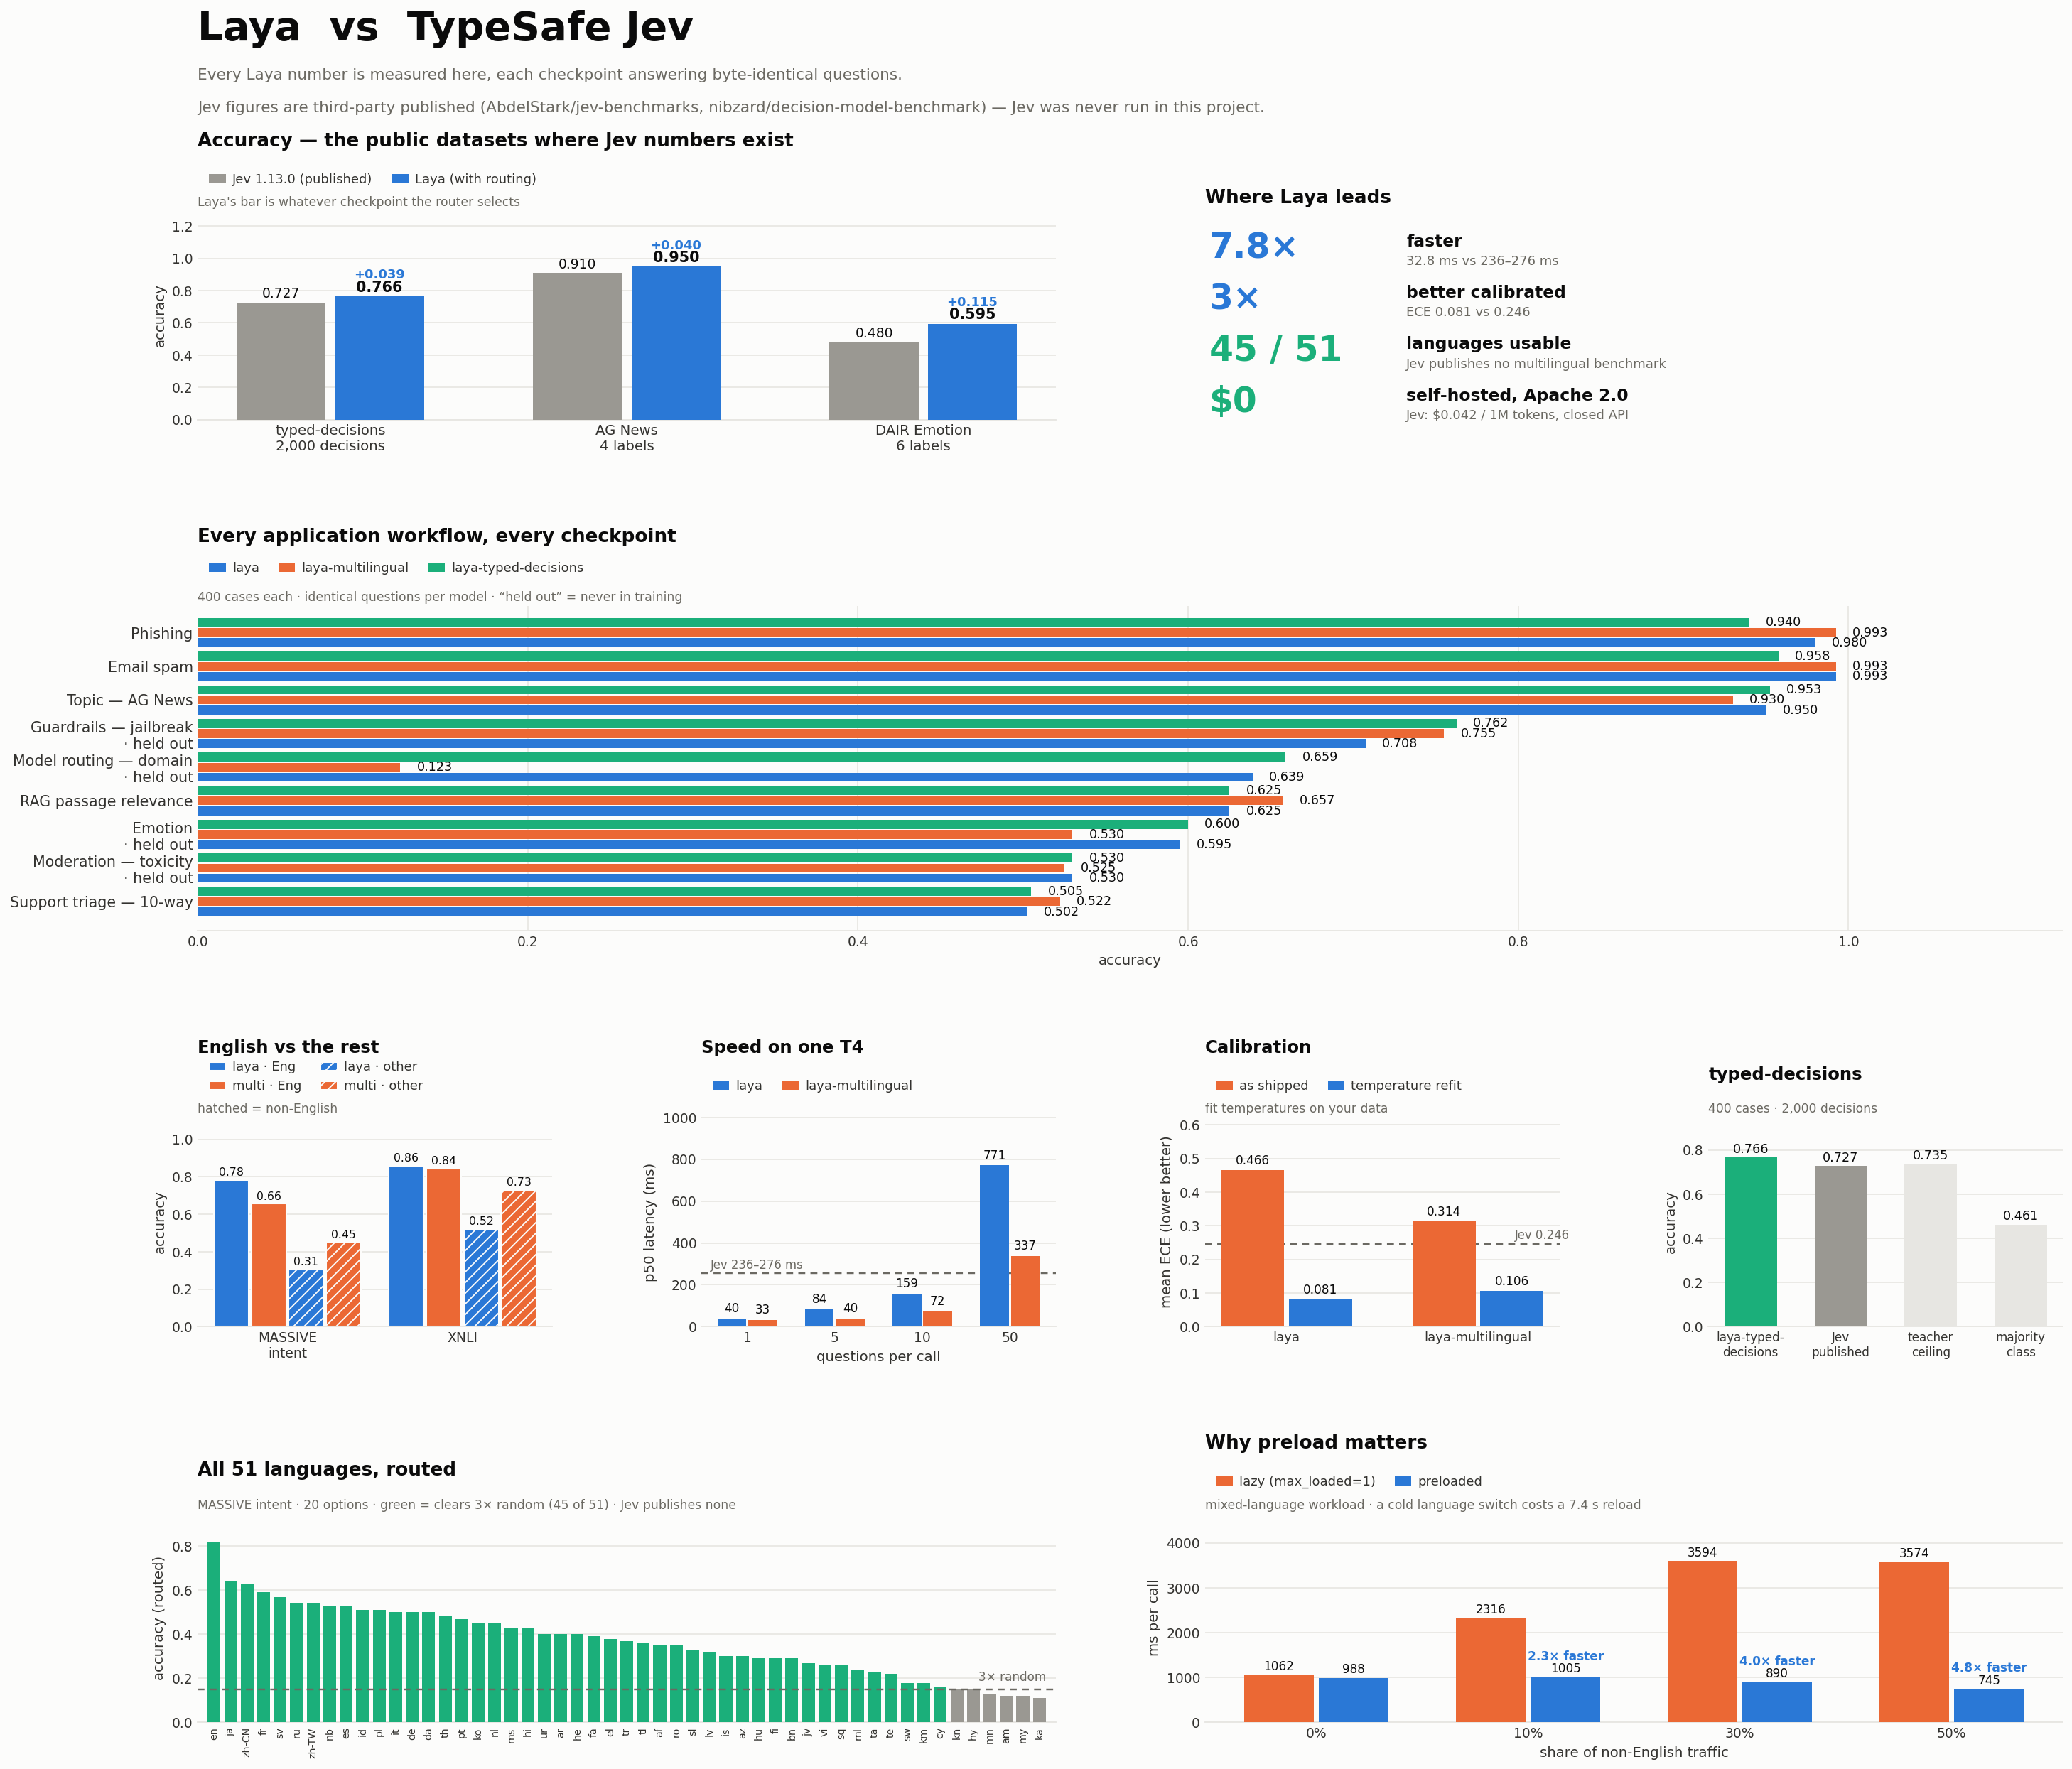
このチャートは、TypeSafe Jevのような既存の意思決定フレームワークと比較した際の、Layaの非自己回帰型アーキテクチャのパフォーマンス上の利点を示しています。