Kevは、ローカル環境またはユーザー管理のエンドポイントで動作するように設計された、Qwen3.5をベースとする小型意思決定モデルのオープンソースファミリーです。このプロジェクトは、0.8B、4B、9Bのバリエーション、トレーニングコード、評価データ、およびTypeSafeのSystem Oneインターフェースと互換性のあるAPIを提供しています。
このシステムは、1つのリクエストでいくつかの質問タイプに回答します。それには、はい/いいえの意思決定、多肢選択式のルーティング、および数値による評価が含まれます。各質問は同じ入力テキストを共有しますが、互いに読み取ることはできないため、サポートチケットをルーティングし、エスカレーションの確認を行い、不満度をスコアリングすることが、回答の相互依存を避けることなく実行可能です。
リポジトリは、実用的なローカルパスも提供しています。CUDA、ROCm、およびApple Siliconのサポートについて文書化されており、4Bおよび9Bモデルは32GBのMacに適合すると記載されています。例示されているサーバーはデフォルトでlocalhostにバインドされますが、リモートアクセスにはAPIキーが必要になる場合があります。
最も明確な証拠は、プロジェクト独自の評価テーブルです。「新しいソース」において、報告されているテスト精度はKev-0.8Bで0.684、Kev-4Bで0.837、Kev-9Bで0.852となっており、より大きなモデルについてはより低いBrierスコアも報告されています。これらは発行者が報告した結果であり、独立した検証ではありません。
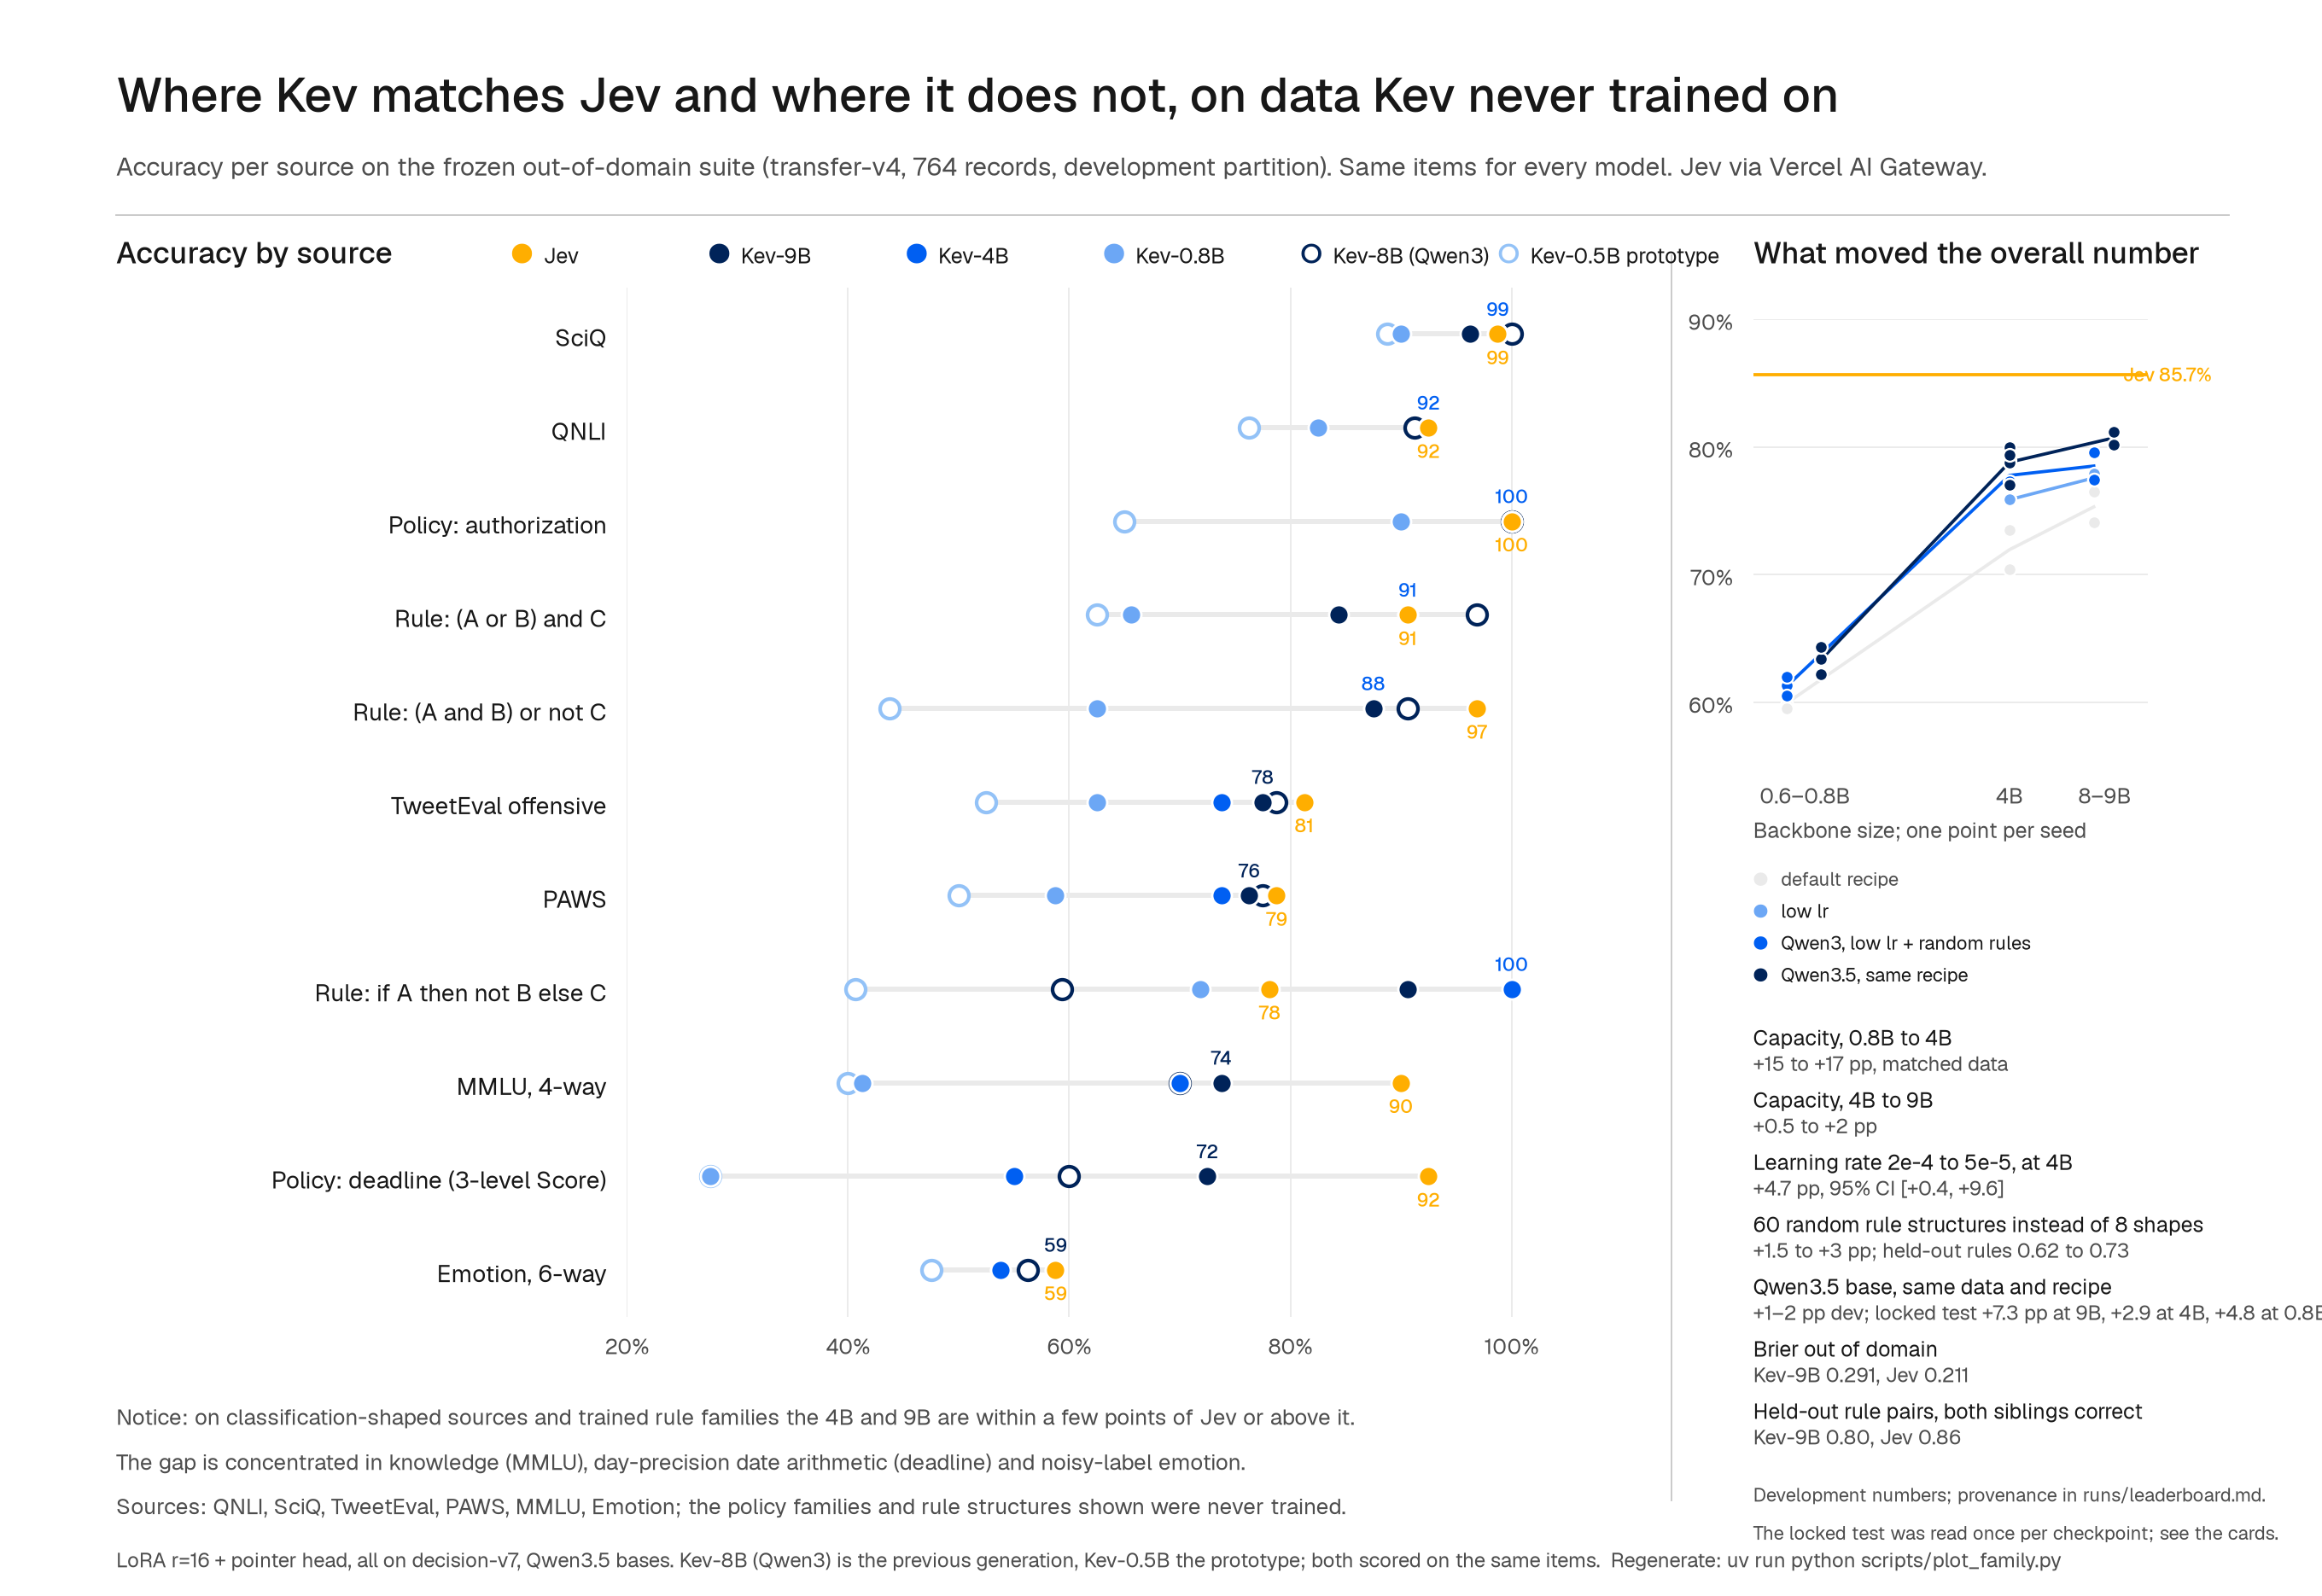
この記事では、プロジェクトの報告された評価テーブルと、KevをJevと比較する際の制限について論じています。このチャートは、それらのソース固有の結果を直接視覚化したものです。
READMEには、Jevのトレーニングデータセットが不明であるため、Jevとの比較は制御されていないことが警告されています。これは、Kevを類似のシステムと比較検討する読者にとって重要な点です。このパッケージは、Kevの設計意図と自己報告されたベンチマークをサポートしていますが、Kevが一般的にJevよりも正確であるという決定的な主張を裏付けるものではありません。