Kageは、稼働中のサイトを静的なオフラインコピーへ変換することで、Webの保存に取り組むオープンソースのコマンドラインプロジェクトです。開発者は、ヘッドレスChromeが各ページをレンダリングし、完成したDOMを取得してスクリプトを削除したうえで、CSS、画像、フォントへの参照をローカルパスに書き換える仕組みだと説明しています。リポジトリの中心的な主張は、生成されるページがライブサイトと同じ見た目を保ちながら、JavaScriptを実行せず、ネットワーク要求も行わないという点にあります。
この違いは重要です。従来のブラウザの保存機能では、クライアントサイドレンダリングが終わった後のページを再現せず、ソースマークアップだけを保存する場合があります。一方のKageは、ページが落ち着くのを待ってからスナップショットを取得します。実用的には、サーバーが最初に返すHTMLだけでなく、読者が目にするレンダリング後の状態を保存しようとするツールです。これは、価値がインタラクティブな動作よりもコンテンツそのものにある、文書、評論、チュートリアル、その他の比較的静的なサイトに向いています。
プロジェクトは、シンプルな作業の流れを文書化しています。`kage clone` は閲覧可能なミラーを作成し、`kage serve` はローカルでプレビューし、`kage pack` はミラーを単一の成果物へ圧縮します。cloneコマンドでは、ページ数とクロール深度を制限したり、特定のパス接頭辞をたどったり、サブドメインを含めたり、スクロールして遅延読み込みのアセットを呼び出したり、中断後の処理を再開したりできます。文書では、クローラーが `robots.txt` を読み取り、`sitemap.xml` から作業の初期対象を得るとも説明されていますが、オプションでこれらの既定値は変更できます。
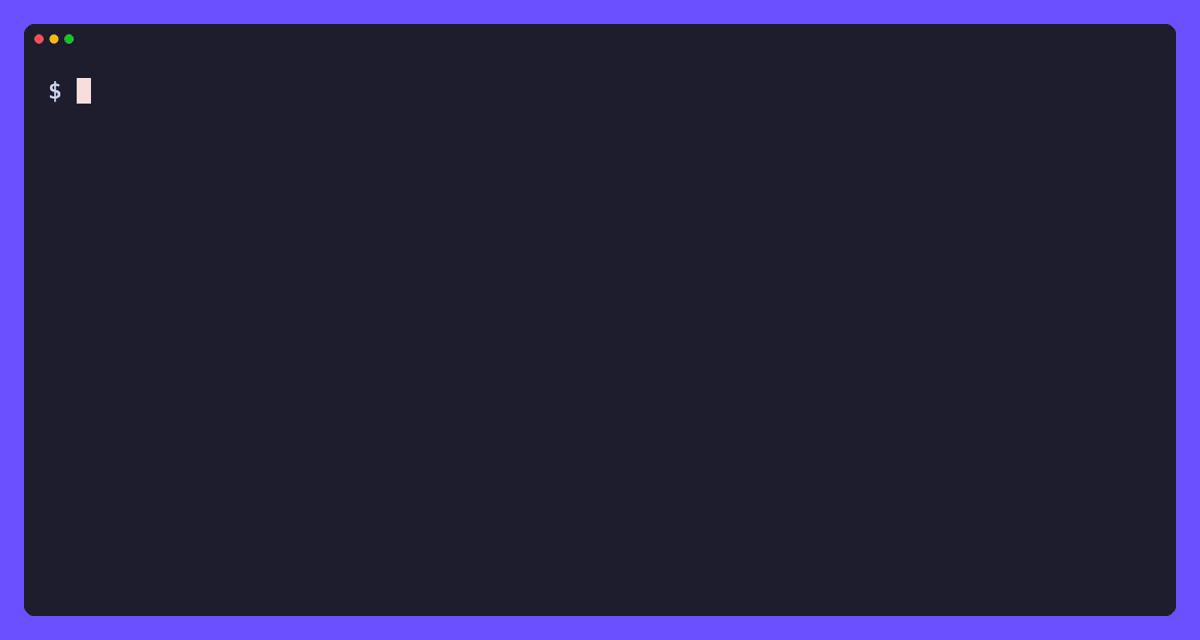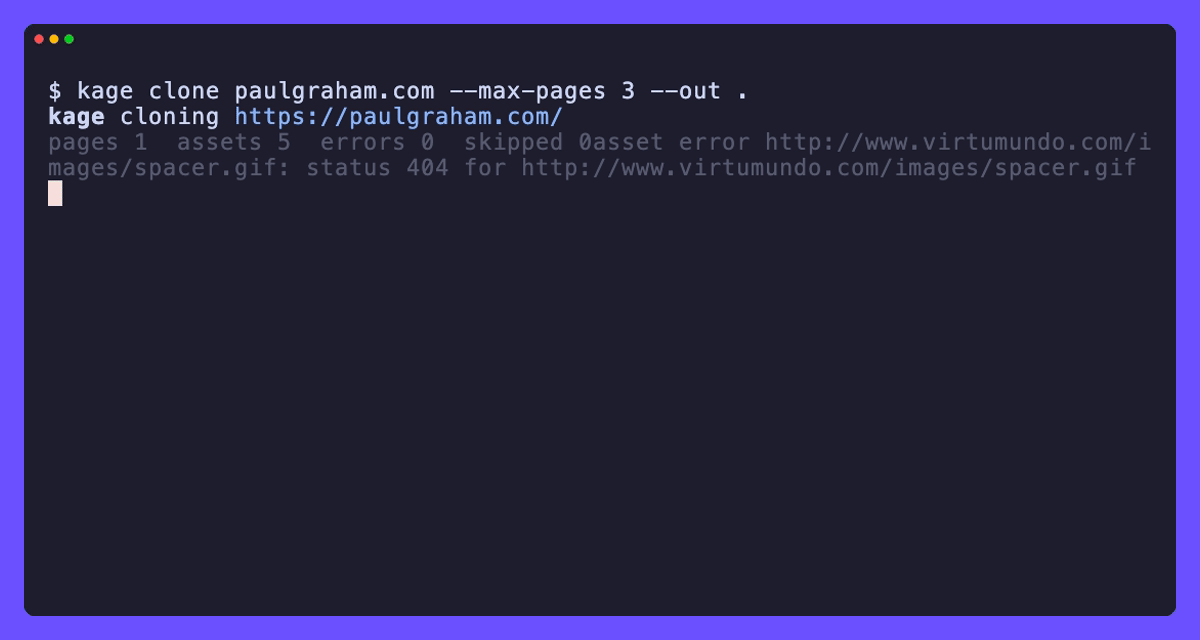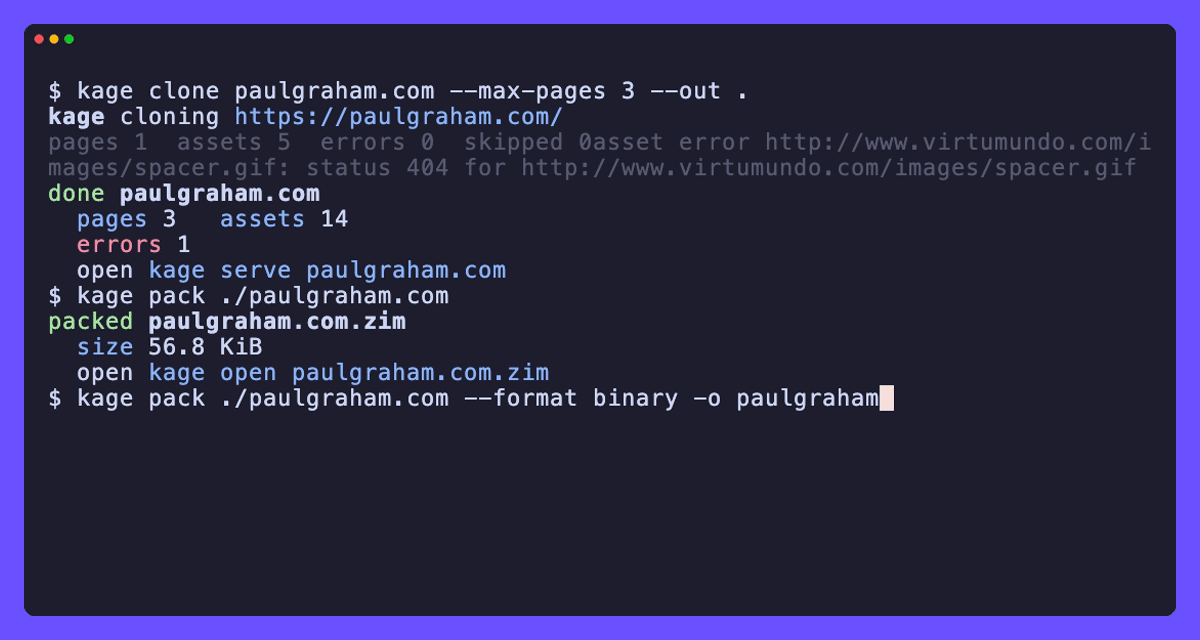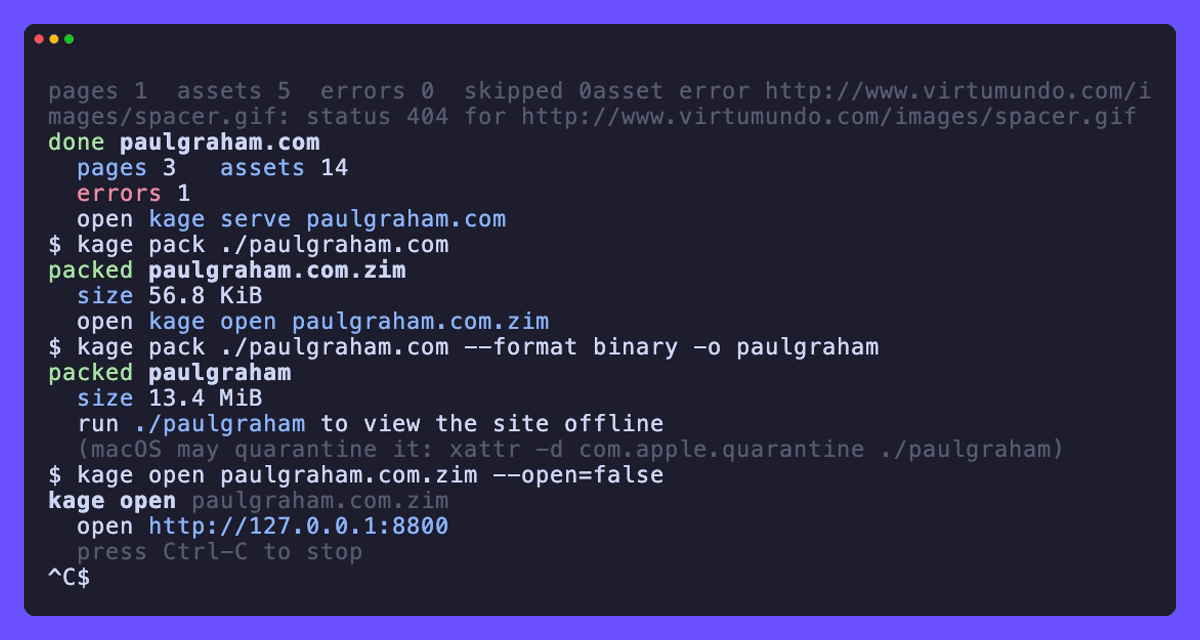
このデモは記事で文書化されたclone、pack、serveの作業流れに沿っており、完成したサイトが元のライブ接続なしで動作する様子を示します。 出典・クレジット:github.com。
転送と長期的なアクセスのため、KageはKiwixのオフラインコンテンツ基盤で使われるZIMアーカイブを生成できます。リポジトリによると、テキストはZstandardで圧縮されますが、メディアにはこの圧縮処理が適用されません。同じアーカイブをKiwixのツールやアプリケーションで開けるとも記載されていますが、Kageは一部のKiwixパックに含まれる全文検索インデックスを作成しません。この制約があるため、専用アーカイブと比べてリーダー内の検索機能が劣る場合でも、閲覧操作は利用できるままとなる可能性があります。
もう一つの保存形式として、アーカイブをKage実行ファイルの末尾に付加し、Kage、ZIMリーダー、その他のインストールを行わずにサイトを配信できる単一ファイルを作成できます。代償はファイルサイズです。リポジトリでは、サイト自体の容量に加えて、ビューアー部分が約13 MiBになると見積もっています。オプションのビルドでは、プラットフォーム固有のWebViewを使って結果をネイティブウィンドウで開けます。一方、標準の純粋なGoビルドではシステムブラウザを開きます。これらはプロジェクトが文書化した実装上の選択肢であり、すべてのオペレーティングシステムや将来のブラウザバージョンについて独立して保証されたものではありません。
このスクリーンショットは、記事で説明したオプションの単体実行ファイルと、ネイティブWebViewで閲覧する仕組みを示しています。 出典・クレジット:github.com。
スクリプトを削除するという主張は、正確に理解する必要があります。提供されたリポジトリが説明しているのは、取得済みの出力からJavaScriptを取り除き、リンク先のアセットをローカル化するという処理であり、あらゆるWebサイトを忠実に保存できると実証しているわけではありません。フォーム、認証、ストリーミングメディア、サーバーに依存する操作、外部の第三者コンテンツ、ライブAPIを必要とする機能は、欠落したり品質が低下したり、最後にレンダリングされた状態だけが残ったりする場合があります。したがって、スナップショットは外観と閲覧可能なコンテンツを保存できても、元のアプリケーションの動作までは保存できません。
また、Kageが著作権、利用規約、ペイウォール、個人データ、サイト固有のアクセス制御をどのように扱うかを示す証拠もありません。文書にあるクロール設定が表しているのは技術的な動作であり、法的な許可ではありません。読者は、このツールを、自分がアクセスする権利を持つ資料の許可されたコピーを作成する手段として扱い、各情報源に付随する規則は別途評価する必要があります。
Kageの文書化された最も強力な考え方は、分離です。実際のブラウザに目に見えるページを作成させ、そのうえで、元のサイトのJavaScriptに依存しない静的な表現を保持します。同じく重要なのが、その限界です。アーカイブは、設定された範囲内で特定の瞬間に行われたクロールを記録するだけであり、動的コンテンツ、非表示の状態、サイトの将来のバージョンまで取得済みであることを証明できません。適切な種類のWebサイトであれば、オフライン読書を実現する実用的な手段になります。しかし、完全なWebアプリケーションにとっては、動作する複製ではなく、ひとつのスナップショットにすぎません。