「Transformer Explainer」は、実用的な問いから始まります。テキストモデルは、過去のトークンを考慮しながら、どのようにして1つのトークンを生成できるのでしょうか。その答えは、会話全体をひとつの固定された要約へ押し込むというものではありません。このページで示されているdecoder-onlyのGPT型アーキテクチャでは、各トークンが独自の表現を保持します。そしてモデルが次トークンを予測する前に、複数の層がそれらの表現間で情報を繰り返し交換し、変換します。
最初の段階では、プロンプトをネットワークが処理できる数値へ変換します。tokenizerはテキストを単語または部分単語へ分割します。各トークンにはembedding vectorが与えられ、positional encodingによって、そのトークンが配列内のどこに位置するかが加えられます。この解説ツールが使用する小規模なGPT-2モデルについて、ページは50,257個の語彙、768次元のトークンベクトル、12段に積み重ねられたTransformerブロックを挙げています。これらはこの教育用モデルの性質であり、すべての現代言語モデルに共通する定数ではありません。
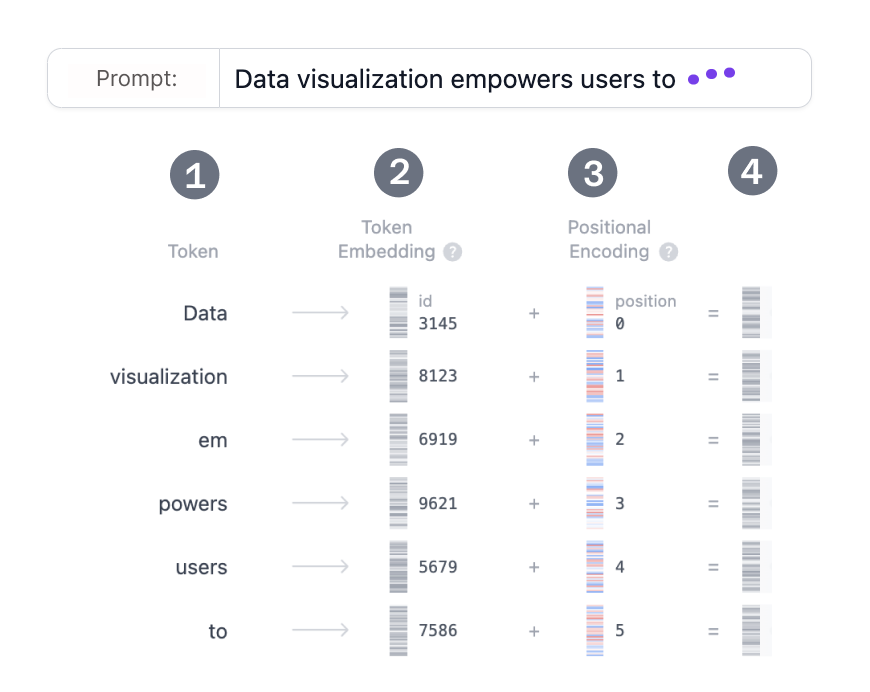
トークナイジング、埋め込みベクトル、positional encoding、GPT-2のモデル次元についての説明の後に配置。
各ブロックの内部では、multi-head self-attentionによって、あるトークンの表現がほかのトークンからの情報を取り込めます。モデルは学習済みの重みを用いて、query、key、valueの各ベクトルを導出します。queryとkeyの比較によってattention scoreが得られます。causal maskは、decoderが現在の次トークンを予測する際に、未来のトークンを利用できないようにします。softmaxはスケーリング済みのスコアを重みへ変換し、valueベクトルの重み付き結合が後続の処理へ渡されます。複数のheadはベクトルを複数の部分空間へ分割し、それぞれが異なる関係を学習できます。ただし、ページにあるウェブ検索との比喩を、特定のheadが実際に何を表しているかについての文字どおりの説明と受け取ってはいけません。
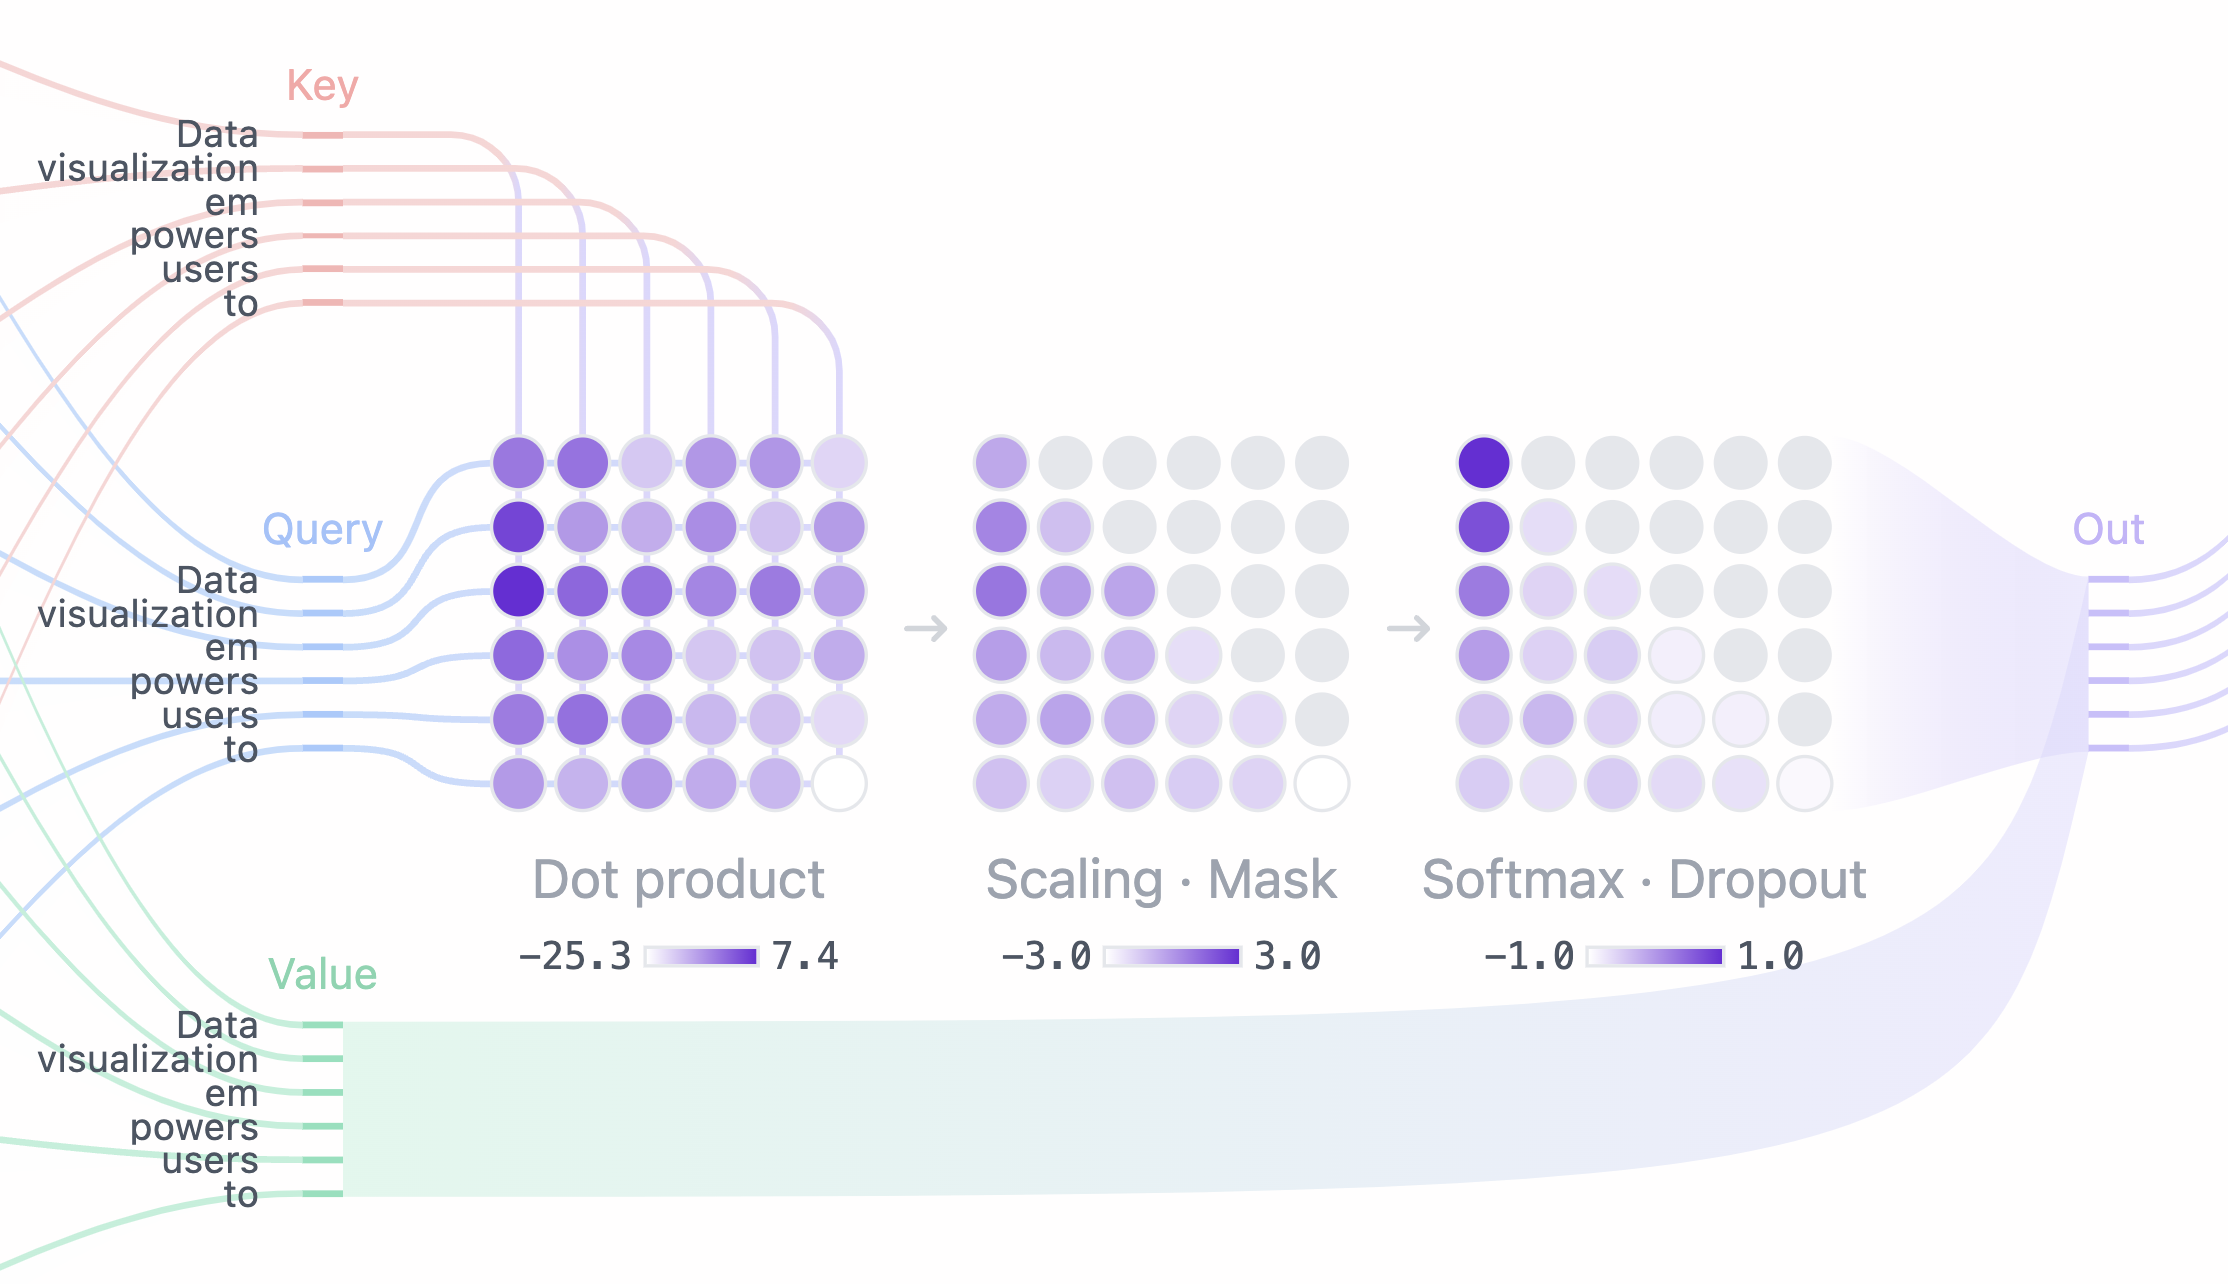
query、key、valueベクトル、causal mask、attention weight、複数のattention headについての説明の後に配置。
attentionは、この解説ツールが説明する標準ブロックの半分ほどにすぎません。attentionの出力はmultilayer perceptron、つまりMLPを通り、各トークン表現に独立して学習済みの変換を適用します。GPT-2の例では、768次元の各表現をいったん3,072次元へ広げ、GELUという非線形変換を適用してから、ふたたび768次元へ射影します。attentionとMLPの操作が交互に現れることが重要です。ほかの位置から集められた情報は、まず局所的に変換され、その後のattention層で再び利用できます。この繰り返しの混合によって、ある時点のベクトルが一見平坦に見えるからといって、モデルがほかの文脈を永久に捨てたことを意味するわけではありません。
最後のブロックの後、linear layerが語彙内のすべてのトークンに対して1つずつlogitを出力し、softmaxがそれらのlogitを確率分布へ変換します。samplingによって次トークンを選択し、そのトークンを配列へ追加すると、同じ処理が続きます。temperatureは確率分布の鋭さを変え、top-k samplingとtop-p samplingは候補の集合を制限します。これらの制御は予測のしやすさと多様性に影響しますが、それだけで出力が安全、誠実、あるいは創造的であると保証するものではありません。
有用な境界線は、外見上の違いではなくアーキテクチャの違いにあります。Hugging Faceの技術文書では、もともとのencoder-decoder型Transformerを、BERTのようなencoder-onlyモデルやGPT-2のようなdecoder-onlyモデルと区別しています。また、audio Transformerではinput adapterを追加することが多いとも説明しています。たとえばconvolutional feature encoderは、waveformまたはspectrogramを、Transformerが処理するembedding sequenceへ変換できます。これは、「Transformer」という名称が、入力、masking、output headがタスクに応じて変化する、再利用可能なアーキテクチャの一族を指しているという広い見方を支えるものです。一方で、すべての音声・言語システムが、このデモで可視化されたGPT-2とまったく同じ処理経路を使うことを示すものではありません。
このインタラクティブなページのrepositoryは、このソフトウェアがブラウザ上で動作する学習ツールであり、実際にGPT-2モデルを実行していると明示しています。また、2026年のCHI論文へのリンクも掲載しています。したがって、repositoryはプロジェクトの実装と作者情報を裏づけます。しかし、この可視化が最も分かりやすい説明であること、あるいはその比喩が普遍的に妥当であることを示す独立した証拠ではありません。同様に、この解説ツールがattentionの働きについて述べる内容は、デモで示されたアーキテクチャの説明であり、あらゆるTransformer headの内部に学習された概念に関する実験的な証明ではありません。
言語モデルを理解しようとする読者にとって、最も生産的なmental modelは、圧縮された段落に対する検索ではなく、文脈を反映した変換の連続です。attentionは、ある層において表現をどのように組み合わせるかを決定します。MLPはそれらを変換し、residual connectionとnormalizationは、積み重ねられた計算を学習しやすいものにします。そしてoutput layerが、最終的な表現を次トークンの確率へ変換します。個々の重みやheadが担う正確な役割はモデルとタスクに依存するため、この可視化は計算の仕組みを説明しますが、特定のモデルが特定の答えを出す理由まで完全に説明するわけではありません。