提供された投稿によると、Fable 5はサブスクリプションプランを通じて利用できるAnthropicのモデルです。中心となる主張は、基盤となる重みが変更されたことが証明されたというものではなく、ユーザーが異なる推論方式――プロンプトへの回答に用いられる計算量の割り当てと推論処理――を受け取る可能性があるというものです。Lon Lundgren氏は、Fable 5が恒久利用可能になった後、8月の呼び出しでは7月と比べ、5つの測定方法のすべてで「思考トークンが劇的に少なかった」と報告しています。「思考トークン」とはモデルの推論出力トークンであり、その数が少ないほど、最終回答の前に内部で行われる考察が少なくなる可能性があります。
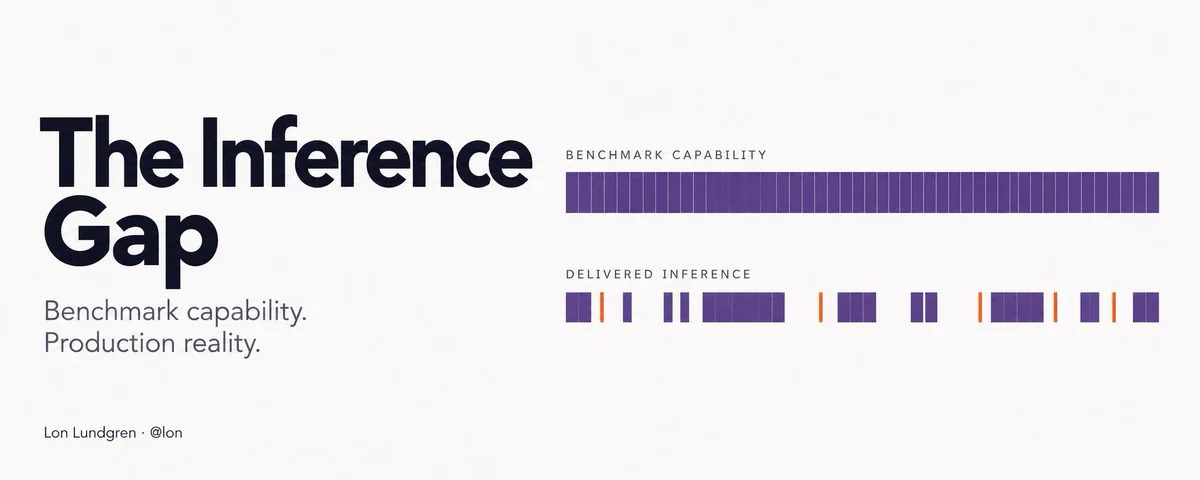
Lundgren氏の投稿は、5つの測定方法すべてにおいて8月の呼び出しで7月より思考トークンが少なかったとする本記事の報告における一次情報源です。
投稿によると、この傾向は6週間にわたって続き、数日単位の揺れがあり、一部は製品発表やリリースと時期を同じくしていました。Lundgren氏によれば、インターフェース上はxhighまたはmaxの努力度が指定されているように見える場合でも、大半のリクエストでは思考がほとんど、またはまったく行われず、長時間実行しても公開ベンチマークの水準に達することはまれだったとのことです。これは、同じモデルでも日によって有能に感じられたり弱く感じられたりするのはなぜかを説明する一因になります。表示されるモデル名が変わらなくても、提供方式は変化する可能性があるためです。
読者にとって重要なのは、これが意図的な「弱体化」を証明するかどうかです。証明しません。一次資料が示すのはLundgren氏による測定結果とその解釈であり、Anthropicの意図、割り当て変更の原因、すべてのユーザーが同じ傾向を経験したかどうかまでは示していません。提供された資料には、基礎データ、5つの方法の定義、Anthropic独自のベンチマークプロトコルとの直接比較も含まれていません。
Marginlabの個別トラッカーは、モデル性能をどのように監視できるかを示す文脈としてのみ関連します。それによると、Claude CodeとOpus 5.0を、厳選したSWE-Bench-Proのサブセットでベンチマーク評価しており、統計的に有意な変化を検出するため、毎日50回評価し、さらに週次・月次により大規模なサンプルを用いているとのことです。ページではベースライン収集が現在も進行中で、劣化検出は一時停止中だとされているため、Fable 5に関する主張を裏づけるものではなく、同じ問題がほかのモデルにも影響していると立証するものでもありません。
実務上の影響として、契約者には不確実性が生じます。出力品質の一貫性は、選択するモデルだけでなく、実際に提供される推論予算にも左右される可能性があるためです。報告された8月の低下が一時的なものだったのか、負荷に関連したものだったのか、ポリシーによるものだったのか、特定の製品変更と結び付いていたのかは分かっていません。この資料だけに基づけば、慎重に主張できる結論は、Lundgren氏が思考トークンの使用量について大幅な減少を観測した一方、その原因とより広範な発生範囲は未確認のままだという点です。