DataHaskell組織は、データフレームライブラリ内にネイティブなParquetライターを実装することで、データサイエンスツールキットを拡充しました。Parquetは、効率的なデータ取得と圧縮に最適化された広く利用されている列指向ストレージフォーマットであり、現代のデータサイエンスツール全体における相互運用性の標準となっています。これまでHaskell開発者は主にCSVやJSONといったフォーマットに制限されており、これらはパフォーマンス上の制約を受けることが多く、大規模なデータ分析に必要な構造的メタデータも不足していました。ネイティブなParquetサポートを可能にすることで、このライブラリはユーザーがシンプルなインターフェースを使用してデータフレームを直接ディスクに書き込めるようにし、同時に特定のワークロードに合わせて行グループやページサイズを微調整するための高度な設定オプションも提供します。この実装では、データをディスクにフラッシュする前にバッファリングする際の複雑さを処理するためにピン留めされたバイト配列を使用してメモリを管理しており、ライターが多様なデータ構造に対応できるようにしています。現在のバージョンは基本的なフラットスキーマとSnappyのような主要な圧縮コーデックをサポートしていますが、依然としてシングルスレッドでの実装であり、メモリ制約への対処や、より複雑なネストされたデータ構造への対応は今後の反復開発で予定されています。今回の開発は、Haskellをより実用的でパフォーマンスの高い選択肢として、より広範なデータサイエンスエコシステムにおけるデータ集約的なタスクに活用できるようにするための大きな一歩となります。
HN Digest / · HN #49802510
HaskellデータサイエンスエコシステムのためのParquetファイルライターの実装
DataHaskellプロジェクトは、データフレームライブラリにネイティブなParquetライターを導入しました。これにより、Haskellユーザーは業界標準の列指向フォーマットでデータをシリアライズできるようになり、相互運用性とストレージ効率が向上します。
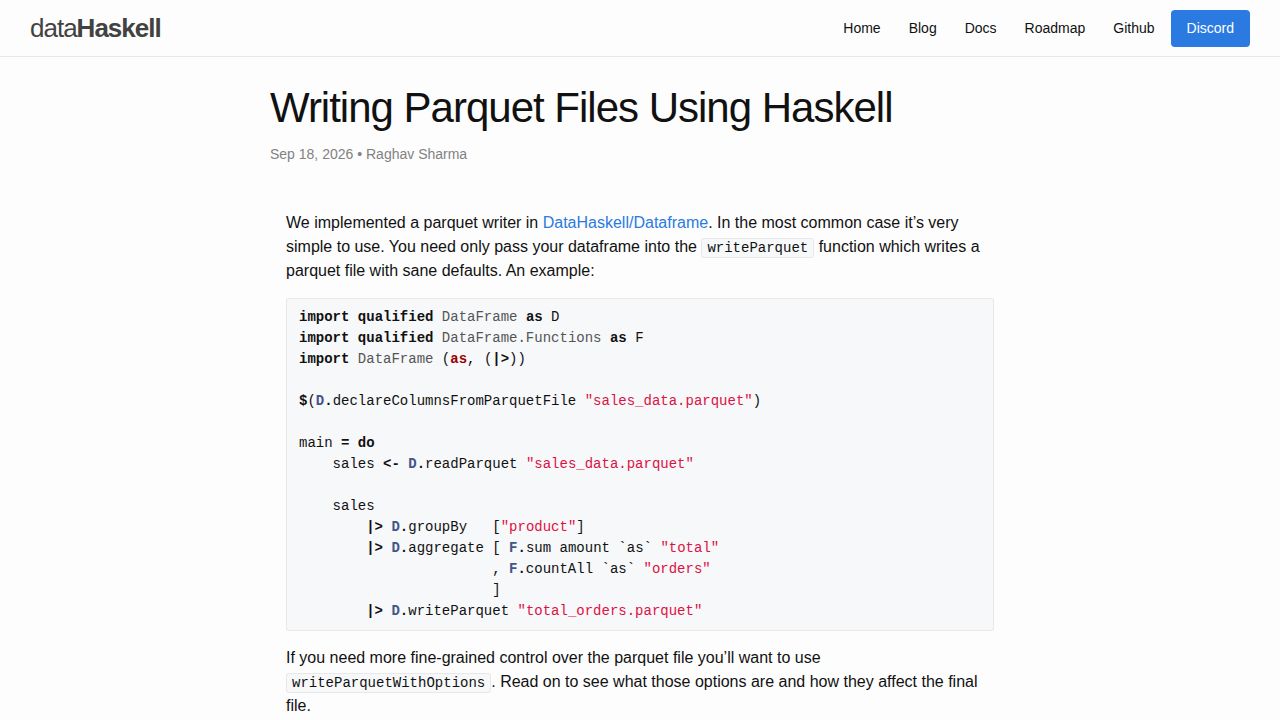
出典ページのスクリーンショット(datahaskell.org)