大規模言語モデル(LLM)を執筆ワークフローに統合するには、生成される文章が自動生成されたものと見分けがつかなくなる事態を防ぐための規律あるアプローチが必要である。最大の懸念は、最先端のモデルが洗練された見出しスタイルのテキストを生成するように最適化されており、それが文章から独自の文体を奪ってしまう可能性があることだ。これを緩和するために、執筆者は「LLMが提案した単語は決して使わない」ことと「モデルによる称賛や励ましの傾向を無効にする」ことという2つの核心的なルールを採用すべきである。これらの予防策により、執筆者は自身の文章の唯一の設計者であり続け、モデルを受動態、名詞化、あるいは単語の繰り返しといった機械的な問題点を指摘させるためだけに利用できる。このプロセスに推奨される枠組みは、LLMを創造的なパートナーではなく、厳格な編集者として扱うことである。執筆者は、モデルに特定の課題を指摘させ、その後に影響を受けた箇所を自身で書き直してそれらの問題に対処するという編集作業を行うことができる。文章改善のための構造的なアプローチを求める人には、Joseph M. Williams著の『Style: Lessons in Clarity and Grace』が、一般的な執筆上の弱点を特定し修正するための基礎的な方法論を提供している。こうした確立された文体の原則とLLMの機械的な効率性を組み合わせることで、著者は校正の退屈な側面を外部委託しつつ、物語の構造やトーンに対する完全な制御を維持することが可能となる。
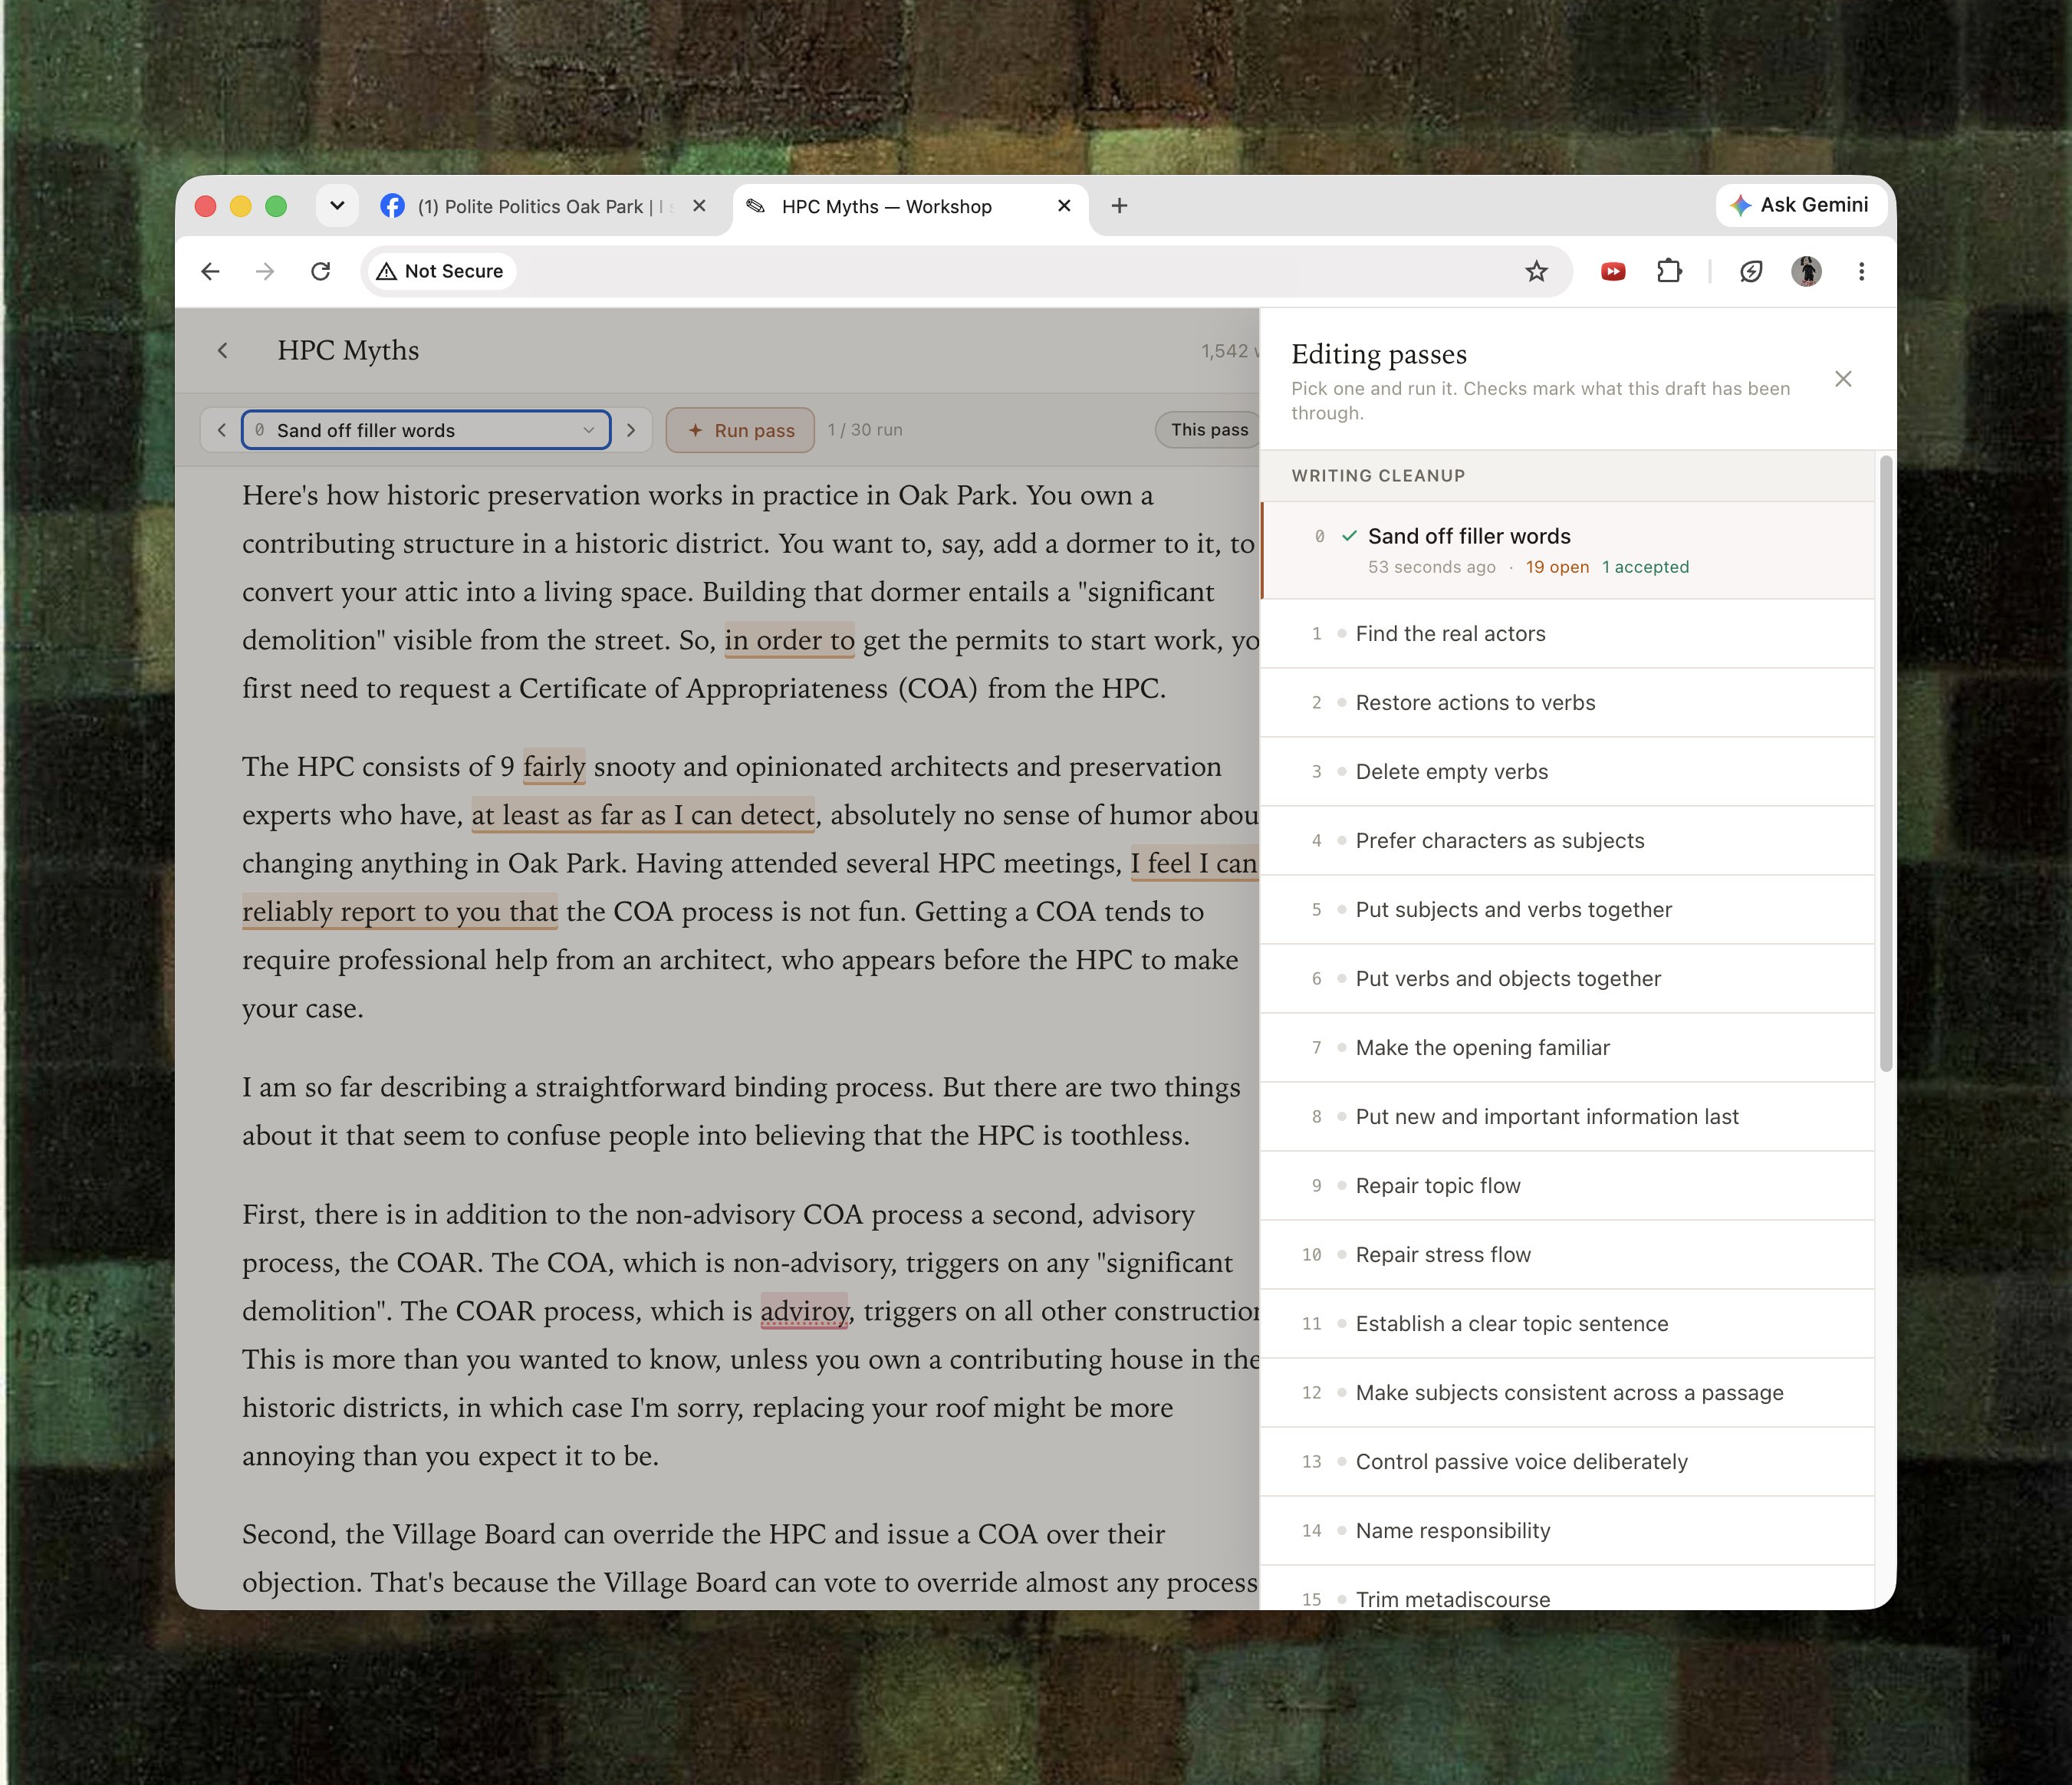
この記事では、LLMに特定の課題を指摘させることで厳格な編集者として扱うことを提案しており、ここではツールが草稿に対して編集作業を行っている様子が示されている。