最近のエッセイは、機械学習による知能が非常に安価になりつつあるため、消費されるトークン数は間もなく、出力品質やアクセス可能性よりも重要ではなくなる可能性があると論じている。トークンはテキストの小単位であり、このエッセイでは1語あたり約1.5トークンとしている。生のトークン価格と完了タスクあたりのコストを区別している。より小さなモデルでも、思考や自己修正により多くのトークンを使う場合があるためだ。
中心的な仕組みは一つの画期的突破ではない。著者は、グラフィックス処理装置(GPU)の効率向上、推論ソフトウェアの改善、そして各リクエストで活性化するパラメータ数を減らすモデル設計を組み合わせて論じている。たとえばエキスパート混合モデルでは、ネットワーク全体をすべて実行するのではなく、選ばれた専門コンポーネントに処理を振り分ける。このエッセイは、過去1年間でトークンコストが約2.5桁低下し、その中にはタスクあたりのコスト効率の約100倍改善、ハードウェアのエネルギー効率の約1.3倍改善、推論エンジンの効率の約1.4倍改善が含まれると推計している。
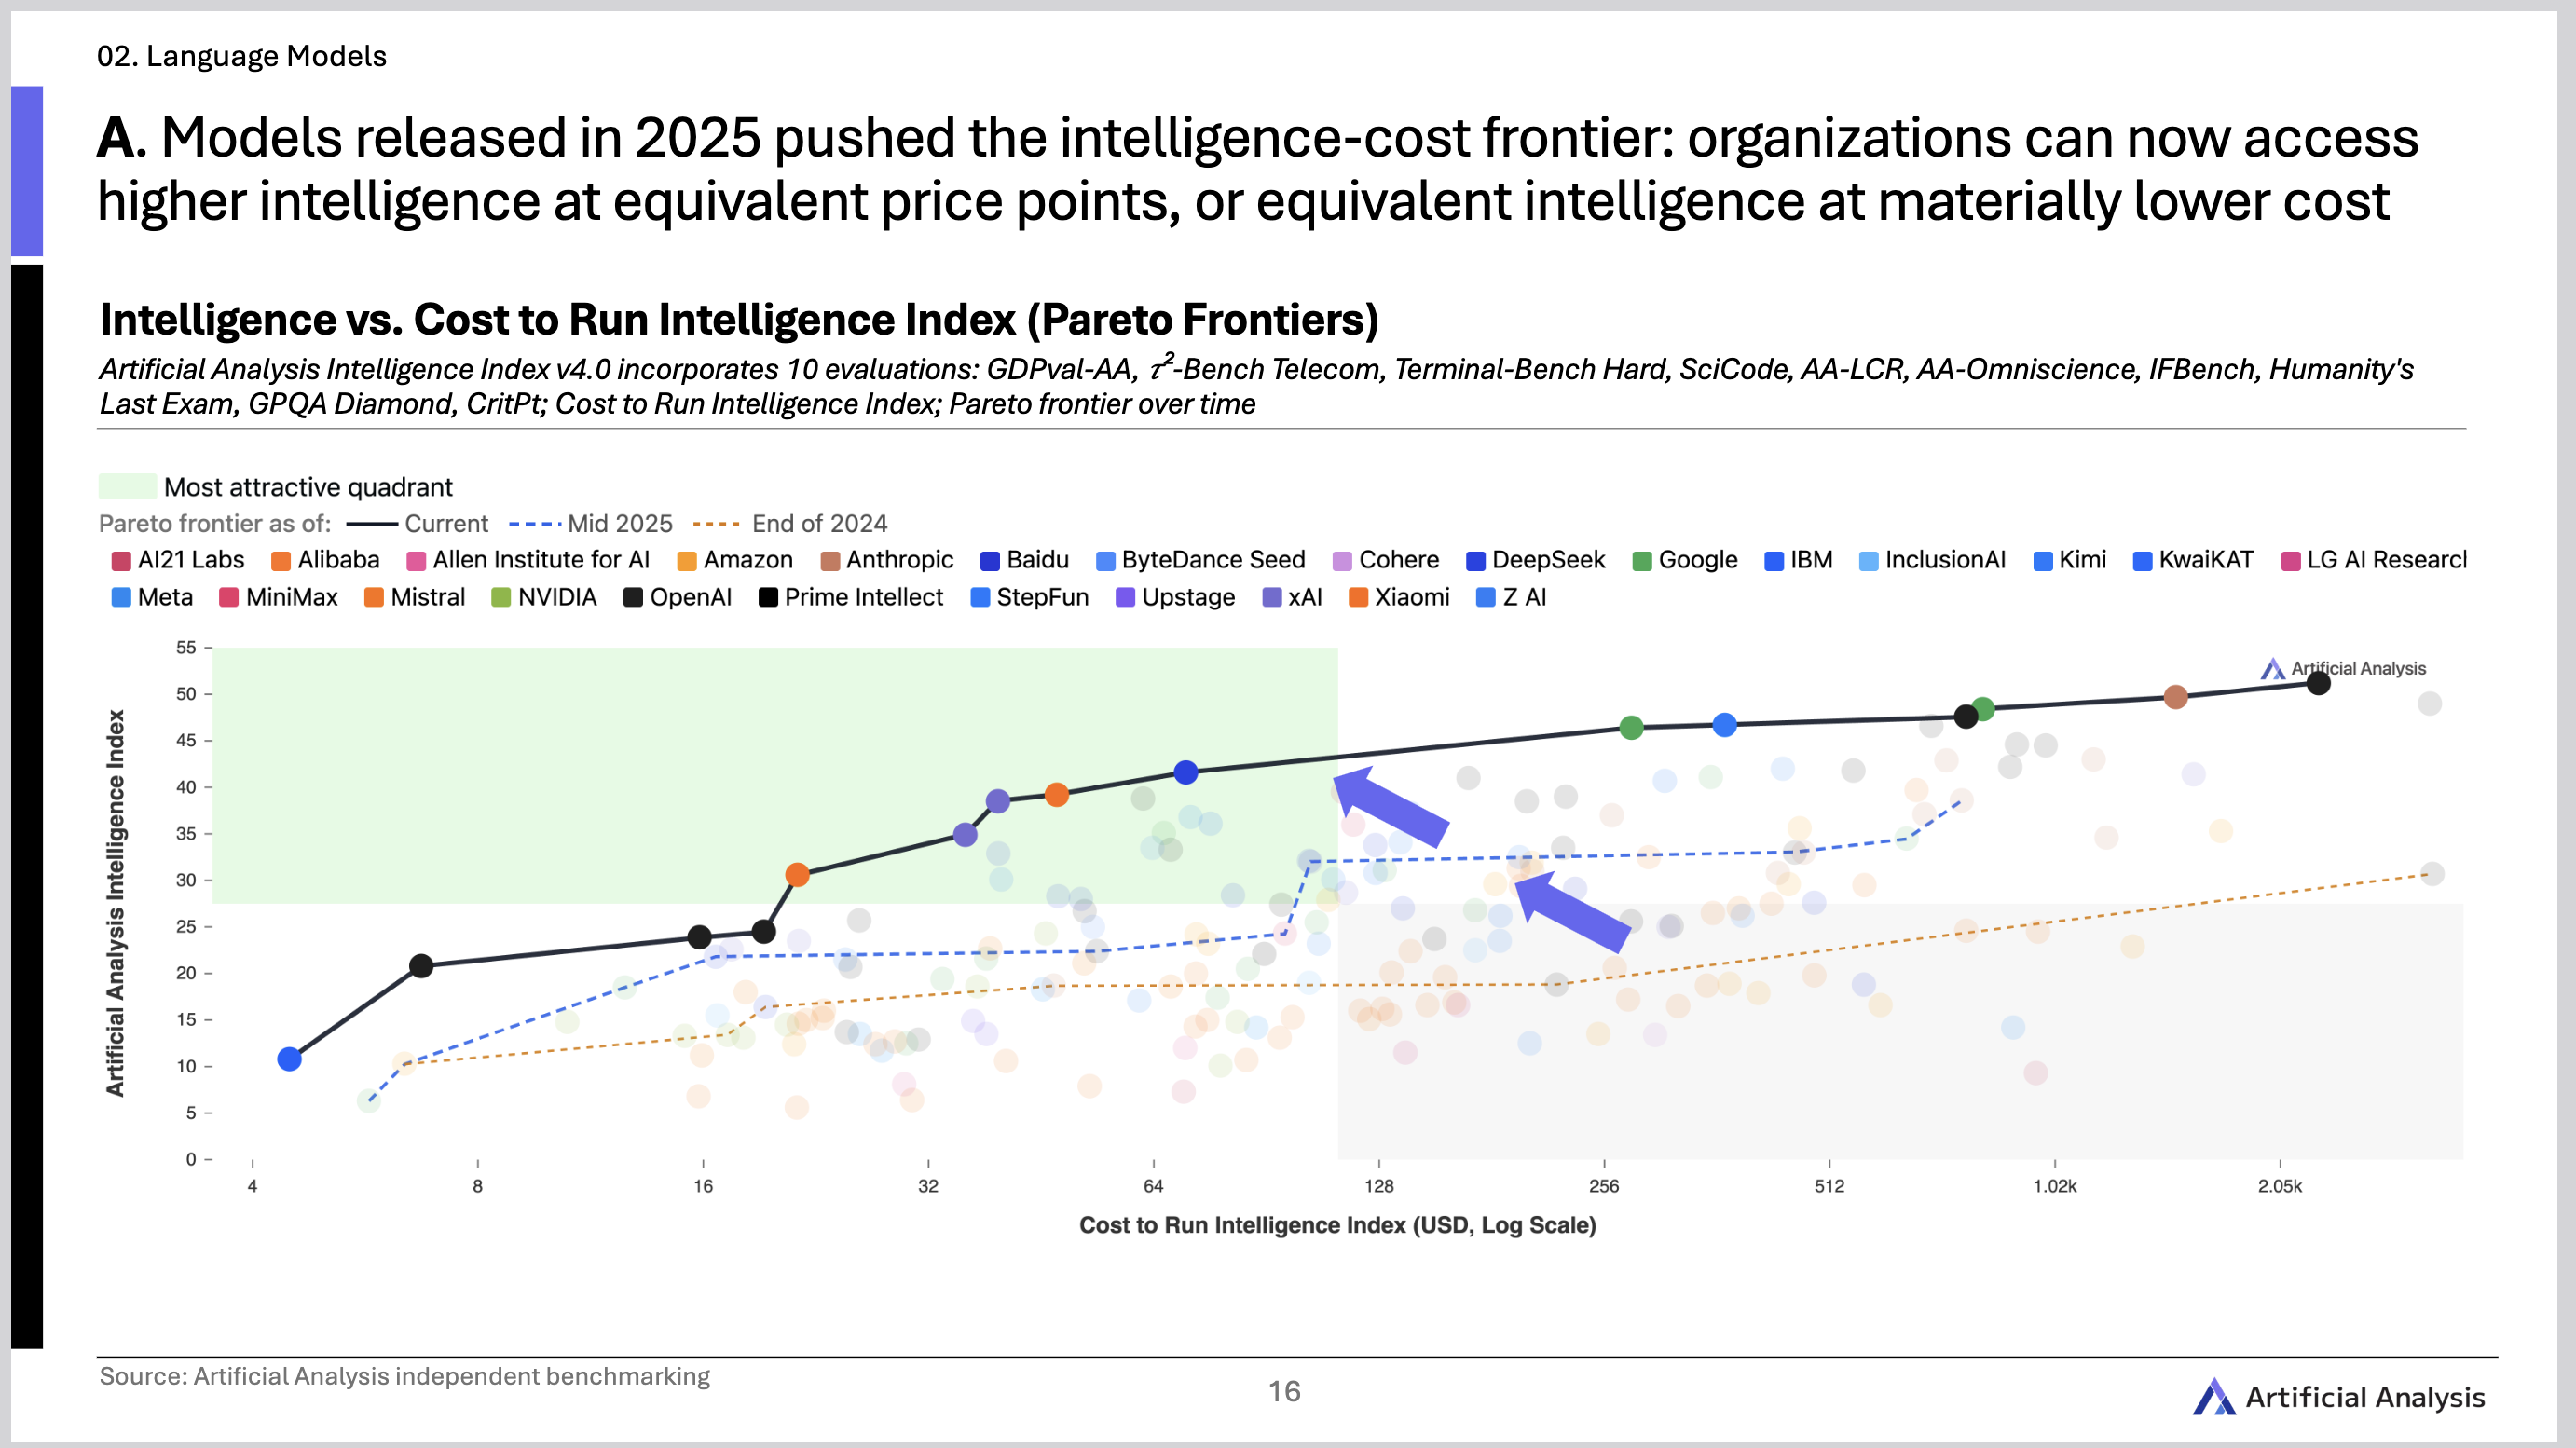
トークンコストの実測による低下と、生のトークン価格から完了タスクあたりのコストへの移行を説明した後に配置。
GPU効率、推論ソフトウェア、モデル設計が推論コストを引き下げる別々の仕組みとして示された後に配置。
提供されたモデルページは、アーキテクチャの変化を示している。Muse Glimmerは300億パラメータのローカルモデルで、公開元は4ビット量子化によって20GB未満に縮小でき、24GBまたは32GBのメモリ範囲内で動作する余地ができるとしている。Qwen3-Coder-30B-A3B-Instructは総パラメータ数が305億だが、各リクエストで33億を活性化し、128個中8個のエキスパートを同時に使用する。ネイティブのコンテキスト長は262,144トークンで、Yarnを使えば100万まで拡張できる。これらは公開元の仕様であり、一般的なユーザー性能を独立して証明するものではない。
推論が十分に安価になれば、このエッセイの主張では、モデルは独立したチャット製品にとどまるのではなく、通常のツールの中へ組み込まれる可能性がある。おおよその比較では、モデルの1ターンにかかるコストは、grep、HTMLの解析、コードのビルドといったコマンドの電力コストより数桁高い。そのため、完全な会話インターフェースでは非効率な場面でも、AIによるフィルタリング、スケジューリング、優先順位付けが実用的になる。ただし、この比較は例示であり、推定トークン数、ローカルな消費電力、電気料金を用いていて、制御されたエンドツーエンドのベンチマークではない。
最大の不確実性は、この傾向が続くかどうかだ。効率改善はハードウェアの限界、ソフトウェアのボトルネック、収穫逓減に直面する可能性があり、コスト低下が計算集約的な用途の増加につながりうる。この資料には、このエッセイの統合予測を検証する独立したコスト調査も含まれていない。根拠が支持するのは、より限定的な結論だ。AIスタックの複数の部分が急速に改善しており、その組み合わせによって、一部のモデル呼び出しは驚くほど安くなる可能性がある。それが単なる消費量の増大ではなく、持続的な経済的価値を生むかどうかは、まだ証明されていない。