Laurentiu Raducuが複雑な主題を学ぶ際に重視する出発点は、多くの人が抱く身近な不満だ。言語モデルが作る説明は明快に聞こえる一方で、実際に検証するには抽象的すぎる場合が多い。彼は別の要約をLLMに求めるのではなく、4段階の手順を提案している。まず、コーディング支援ツールにトピックの基礎を整理させる。次に、別のモデルにその知識基盤の正確性を確認させる。その後、主題を小規模なローポリゴンのシミュレーションとして表現し、最後に成果物を公開して、精査と改訂を受けられる状態にする。この手法は、ChipTycoonを通して示されている。ChipTycoonは、半導体製造を題材にした対話型の解説であり、砂の採取から製造、データセンターへの納品まで、素材がたどる過程を追う。
中心的な考え方は、単にアニメーションのほうが文章より楽しいということではない。シミュレーションを作ると、学習者は状態、遷移、入力、出力を具体的に表現せざるを得なくなる。ChipTycoonでは、台車が製造工程を進み、工程の進行に応じて積み荷が変化する。この仕組みによって、箇条書きでは隠れてしまう欠落した工程や不明確な関係が浮かび上がる可能性がある。また、学習者が具体的に検討できる対象も生まれる。ある工程を表現できない場合、その背後にある説明の修正が必要かもしれない。Raducuが指摘する実用上の利点はここにある。ただし、この手法が文章を読んだり従来の方法で学んだりする場合より記憶保持を向上させることを示す実験結果は、記事には示されていない。
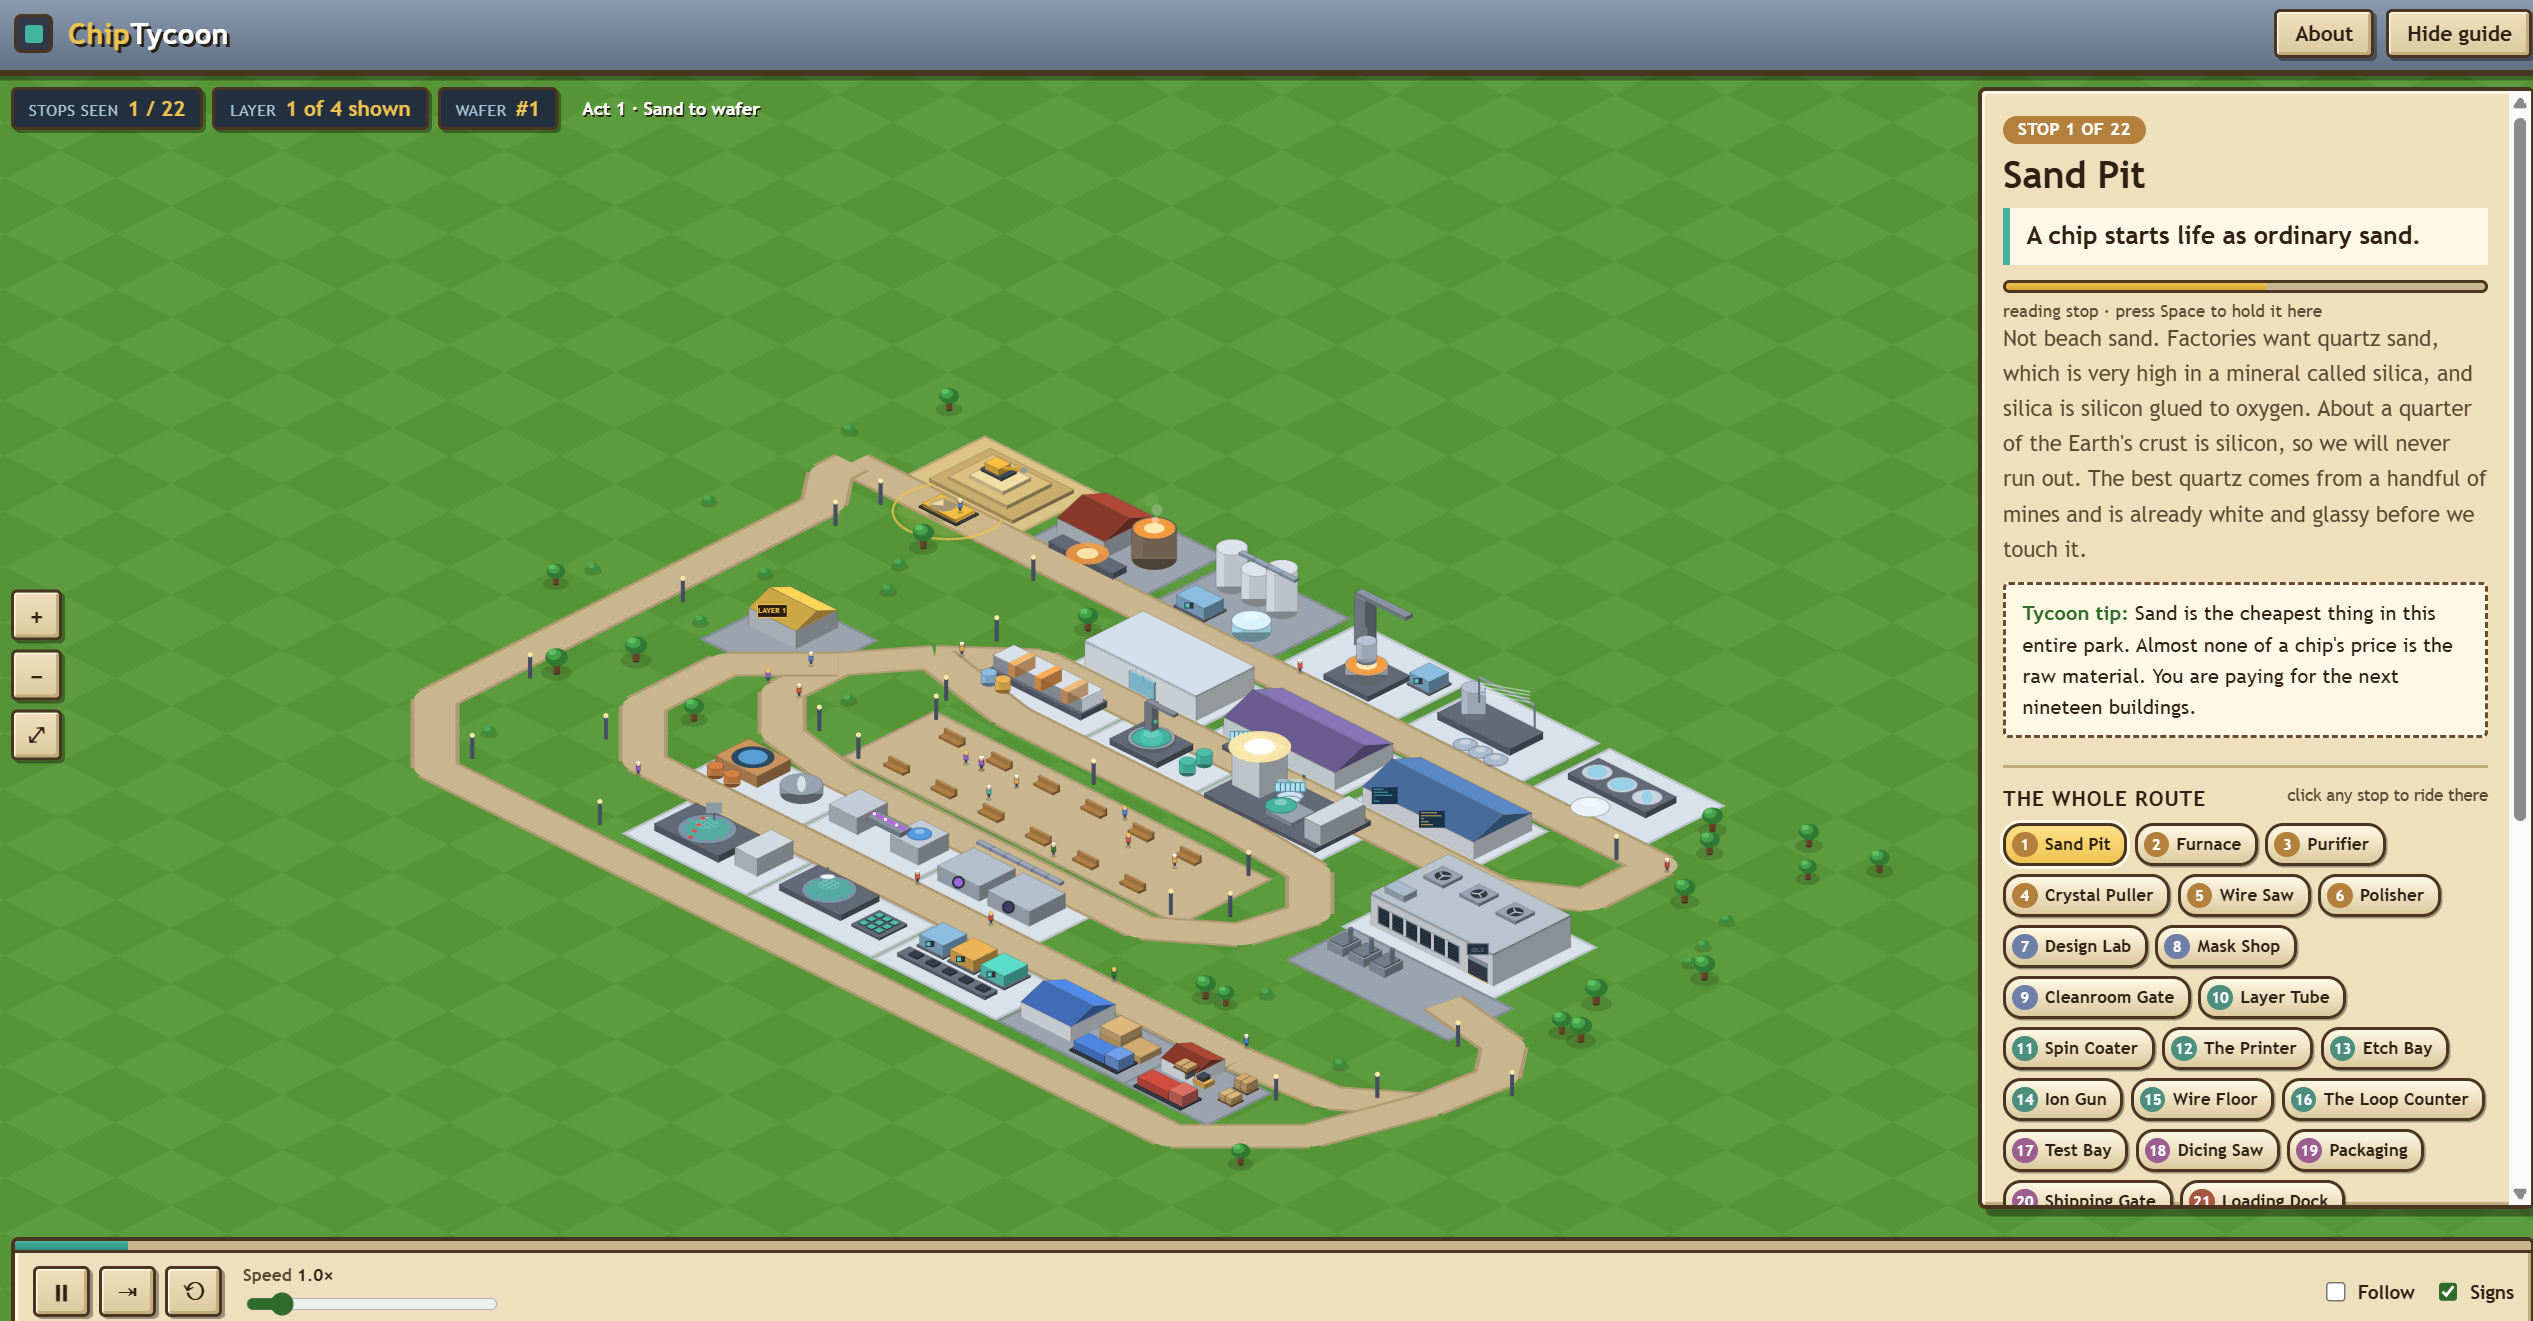
この出典画像は、台車の積み荷が変化することで製造工程を見えるようにし、検証可能なものにしているという記事の説明を直接裏付けている。 出典・クレジット:laurentiugabriel.github.io。
この作業手順で特に重要なのが、2番目の段階だ。Raducuは、視覚的な表現を作る前に、モデルが作成した知識基盤をモデル自身に確認させる。原理的には、これによって事実確認と情報提示を分離でき、誤りを特定しやすくなる。しかし、記事が述べるように、その結果を「100%正確」にできるわけではない。モデルが自分の出力を再確認しても、同じ誤った前提を繰り返したり、関連する情報源を見落としたり、過度な単純化を許容できると判断したりする可能性がある。したがって、正確性は基礎となる参照資料の質と、人間がシミュレーションの主張を独立した資料と照合しているかどうかに左右される。
GitHubリポジトリ`learnscape`には、同じ考え方をより厳密に実装した例が示されている。READMEでは、車両が実際の状態を運び、各停留所でシミュレーションの実際の処理が1つ実行されるアイソメトリック形式の説明コンテンツが紹介されている。このリポジトリは、数値を「計算済み」「縮尺適用済み」「推定済み」「説明のため意図的に偽装済み」のいずれかとして明示する「忠実度台帳」の作成も求めている。この区別は重要だ。完成度の高い視覚表現は、モデルが実際には持っていない精度を暗示してしまうことがある。学習者は、解説が何を主張しているかだけでなく、どの部分が測定され、どの部分が概算され、どの部分が理解を助けるために創作されたかを確認できる。
`learnscape`には、具体的なエンジニアリング上の検証方法も記載されている。JavaScriptの構文検証と、8か所すべての停留所および3回のリクエストからなる完全な処理を対象とするheadless Chromiumのスモークテストだ。これらの検証は、提供されたPacketPostの例が説明どおりに動作することを確認する。しかし、この手法で将来作られるあらゆる主題の教育効果を立証するものではない。検証済みの範囲は、普遍的な保証よりも狭い。コピー操作を利用するインストール方法はテスト済みだが、エンドツーエンドのプラグインインストールは未検証だと明記されている。これは、正常に動作する実演と、今後のすべての利用方法に関する主張を区別する必要があることを示す有用な例だ。
Raducuが別に公開しているGitHubリポジトリ`unreal-game-assets-creation-skill`には、プロンプトや写真を質感付き3D資産へ変換し、シミュレーションを補強する別の方法が示されている。READMEでは、Fooocus、Hunyuan3D-2、Blenderを使用し、必要に応じてUnreal Engineも利用する処理手順が紹介されている。また、実用上の制約も報告されている。RTX 4070搭載のWindowsノートパソコンで、GPUのVRAMが8GBの環境では、画像生成サービスと3D生成サービスを同時に実行するとメモリ負荷が高まり、生成が大幅に遅くなった。そのため、このスキルでは次のサービスを開始する前に、一方のサービスを停止する。これは、このリポジトリに記載された環境に関する証拠であり、すべてのハードウェアやAI生成ツールに適用できる一般的な性能評価ではない。
この手法の導入を検討する読者にとって、最も根拠を示しやすい教訓は手順に関するものだ。まずLLMにトピックマップの下書きを作成させ、その地図に疑問を投げかける。次に、動作を観察できる小規模なモデルを実装し、前提条件を明示的に記録し続ける。基礎となるプロセスを十分に表現でき、その上で問いやパズルを支えられるようになってから、それらを追加する。視覚的な表現はモデルを明確にするべきであり、不確実性を隠してはならない。したがって、この作業手順を最も適切に表す言葉は「アニメーションを信頼する」ではなく、「主張を実行可能な形にし、実行結果が証拠と食い違う場所を精査する」である。
資料一式には、主要記事の日付が2026年8月9日であると記載されており、これはページに示された公開日と一致する。個人の有用性と正確性に関する記事の主張は、あくまで著者自身の記述である。提供された各リポジトリは、関連ツールと資料が実際に存在することを裏付け、シミュレーションの構造、忠実度の表示、検証方法、ローカルGPU環境の制約についての詳細を追加している。一方、比較できる学習成果を実証したり、ChipTycoonに誤った生成が含まれていないことを証明したり、LLMが生成したあらゆる解説が信頼できると示したりするものではない。読者にとって、この手法は探究を整理する方法として有望である。ただし、その教育的価値は、学習者の目標、利用する資料、誤りを発見する能力との関係で、引き続き検証されなければならない。