UTF-8は、Unicode文字を1バイトから4バイトで表現する広く利用されている文字エンコーディングです。UTF-8の当初の設計では最大6バイトのシーケンスをサポートしていましたが、2003年にUTF-16の制約と整合させるために4バイトに制限されました。UTF-8000は、この制限を取り払い、無制限の数のコードポイントに対応するために任意の長さのコードユニットを許容しようとする実験的な提案です。UTF-8000の核心的なメカニズムは、最初のバイトの最上位ビットを自己同期ビットと開始ビットに分割することにあります。コードユニットが1バイトの容量を超える場合、開始ビットは後続の継続バイトに分散(ストライプ)されます。このアプローチは標準的なUTF-8のプレフィックスフリー特性を維持しており、開始ビットを読み取ることでコードユニットの長さを決定できることを保証しています。この手法を用いることで、UTF-8000はコードユニット間の補助的な句読点を必要とせず、元の標準が持つ自己同期および自己句読点の特性を保持しています。この仕様は、ASCII互換性に関する既存のルールを維持し、セキュリティ上の脆弱性(strcpyのようなC言語関数によってnullバイトが不適切に処理された場合に生じうるものなど)を防ぐため、必要以上に多くのバイトを使用して文字を表現する過長エンコーディングを禁止しています。技術的な設計にもかかわらず、この提案は実用上の課題に直面しています。任意の長さのコードユニットのサポートを実装することは、ソフトウェアが入力サイズに対して厳格な制限を強制しない場合、バッファオーバーフローの脆弱性といった潜在的なリスクをもたらします。さらに、この標準では長さを決定するために開始ビットを読み取る必要があるため、極端に長いシーケンスは、現在の標準が持つ固定長の制限と比較して、解析やメモリ管理を複雑にする可能性があります。
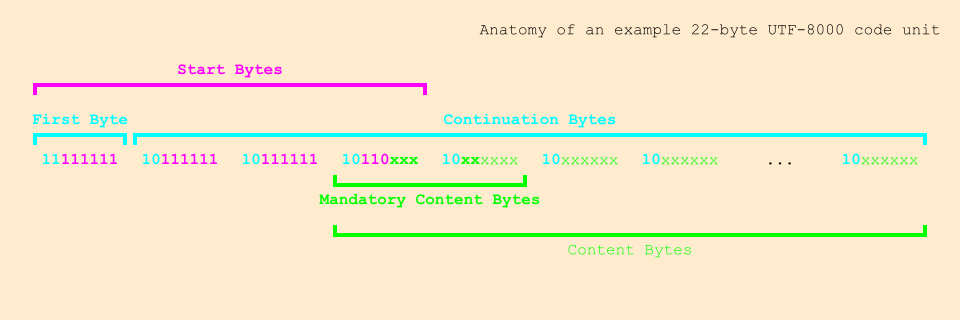
この記事では、UTF-8000がプレフィックスフリー特性を維持するためにどのようにビットをバイト間で分割するかを説明しており、この解剖図によって視覚的に明確化されています。
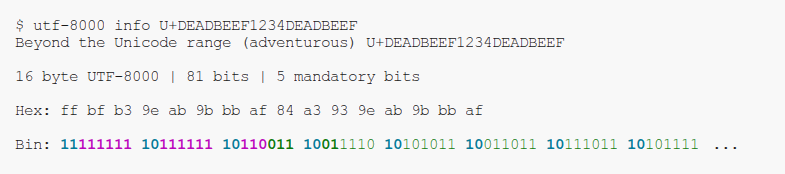
この情報グラフィックは、提案で議論されているエンコーディングメカニズムの具体的な例を提供し、理論上の無制限の範囲を視覚化するのに役立ちます。