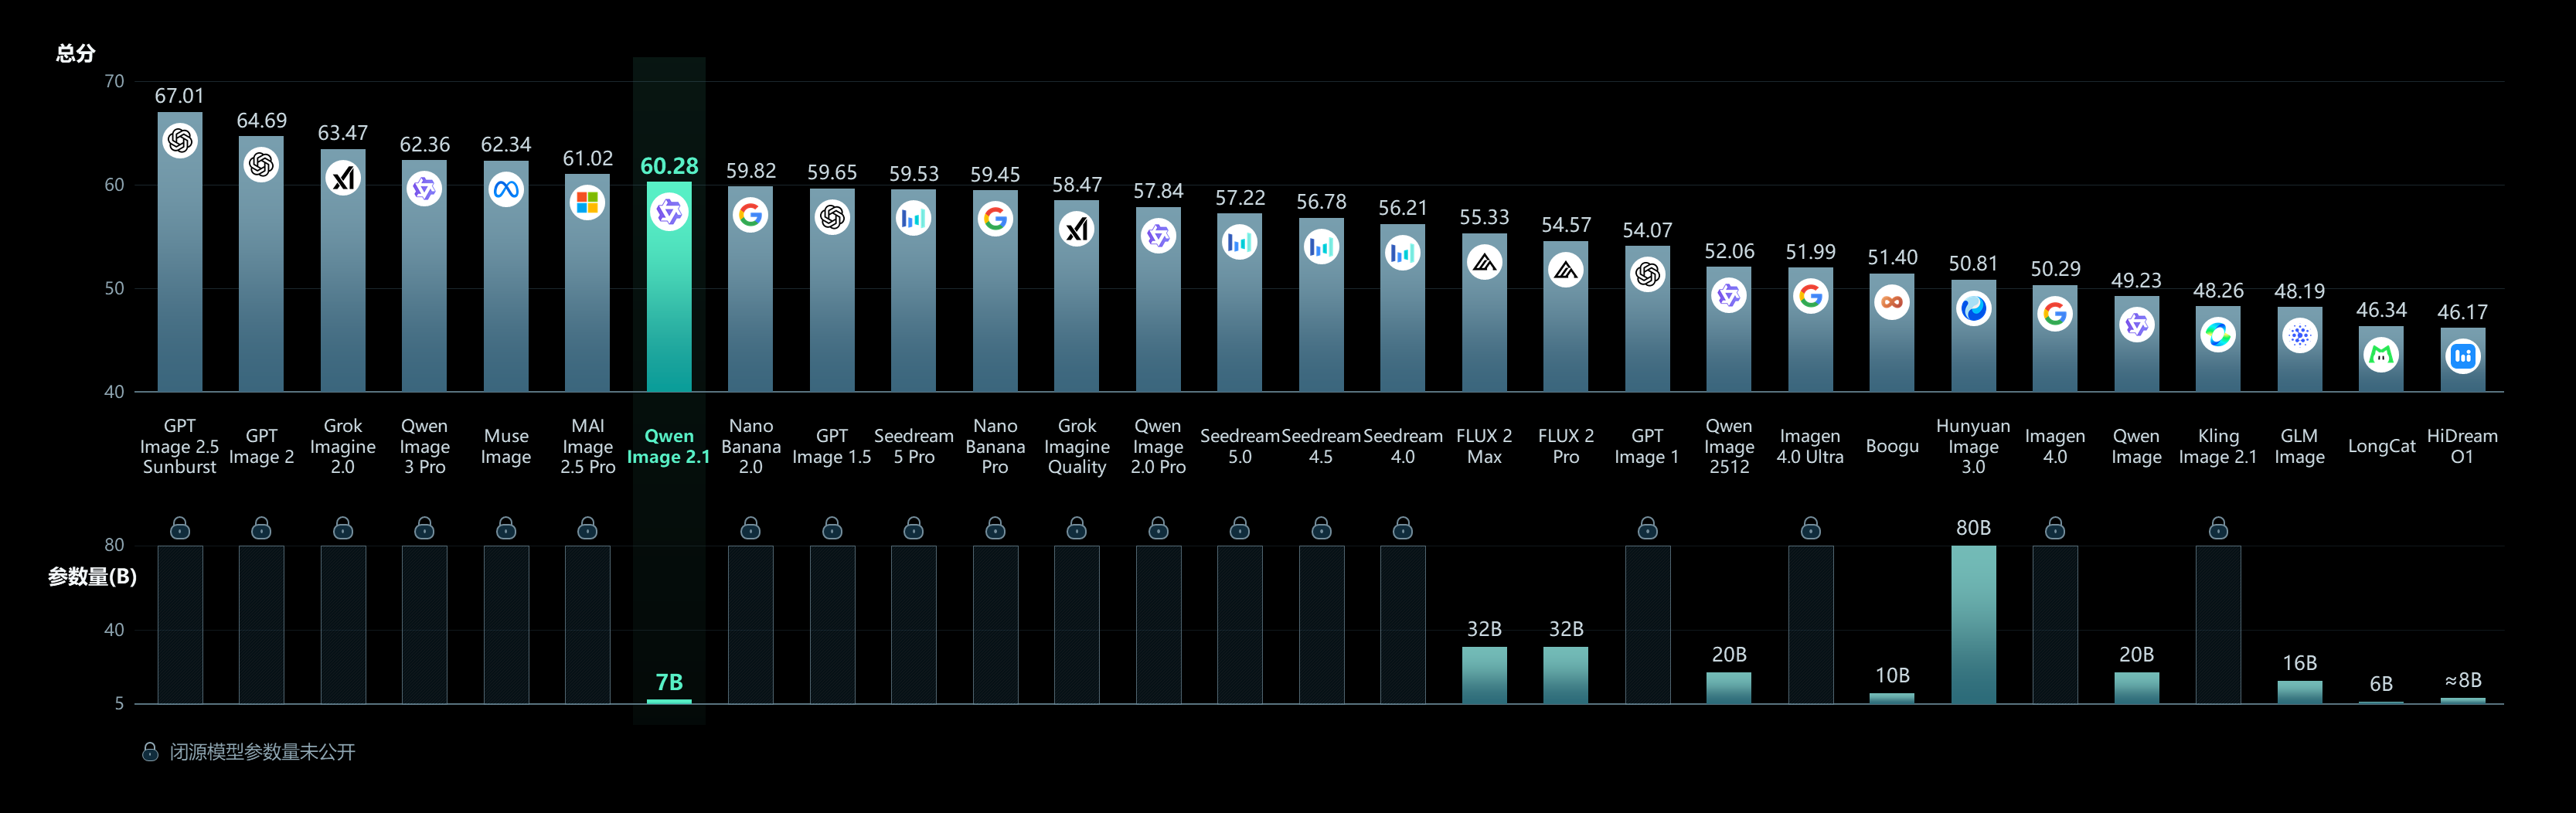
Qwen anunció Image 2.1 el 20 de septiembre de 2026. El lanzamiento se presenta como un modelo unificado para generar imágenes a partir de texto y editar imágenes, en lugar de dos sistemas independientes. Su repositorio oficial describe el componente de generación visual como un modelo de 7.000 millones de parámetros construido con 32 capas Single-Stream Diffusion Transformer, o DiT. Esta cifra se refiere al núcleo de generación de imágenes y debe distinguirse del codificador de texto separado que forma parte de la canalización completa.
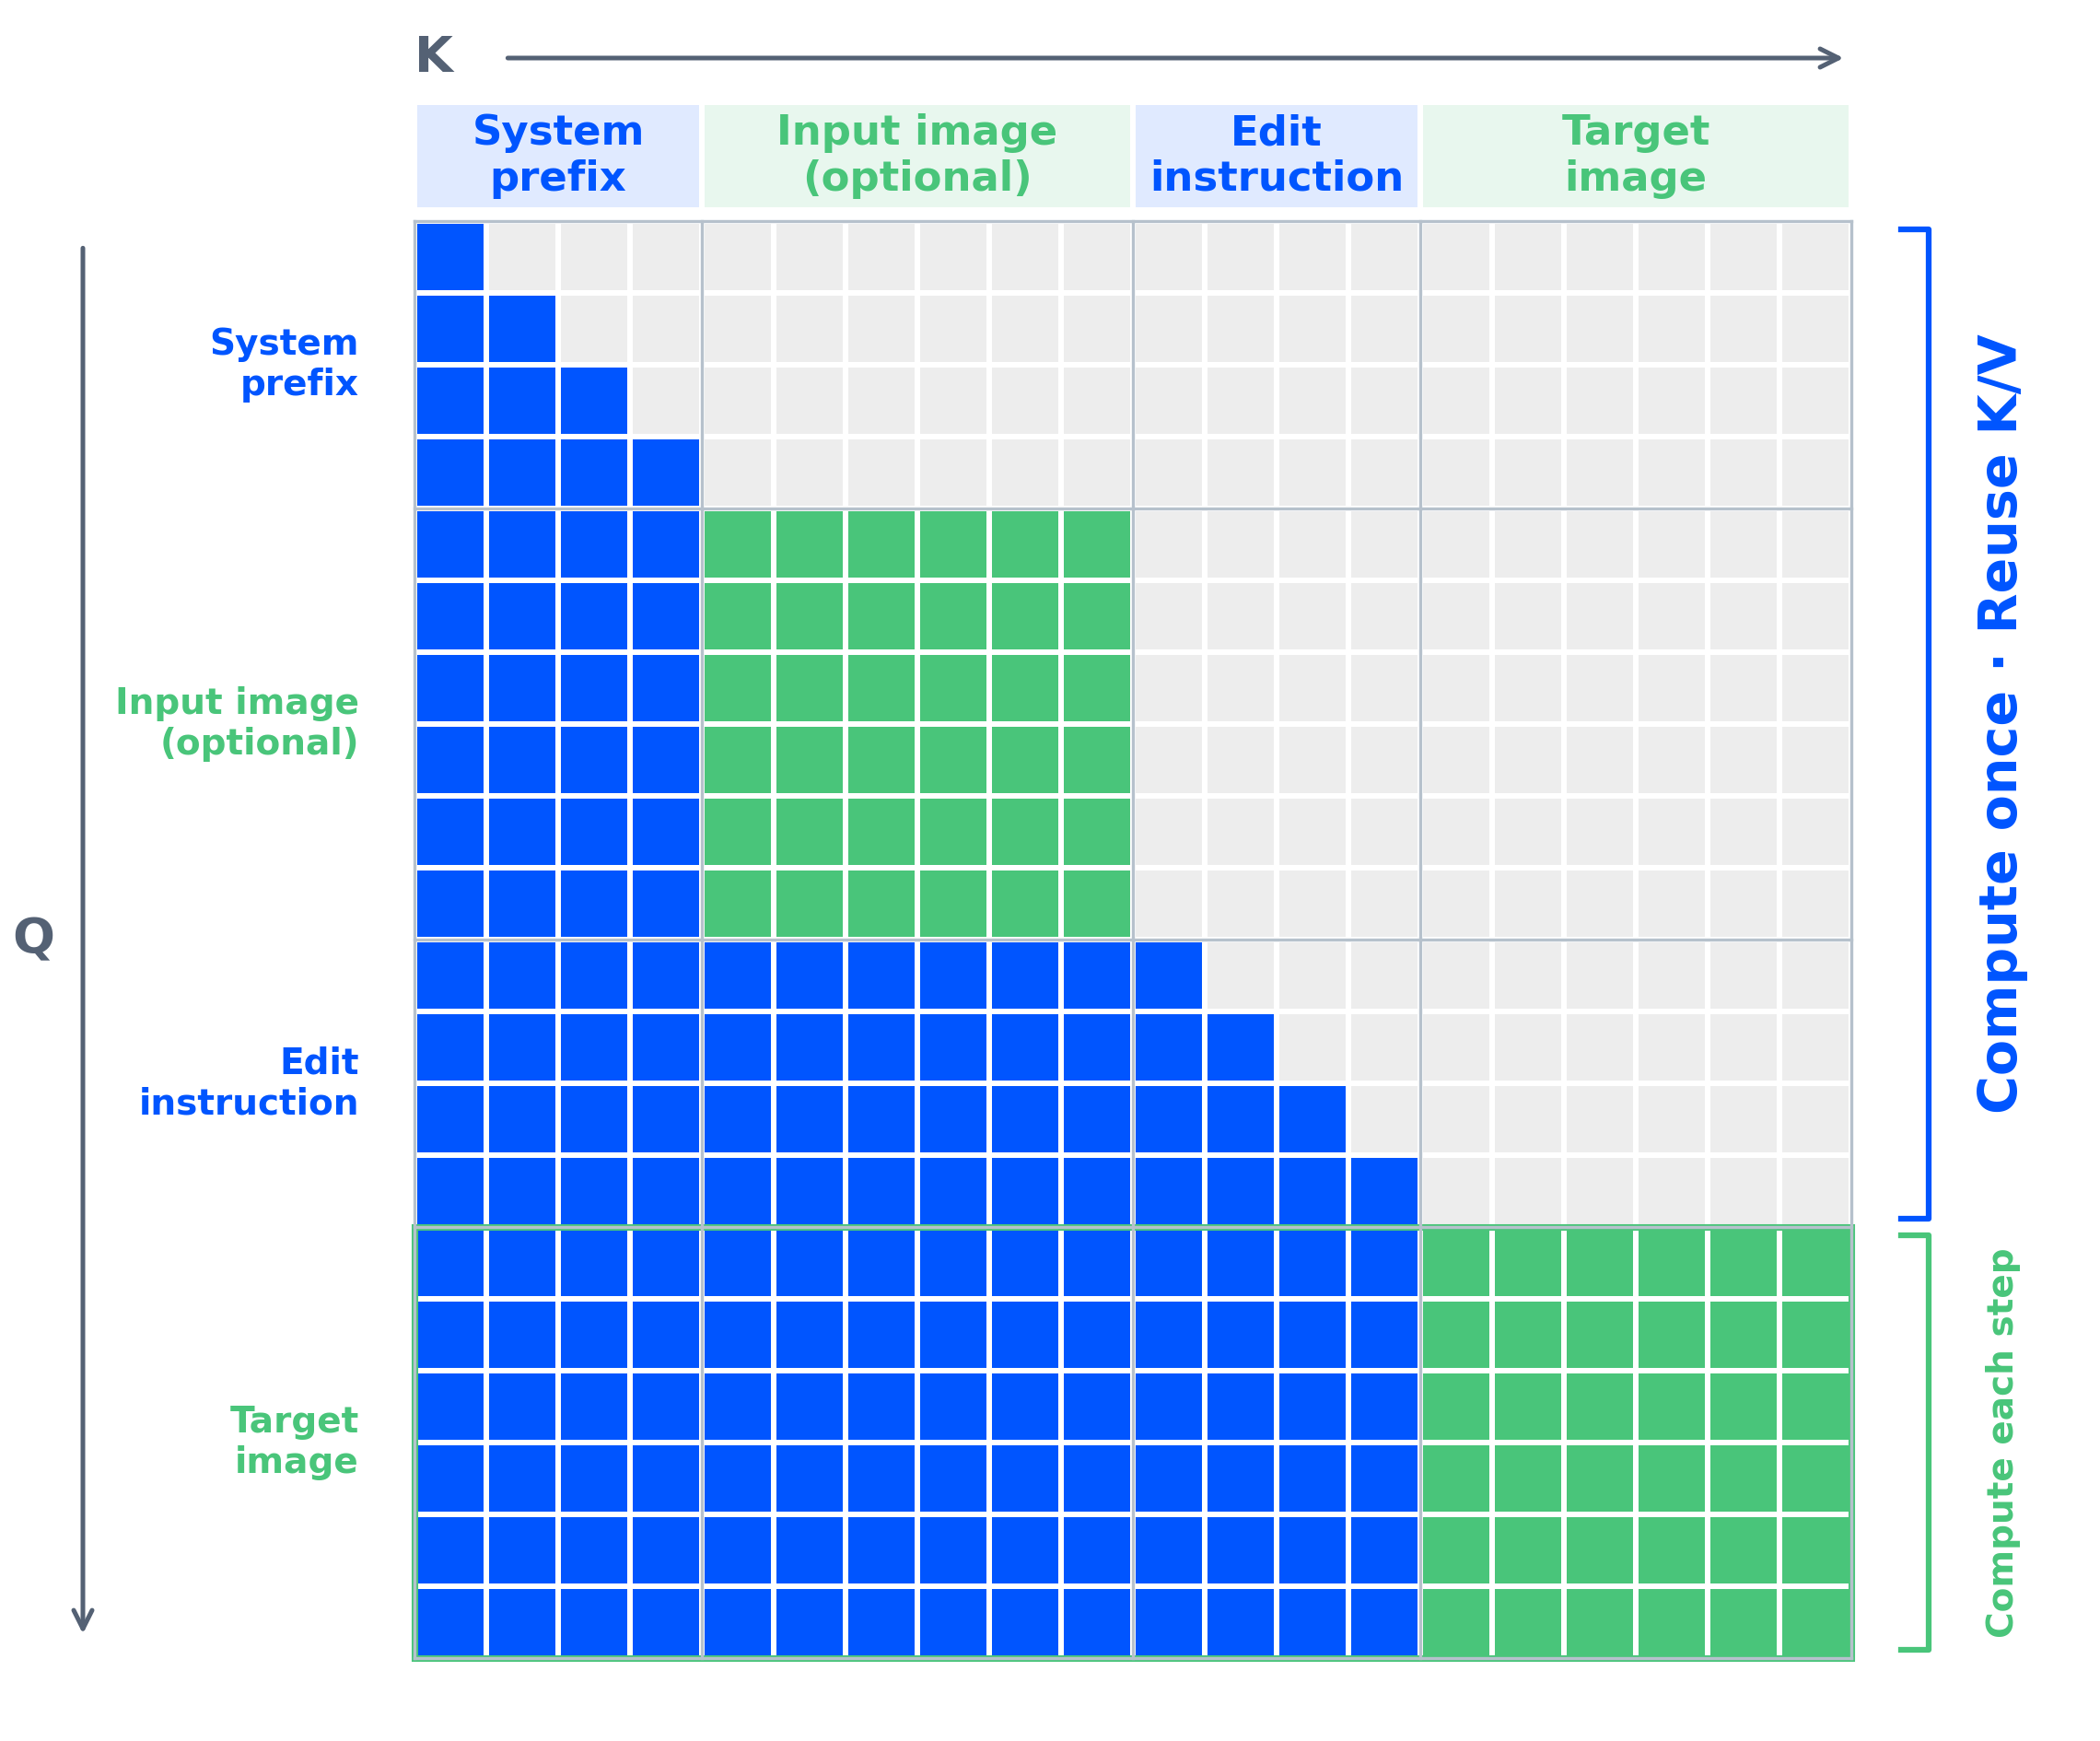
La arquitectura se basa en atención de granularidad mixta y reutilización de la caché prefix key-value. Según la descripción de Qwen, los prefijos de texto y de las imágenes de condición pueden calcularse una vez y reutilizarse durante los pasos de eliminación de ruido. El objetivo es reducir el cálculo repetido sin separar la generación y la edición en modelos distintos. Conviene tratar esta afirmación como una descripción de diseño del proyecto, no como una medición independiente: la eficiencia real dependerá de la GPU, la precisión, el backend y las condiciones de entrada.
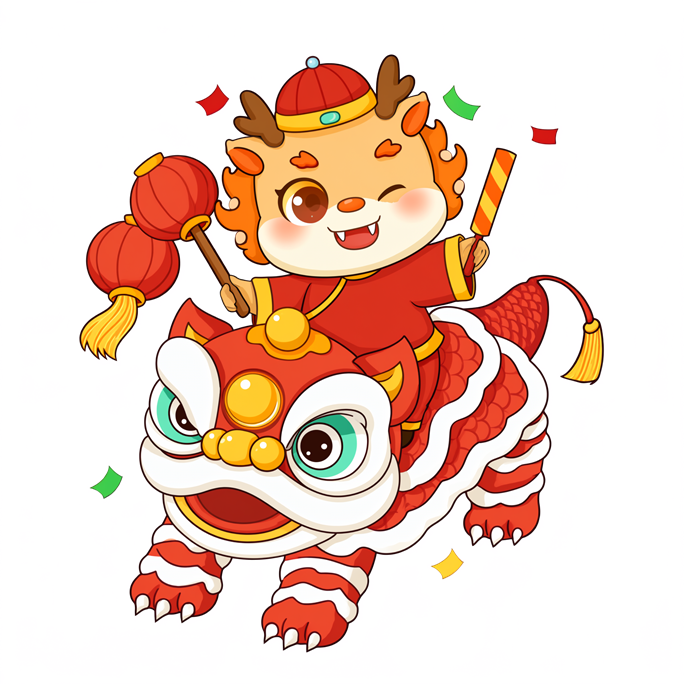
Una de las novedades más concretas es la transparencia nativa. Image 2.1 puede generar imágenes normales y también imágenes RGBA con canal alfa. El mismo modelo puede editar capas transparentes y extraer sujetos de fotografías. El repositorio incluye un patrón de prompt para solicitar un fondo transparente y un ejemplo que guarda el resultado como imagen RGBA. Esto interesa a flujos de trabajo de recorte, pegatinas, composición e imágenes de producto que quieran manejar la transparencia sin depender siempre de un modelo posterior independiente.
El tablero transparente y el recorte muestran la capacidad RGBA nativa descrita en el párrafo anterior, no un paso separado de eliminación del fondo.
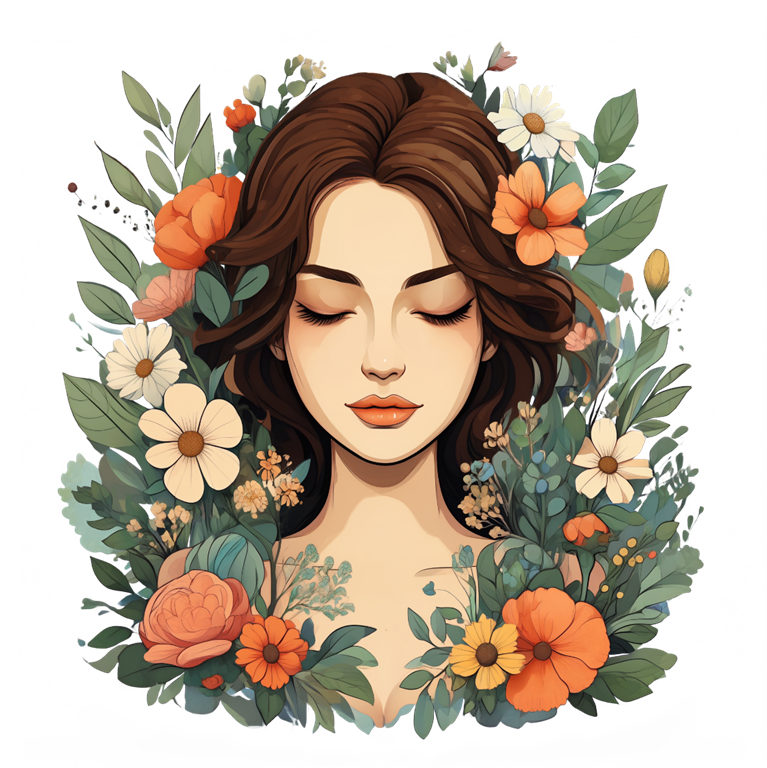
La ruta de edición también acepta varias imágenes de referencia. La documentación oficial indica que una composición con múltiples sujetos puede utilizar hasta 10 referencias. Los cambios locales pueden indicarse mediante círculos, anotaciones pintadas o máscaras separadas, y el proyecto propone conservar la identidad de personas y productos. Esa conservación es un objetivo del sistema, no una garantía de que cada rostro, prenda o detalle sobreviva intacto en cualquier caso. El resultado depende del prompt, de las referencias, del método de edición y de la calidad de las imágenes de entrada.
La edición visible muestra cómo una instrucción local puede cambiar parte de una imagen existente, el flujo de edición tratado arriba.
Qwen también destaca una tipografía mejorada, una iluminación más cuidada en retratos y más detalle fino. El modelo admite de forma nativa la generación en 2K y enumera relaciones de aspecto recomendadas como cuadrada, 4:3, 3:4, 3:2, 2:3, 16:9 y 9:16. Son capacidades y configuraciones recomendadas, no una promesa de que todo texto sea legible o de que no aparezcan artefactos. Las muestras publicadas muestran el uso previsto; la legibilidad real debe comprobarse en el idioma, el estilo tipográfico y la resolución concretos.
Los sujetos combinados muestran la composición con múltiples referencias descrita en el párrafo anterior; es una demostración, no una garantía de calidad.
La pila técnica es más amplia que el DiT de 7.000 millones de parámetros. El codificador de texto es Qwen3-VL 8B, que convierte instrucciones de texto e imágenes de condición en una representación compartida. El VAE es un autoencoder RGBA de 64 canales con compresión espacial de 16 veces y admite transparencia nativa. El planificador utiliza Flow Matching con programación discreta de Euler y desplazamiento dinámico. En conjunto, estos componentes explican cómo el sistema recibe texto e imágenes como condiciones y produce resultados RGB o RGBA, pero no determinan por sí solos la calidad de una salida concreta.
Para quienes quieran convertir indicaciones breves en descripciones detalladas, el proyecto ofrece dos modelos Qwen3.5-VL 9B ajustados para reescribir prompts: uno para generación de texto a imagen y otro para edición. El código suministrado puede ejecutarse localmente con Transformers o mediante un servidor vLLM, y la salida incluye un prompt ampliado y una elección de relación de aspecto. Es una parte opcional del flujo: se puede llamar directamente a la canalización de imagen, mientras que la reescritura resulta útil cuando una instrucción corta no contiene suficientes detalles.
El lanzamiento también incluyó varias vías de integración. El README oficial dice que Diffusers admite el modelo desde el primer día mediante QwenImage21Pipeline. También menciona soporte nativo inicial en ComfyUI, inferencia de alto rendimiento con vLLM-Omni, inferencia nativa con SGLang-Diffusion y aceleración mediante LightX2V. Los pesos del modelo están enlazados desde Hugging Face y ModelScope. Estas conexiones facilitan una primera prueba con herramientas conocidas, pero las dependencias, la memoria de la GPU, las versiones de software y la compatibilidad del sistema operativo siguen siendo condiciones prácticas que hay que comprobar.
Los ejemplos de inicio rápido usan PyTorch, Transformers, Diffusers, Accelerate y Pillow, y muestran una canalización orientada a CUDA. El repositorio también describe descarga de partes del modelo a la CPU, inferencia fuera de línea con vLLM, servicio en línea, comandos de SGLang y adaptación a varios aceleradores mediante FlagOS. La variedad de opciones es valiosa para experimentar localmente, pero no significa que todas las combinaciones funcionen a la misma velocidad ni que quepan en cada GPU de consumo. Antes de empezar hay que revisar los requisitos de memoria, la precisión y las opciones de descarga del backend elegido.
La licencia es una parte esencial del lanzamiento. El repositorio se rige por el Qwen Research License Agreement, que define el uso no comercial como investigación o evaluación. La licencia concede un permiso limitado, no exclusivo, no transferible y sin regalías para fines no comerciales; para un uso comercial se necesita una licencia comercial separada. La redistribución exige avisos y atribución, y los modelos creados o mejorados con estos materiales tienen requisitos adicionales de identificación. Quien piense en un producto, un servicio de pago o un despliegue comercial no debe inferir permiso a partir de que los pesos sean públicos: debe leer el acuerdo completo y obtener la autorización necesaria.
La importancia de Image 2.1 tiene dos dimensiones. En lo técnico, combina un componente de generación relativamente compacto de 7.000 millones de parámetros con edición, transparencia, composición a partir de varias referencias, salida 2K y un ecosistema documentado de herramientas de inferencia. En lo práctico, su utilidad dependerá del backend, del hardware disponible, de la calidad del prompt y de las referencias, y de que el uso previsto encaje con la licencia. El lanzamiento ofrece un conjunto considerable de capacidades para probar, al tiempo que deja clara la frontera entre experimentación y despliegue comercial.