José Daniel Fernández Santos 发布了一本书,挑战了现代人的假设,即理解人工智能需要超级计算机。通过迫使学习者在 8 位 Z80 处理器(经典机器如 ZX Spectrum 的核心)上编写人工智能基础,该项目旨在将“黑盒”概念转化为切实的、逐字节的指令。
从符号逻辑到数据模型
教育旅程从符号人工智能开始,在这种模式下,知识与推理机制分离。这包括构建用于诊断的专家系统,以及基于 ELIZA 的对话模拟器,以探索基于模式的对话。
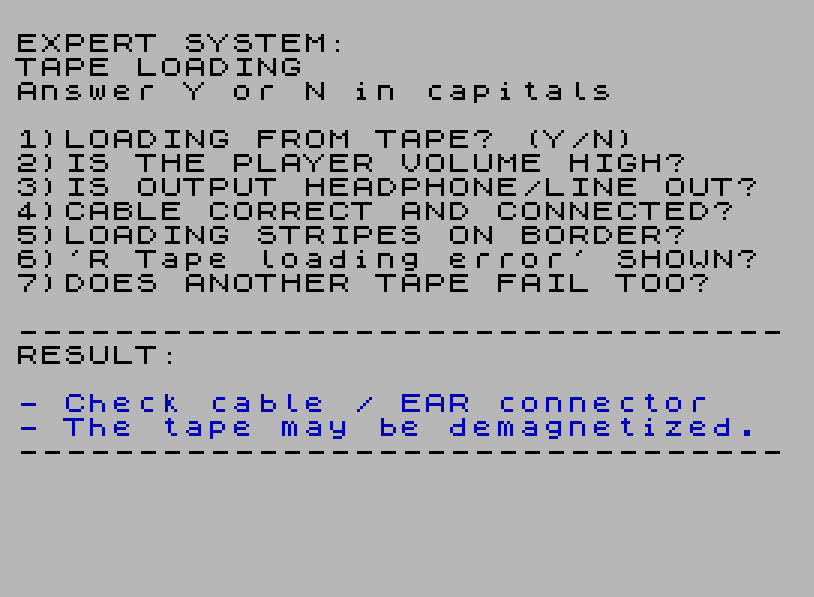
这张图片展示了构建专家系统以执行特定诊断任务的符号人工智能方法。
HN Digest 根据 amazon.es 报告的数据绘制的图表;数值按来源原文显示。
重点随后从规则转向数据。读者使用真实的 CO2 测量值实现线性回归,并使用 k-NN(k-最近邻)和 Naive Bayes 等监督分类模型对数据点进行分类。
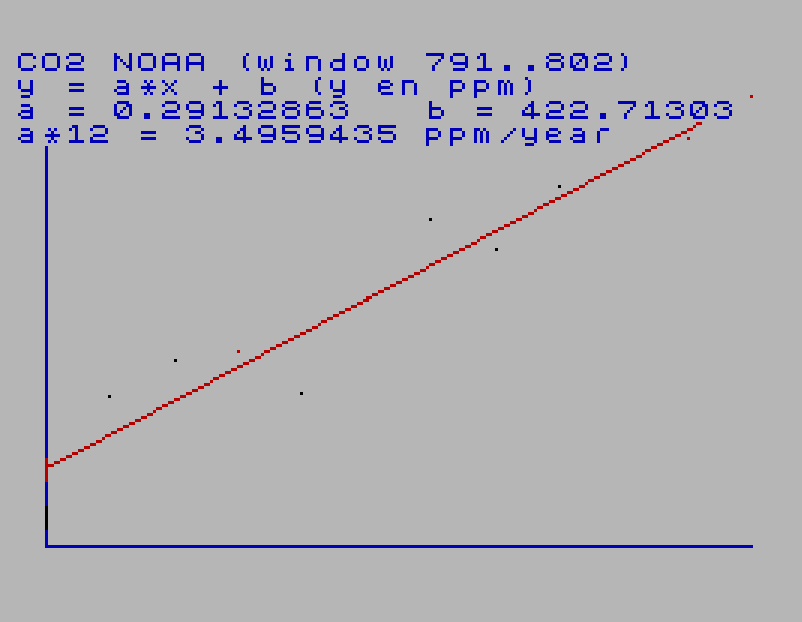
本书通过在 8 位硬件上实现线性回归来展示从规则到数据的转变。
通过这些不同范式的转换,本书阐述了人工智能是如何从硬编码逻辑演变为基于概率和接近度的决策过程的。
“通过在 BASIC 中从零开始编写程序来理解人工智能。”
— Artificial Intelligence for the Z80 | dfsantos.com
8 位硬件上的神经网络
作品的很大一部分致力于神经网络的机制。读者构建一个感知器——一种结合输入和权重的人工神经元——来区分水平线和垂直线。
课程进展到多层网络,引入隐藏层和 sigmoid 函数。这些概念应用于数字识别项目,书中解释了反向传播和误差修正的机制。
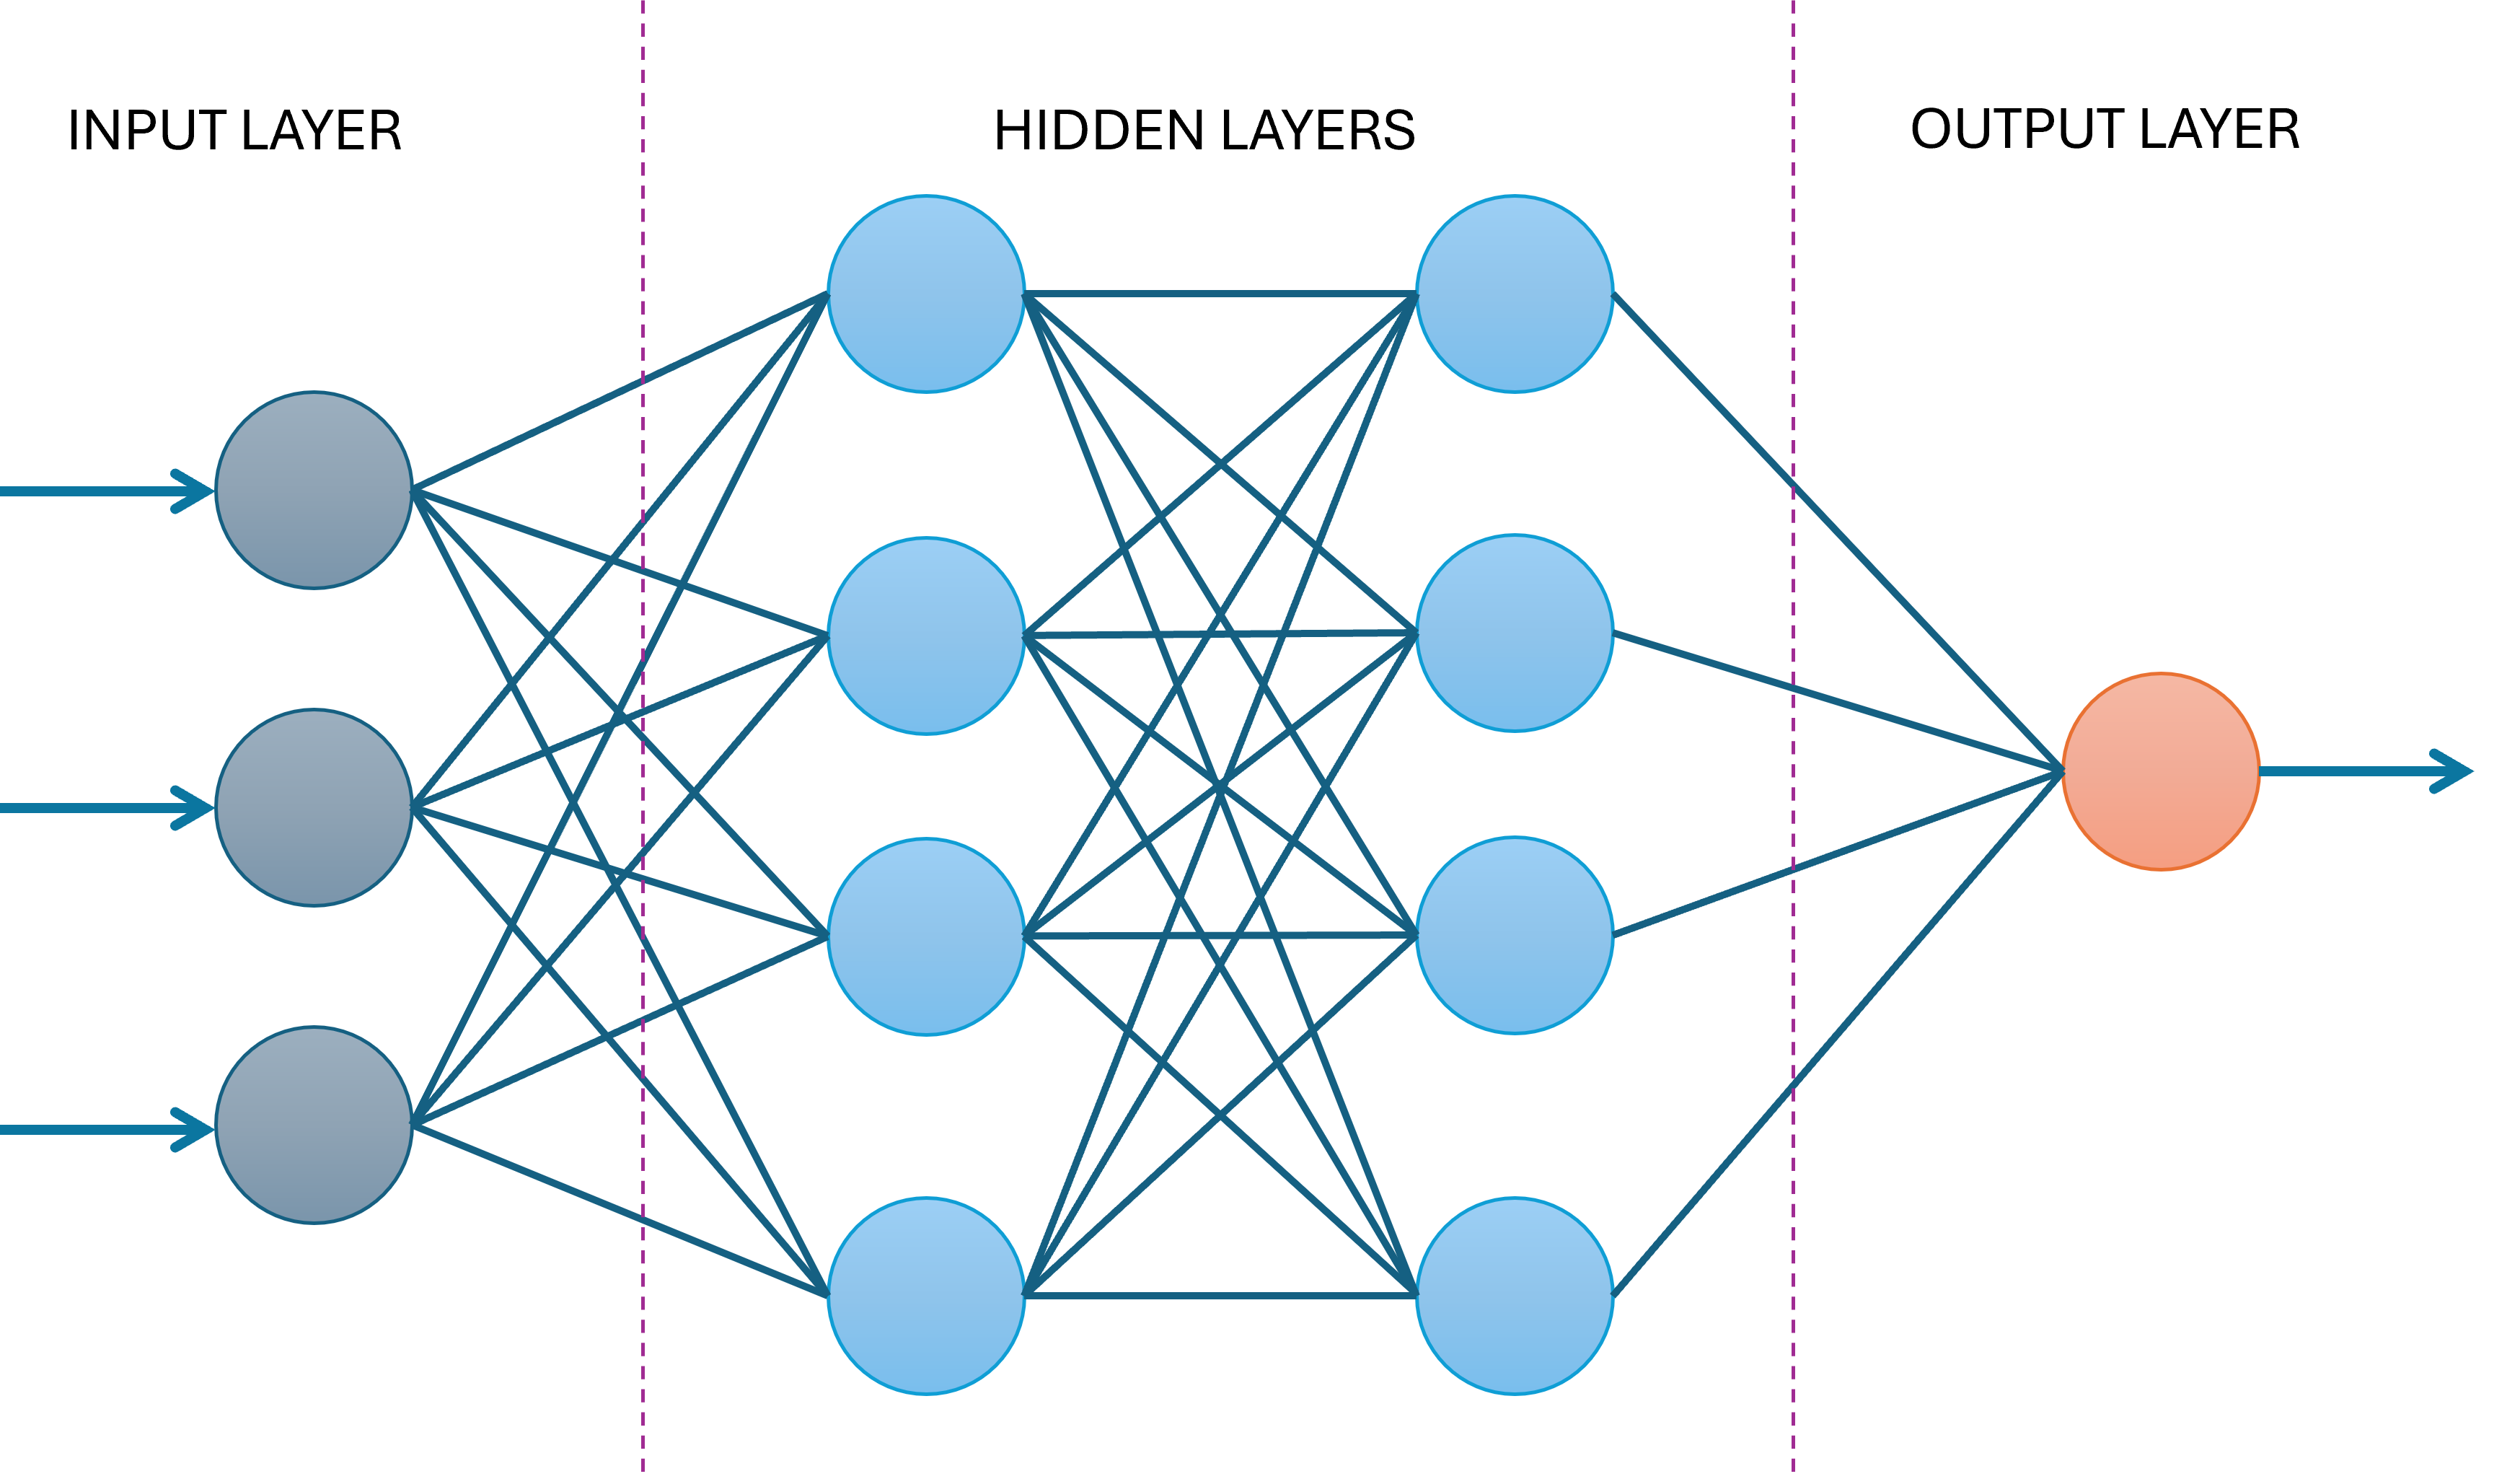
此图表解释了多层网络的机制以及信息通过隐藏层的流动。
由于 Z80 内存和速度有限,这些实现成为了理解权重如何调整以及在受限环境中如何发生泛化的实践实验室。
算法效率与限制
本书的一个核心主题是“与复杂性的战斗”。它利用 Z80 的局限性使算法复杂度变得可见,比较冒泡排序、希尔排序和快速排序的执行时间。
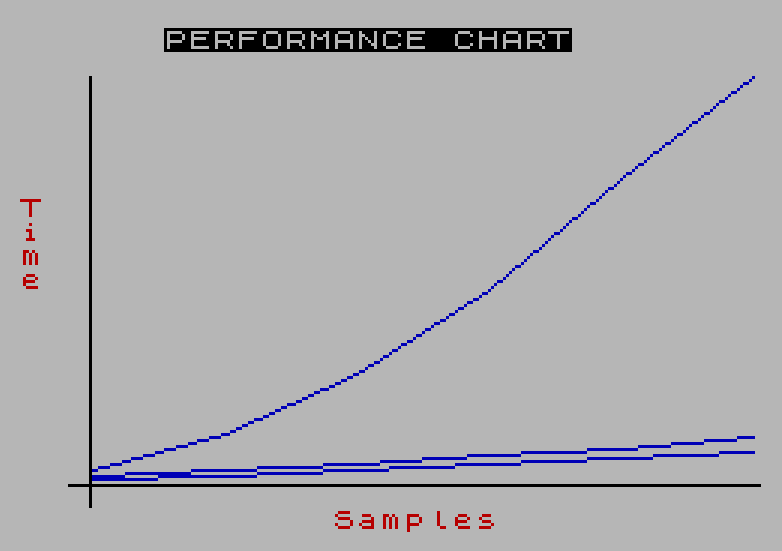
本书使用这些比较来证明算法效率如何胜过原始硬件速度。
这些比较旨在表明,增加时钟速度并不是选择高效算法的替代品。这为读者随后在书中构建并优化人工智能模型做好准备。
最后一个项目,康威的生命游戏,作为涌现复杂性的研究。它展示了简单的局部规则如何在不需要显式训练或海量数据集的情况下产生复杂的行为。
实践限制与范围
虽然本书深入探讨了人工智能基础,但它有意受到 8 位架构的限制。源材料未提供神经网络的具体性能基准或执行时间,仅指出这些数据在文中进行了测量和绘制。
重点仍然是“计算科学”而非高性能生产。目标是提供一份指南,重新发现从零开始构建人工智能的乐趣,在那里每一个字节都至关重要,每一个决策都意义重大。
Hacker News 读者的反应
- 替代方案: 一位评论者建议标题可能具有误导性,认为该项目对 BASIC 的关注使其适用于任何类似的方言,而非特定于 Z80 处理器。 评论 ↗
- 亲身经验: 另一位读者分享了他们多年前在 TI-83 计算器上进行类似练习的经历,指出他们将这些程序视为数学和计算机科学课程的自然结论,而非“人工智能”。 评论 ↗
- 质疑: 一位评论者对营销文案表示怀疑,暗示亚马逊上的描述似乎是 AI 生成的。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗