分布式系统经常难以维持一致的“先于发生”关系,因为每台主机的墙钟并不足够单调,无法可靠地对事件进行排序。Tsoracle 通过充当时间戳预言机(TSO)来解决这一问题,该服务向多个机器分发严格递增的整数 ID 以同步事件,这是 Spanner 和 CockroachDB 等大型数据库所采用的机制。
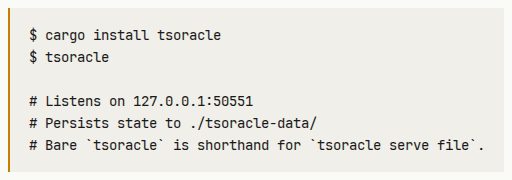
这段代码片段提供了在 Rust 应用程序中使用该库的具体示例,正如引言中所描述的那样。
排序与连续性
虽然许多系统需要排序事件,但某些特定用例——如发票号码、账本行或代理键——需要连续且无缝的序列,其中不能跳过任何数字。Tsoracle 通过提供用于排序时间戳的 `get_ts()` 和用于密集、无缝运行的 `get_seq()` 来区分这些需求。
时间戳只需要严格大于前一个值,这意味着可以跳过某些值。相比之下,序列必须是连续的(例如,..., 41, 42, 43, ...)。Tsoracle 通过每个命名键的持久化计数器来管理这些,确保即使在系统崩溃或故障转移期间,也不会重复或跳过任何 ID。
共识与批量分配
为了保持高可用性和容错能力,Tsoracle 使用共识层来复制其状态。系统的设计是:领导者推进高水位线,将该更改 fsync 到磁盘,并通过共识协议(如 Raft)进行复制,然后才将该范围释放给客户端。
为了优化性能,系统以大小为 N 的批量分配 ID。客户端接收到一组 ID 并在本地分发,这使得在普通硬件上每秒可处理数百万个 ID,同时最大限度地减少与预言机的网络往返次数。
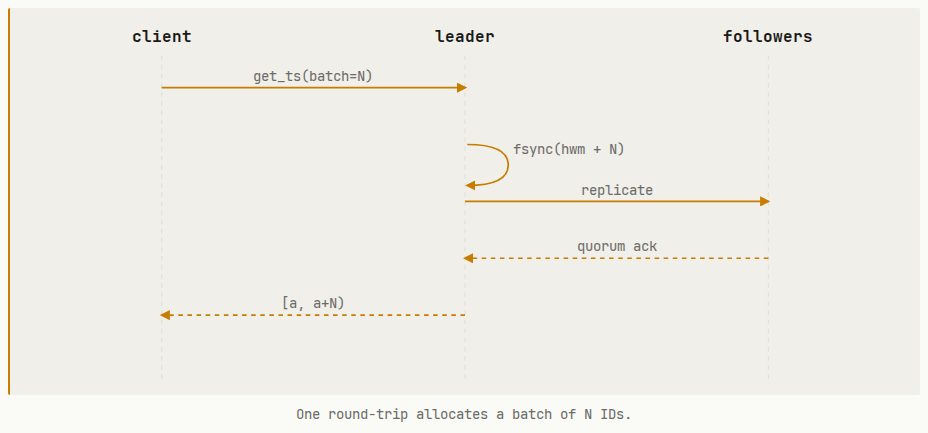
此图说明了文中描述的批量分配机制,展示了系统如何最大限度地减少网络往返次数。
幂等性与故障处理
无缝序列的要求引入了关于幂等性的特定技术权衡。由于无缝递增无法被“撤销”,请求过程中模糊的网络故障会导致无法确定计数器是否已成功推进。
Tsoracle 通过抛出 `SeqUncertain` 错误而非静默重试请求来处理此问题。这迫使调用者去协调状态,防止在必须保持完美连续的序列中意外创建“空隙”。