如果没有明确的位置信息,自注意力机制会将“红狐狸跳过灰狐狸”和“灰狐狸跳过红狐狸”这两句话视为相同,因为无论“狐狸”这个词处于什么位置,它都会获得相同的嵌入向量。为了解决这个问题,像GPT-2和MiniMax-M3这样的模型将特定位置的数据注入到Token向量中,从而允许Transformer理解输入的结构化序列。
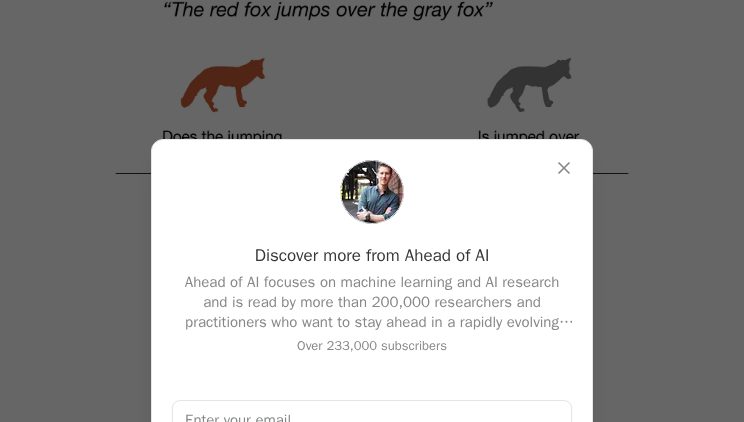
此视觉效果通过展示相同的单词如何根据其序列改变含义,解释了对位置数据的根本需求。
绝对位置嵌入的机制
在GPT-2架构中,位置信息作为独立的向量添加到Token嵌入中。模型在训练过程中学习一个位置向量表,对于位于位置m的每个Token,都会选择一个向量P_m并与该Token的嵌入向量进行逐元素相加。
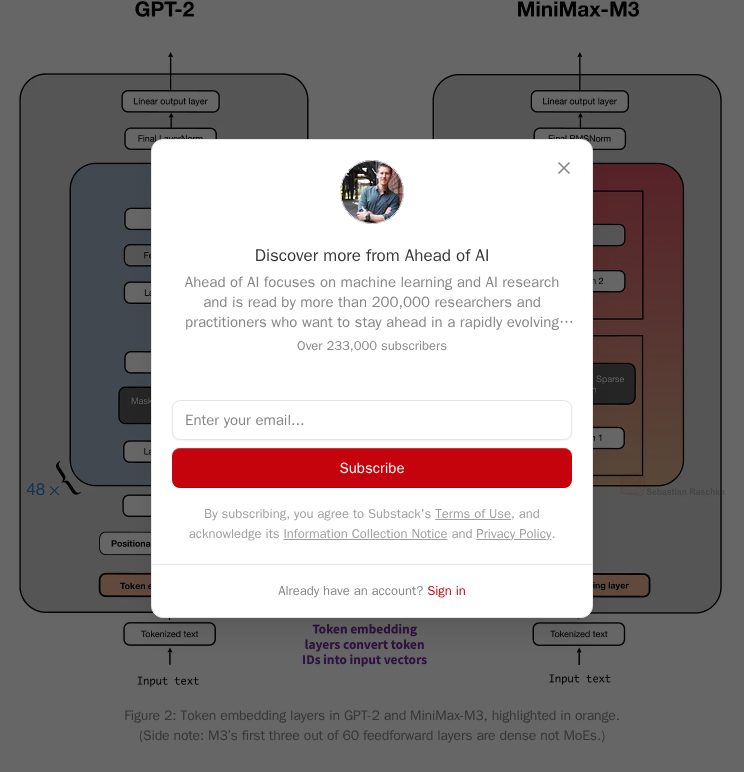
此图展示了不同模型类型中位置嵌入的具体架构位置。
这种方法确保了即使两个Token完全相同(例如单词“狐狸”出现两次),它们进入Transformer块时也会具有不同的数值表示。然而,这种方法受限于预定义嵌入表的大小,该表必须在训练开始前建立。
“尽管如此,GPT-2和大多数较新的大语言模型仍包含显式的位置信息,因为它为注意力机制提供了关于位置的直接信号。”
— Understanding Positional Embeddings in Modern LLMs
扩展限制与向相对方法的转变
绝对位置嵌入的一个显著权衡是扩展上下文窗口的成本。对于GPT-2 Medium,在1,024个Token的限制下,位置嵌入层仅占权重的0.30%;然而,将相同的上下文扩展到100,000个Token,这一比例将增加到模型总权重的22%以上。
HN Digest 根据 magazine.sebastianraschka.com 报告的数字绘制的图表;数值按原文显示。
为了规避这一问题,许多现代模型已转向相对位置嵌入,例如旋转位置嵌入(RoPE)。与绝对方法不同,RoPE直接将位置信息注入到注意力机制中,从而能够更高效地处理长程依赖,而不会增加模型的权重计数。
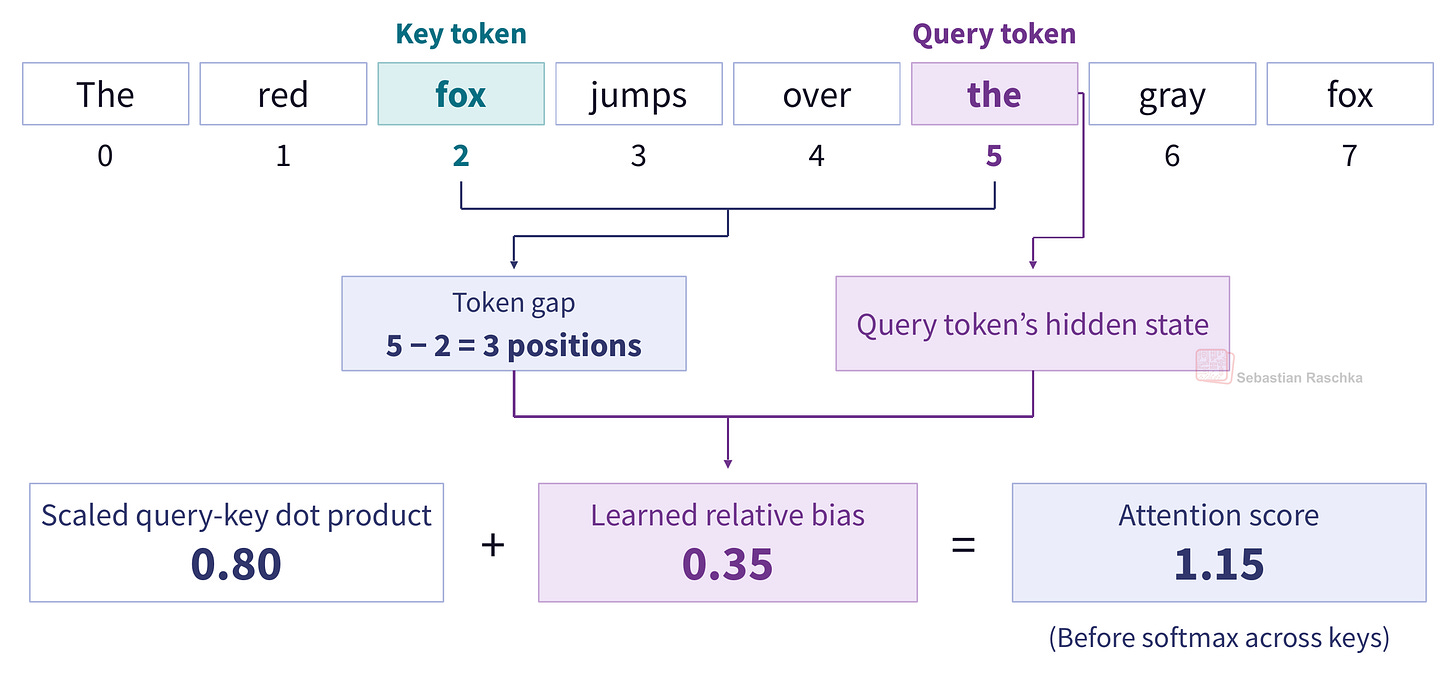
这张图片支持了关于RoPE等相对方法如何在注意力机制中运作的解释。
隐式顺序与显式信号
自回归模型中的因果掩码通过限制当前Token可以关注哪些之前的Token,提供了一定程度的隐式顺序。理论上,这允许模型即使在没有显式嵌入的情况下也能区分单词顺序。
尽管如此,显式位置方法仍然至关重要,因为因果掩码无法提供距离感。显式嵌入提供了一个直接信号,帮助模型区分Token的紧邻邻居与相隔十个位置的Token,这种区别对于生成连贯的文本至关重要。