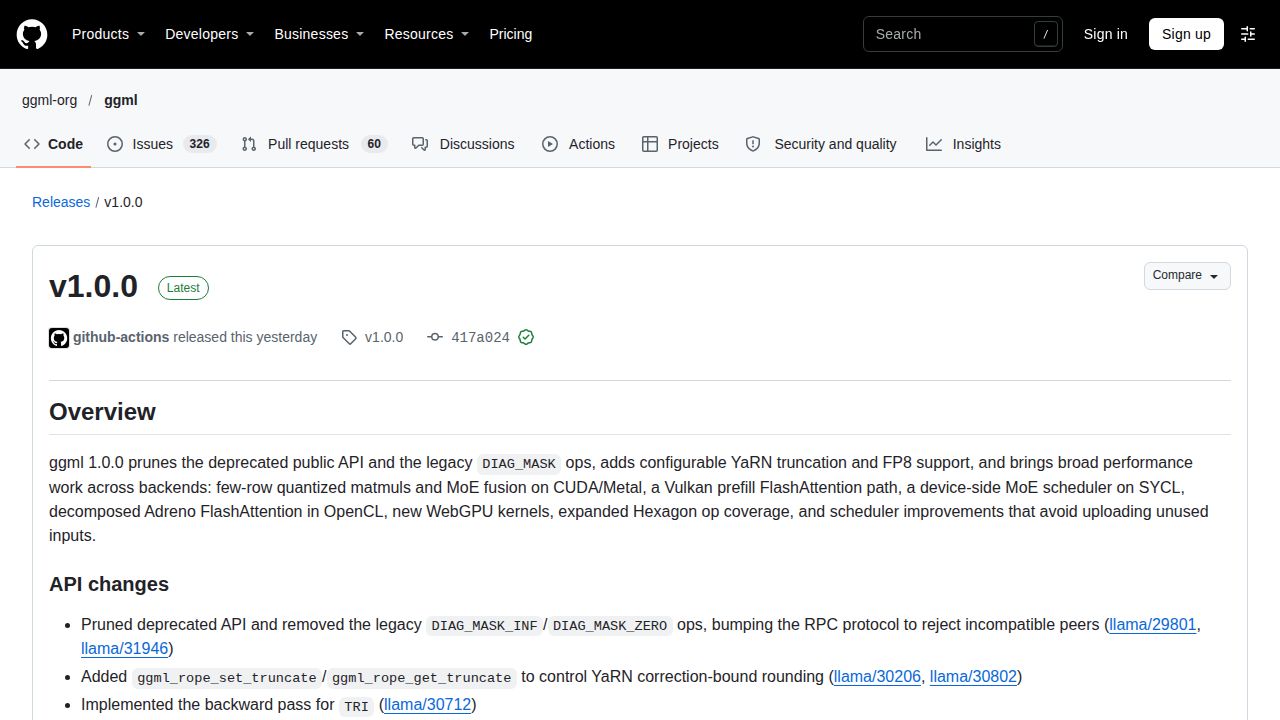
GGML 1.0.0 版本的发布标志着一个旨在促进高性能本地机器学习推理的 C 语言库的重要里程碑。该库由 Georgi Gerganov 开发(其名字的首字母构成了项目名称中的“GG”),它作为 llama.cpp 等工具的基础层,使用户能够在从旧系统到现代架构的各种硬件上运行大型语言模型。
GGML 项目与 1.0.0 版本
主要来源,即 GitHub 发布,宣布了 GGML 的官方 1.0.0 版本。该项目是一个专注于“一次一比特”驱动本地推理的机器学习 C 语言库。
作为 llama.cpp 生态系统的核心组件,GGML 被设计为在几乎任何硬件上运行模型的“一站式商店”。这使其成为那些优先考虑本地执行而非基于云的 API 的开发者和爱好者的关键工具。
社区反馈与性能
Hacker News 上的评论者强调了该项目提供持续性能改进的能力。一位用户报告在处理 50K token 的提示词时,运行时间从 4:22 减少到 3:59,并指出频繁的更新通常会带来 5% 到 10% 的速度提升。
讨论还强调了该库对于拥有非标准硬件的用户的易用性。例如,一位评论者指出,GGML 和 llama.cpp 使在仅支持 Vulkan API 的 AMD 卡上运行模型成为可能。
硬件兼容性与权衡
GGML 的核心优势之一是其广泛的硬件支持,包括旧系统和 RISC-V 架构。这种通用性使其能够作为不同计算环境之间的桥梁。
然而,一些用户指出了关于原始速度的权衡。虽然 GGML 因其可靠性和易用性而受到赞誉,但具有针对特定硬件优化的内核的专用推理引擎在峰值执行速度方面可能仍然优于它。
讨论总结
Hacker News 的讨论集中在项目的工程成就上。评论者将其描述为“真正的工程产品”,并将其在 AI 世界中的角色比作 Linux。
虽然社区很大程度上赞扬了该项目的实用性,但一些用户建议该项目的着陆页可以采用更专业的设计,以匹配底层软件的高质量。