传统的数据请求“接力”——即营销主管的问题经过分析师和工程师的处理,最后以仪表盘的形式返回——正受到能够执行 SQL 并解释业务逻辑的多轮 AI 智能体的冲击。MotherDuck 提议设立一个新的角色:数据智能工程师(Data Intelligence Engineer),通过专注于组织上下文的策划和自动化系统的监督来管理这一转变。
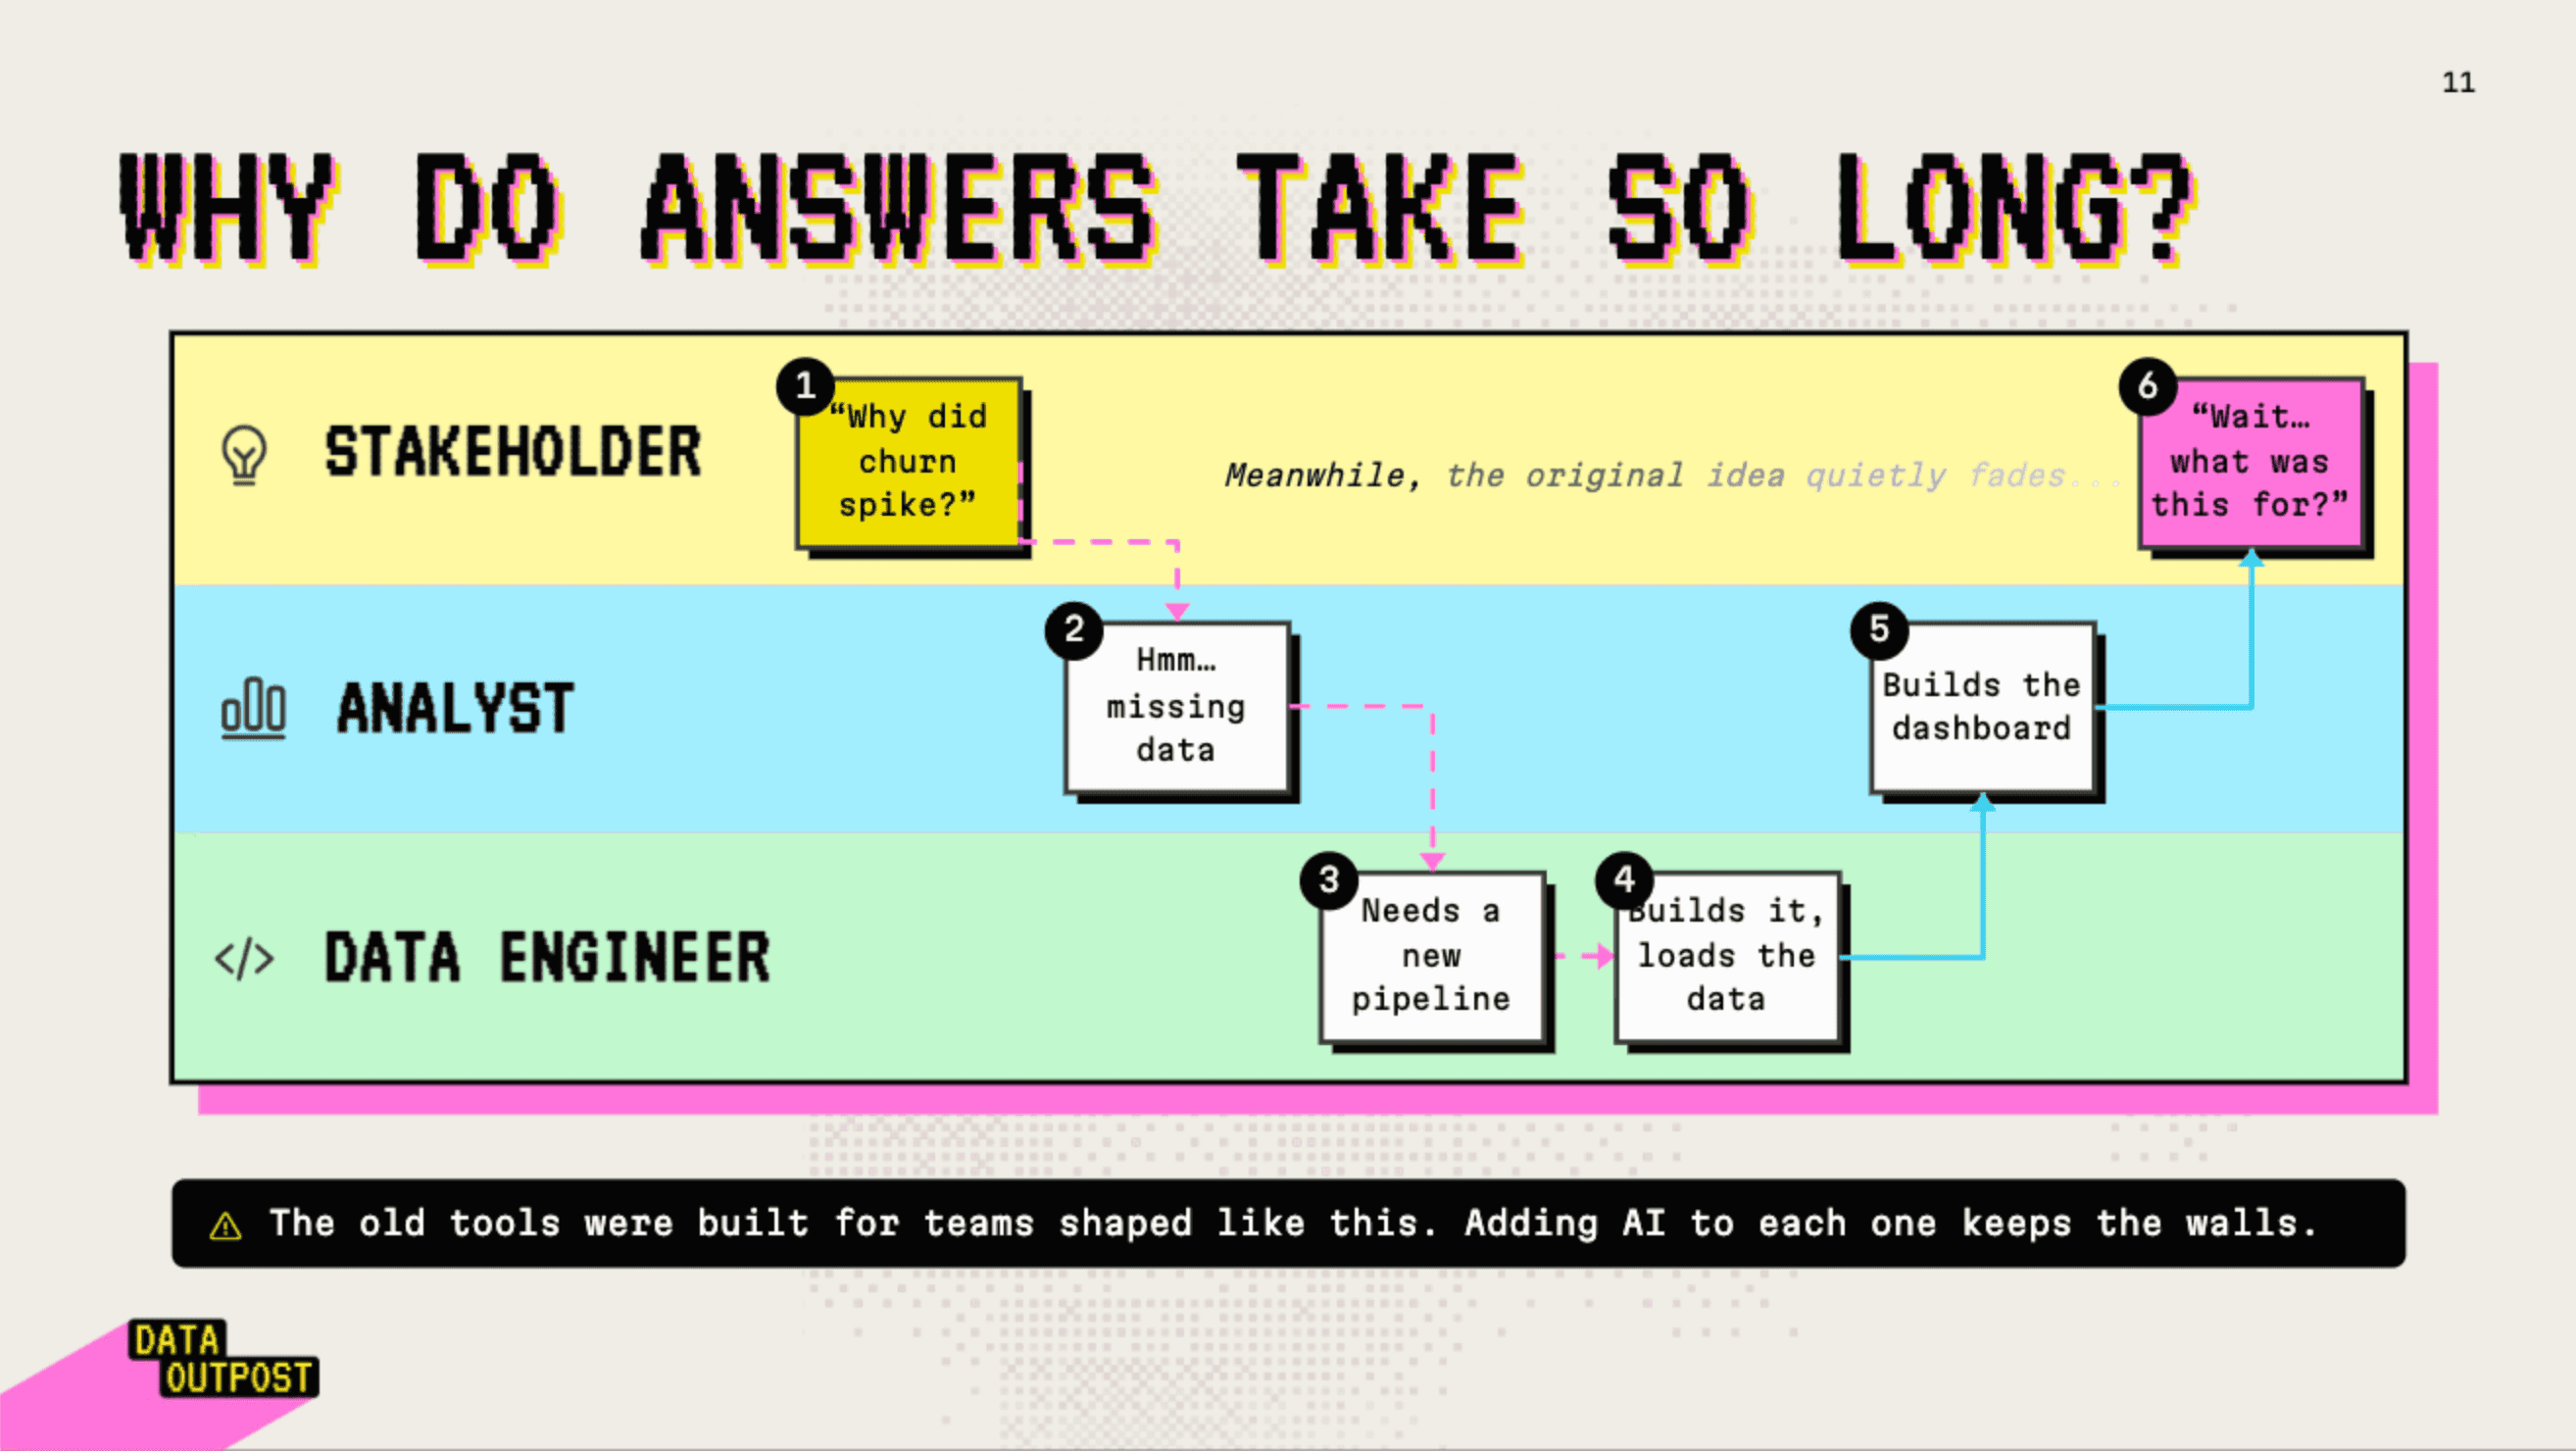
这张图片展示了开头段落中描述的传统数据请求“接力”。
从手动流水线到 AI 智能体的转变
此前,数据团队面临着严重的瓶颈:分析师与工程师之间的每一次交接都会导致上下文丢失,并降低快速行动的能力。虽然早期的“副驾驶”工具提供了一定的速度提升,但它们并未消除对这些手动交接的需求。
大型语言模型(LLM)最近的进展改变了格局,使智能体能够执行多轮推理。这些智能体现在可以尝试执行查询、分析结果并迭代逻辑,这使得构建仪表盘或 dbt 流水线等任务对于业务利益相关者来说变得“可提示化”。
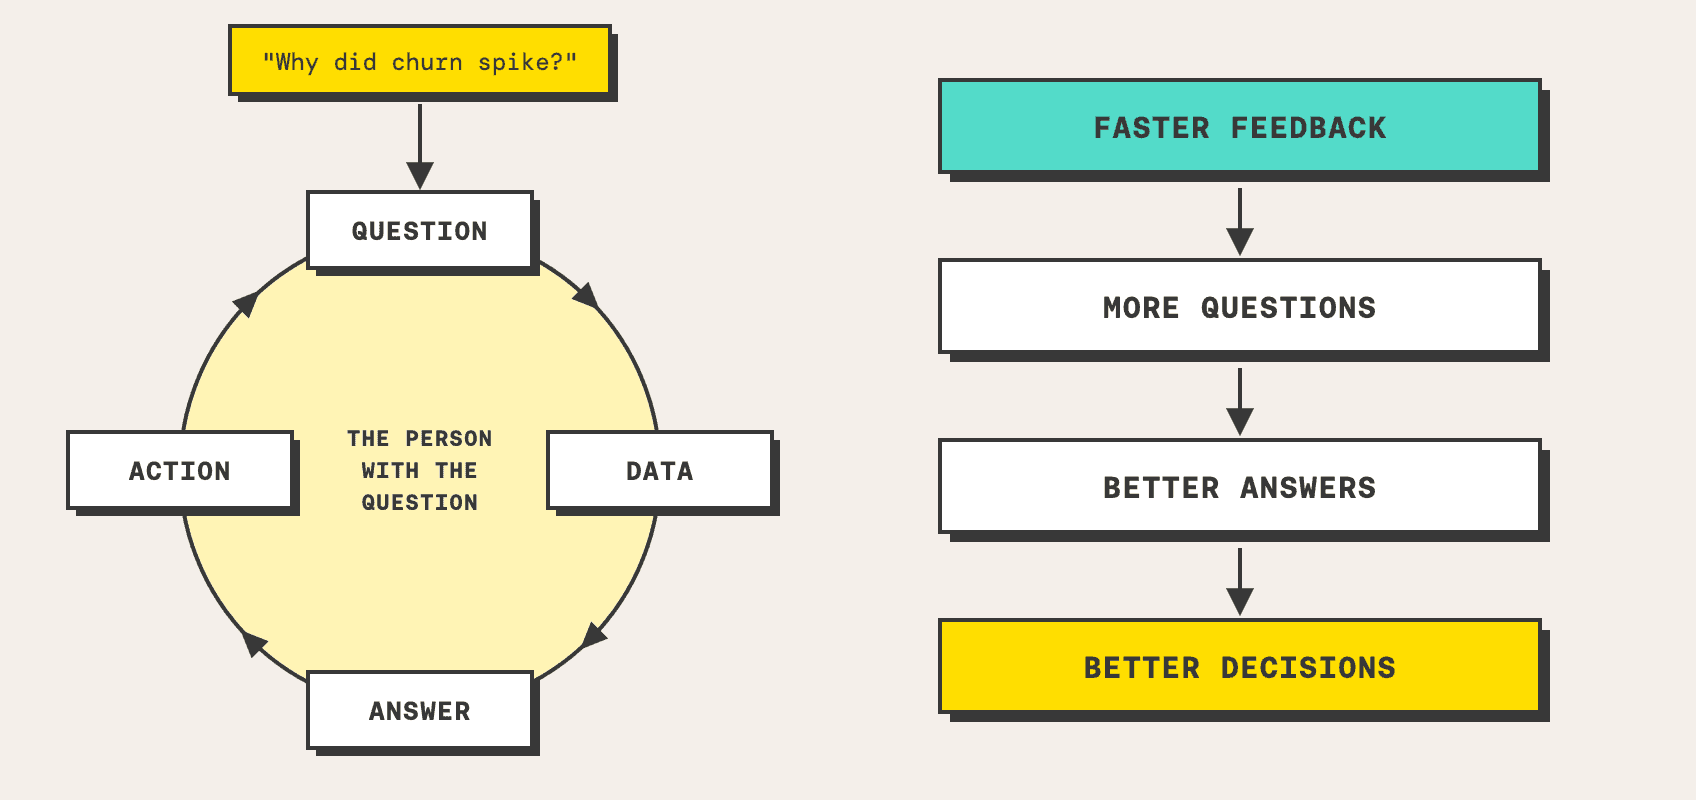
此视觉效果支持关于 LLM 如何执行多轮推理以迭代逻辑的讨论。
“无论工具是什么或由谁操作,数据工程都是一个问责职能。”
— The dawn of the Data Intelligence Engineer | MotherDuck
定义数据智能工程师
数据智能工程师被定义为一个通过构建软件智能体来自动化传统数据工程师和分析工程师工作的角色。这些工程师不再手动构建每一个流水线,而是将系统知识编码到共享上下文中,例如定义“ARR”的含义,或确定哪个特定表格包含正确的收入数据。
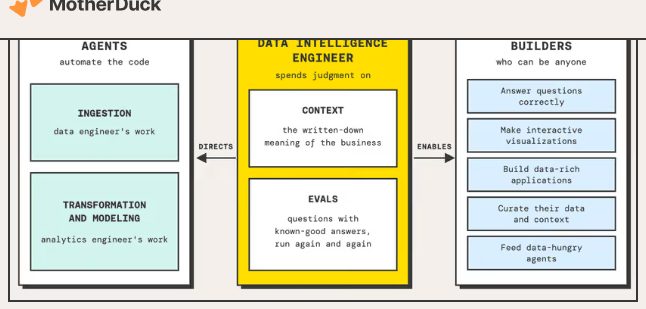
这张图片提供了文中描述的数据智能工程师角色的视觉定义。
该角色的核心职责之一是创建“评估”(evals)——即用于验证智能体是否能对已知问题提供正确答案的系统测试。这些评估作为一种置信机制,并作为检测底层数据或逻辑断裂的方法。
问责制与比例监督
尽管 SQL 和仪表盘的创建已实现自动化,但人类在问责方面仍然是必要的。模型可以理解 SQL,但它本身无法了解公司的特定内部定义,或者在没有整洁数据模型的情况下区分外观相似的表格。
为了管理 AI 生成错误带来的风险,该框架提出了三个监督圈。 “野外”(Wild West)允许不受监督的实验,“策划”(Curated)集包含重要但非关键的仪表盘,“核心”(Core)包含需要数据团队最高级别警惕的高风险指标。
Hacker News 读者的反应
- 替代方案: 一位评论者对数据职位极度的碎片化表示沮丧,认为不同角色的狭隘聚焦使得完成项目变得困难,并主张培养更多“T型”数据专业人才。 评论 ↗
- 质疑: 另一位用户分享了对计算机工作快速自动化的批判性观点,认为目前许多从笔记本电脑上执行的角色可能会在极短的时间内面临重大冲击。 评论 ↗
- 质疑: 一位评论者提出了关于自动化局限性的问题,认为人类社会和经济是由人类因素塑造的,这些因素可能无法轻易被以效率为导向的 AI 所取代。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗